Wiki 知识库

全部文档 / 标签: 显存带宽

3 篇
清除

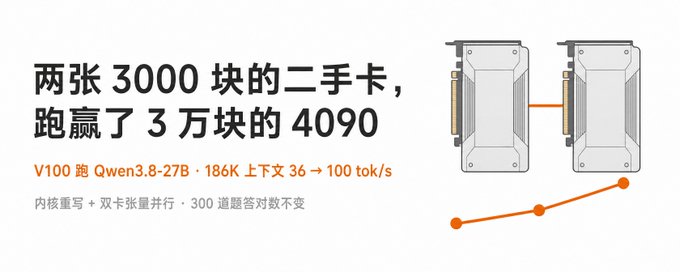
万字爆肝长文丨两张 3000 块老卡跑赢 3 万块 4090 48G:一次讲透怎么老显卡把 Qwen3.8-27B /NInfer跑到极致

作者详细记录了用两张二手 V100(各 3000 元)运行 Qwen3.8-27B 大模型的完整优化过程。V100 是 2017 年的数据中心显卡,HBM 显存带宽实测达 1004GB/s,甚至高于 4090。文章先建立测试口径与性能分析框架(读权重与读 KV 缓存两笔账),逐步排查瓶颈:验证带宽不是问题、测试双卡张量并行、分析 PCIe 延迟与 NCCL 版本坑,最终通过重写推理引擎内核、添加双卡支持,将长上下文生成速度从 36 tok/s 提升到 100 tok/s 以上,代码生成速度超过 3 万元的 4090 48G,并成功上线生产环境。文中深入浅出讲解了推测解码、CUDA Graph、内核优化等技术细节。

技术 › LLM huangserva 2026-10-0489.4 KB 141.5K 319 89

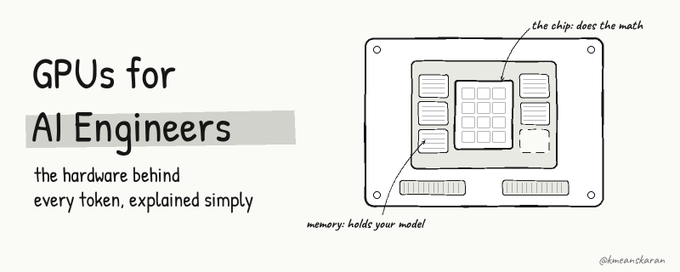
AI 工程师需要了解的 GPU 全部知识

本文面向 AI 工程师系统讲解 GPU 硬件知识:GPU 的三种类型(数据中心、工作站、个人级),内部结构(SM、Tensor Core、CUDA 核心、HBM 显存与 SRAM 缓存),并以 gpt-oss-120b 和 Kimi K3 两个开源 MoE 模型为例,用精确的数学计算说明推理的算力与显存带宽瓶颈、prefill 与 decode 的差异,以及训练与推理对 GPU 使用的不同需求,帮助工程师做出租用 GPU、模型部署等实际决策。

技术 › LLM Karan 2026-10-0219.3 KB 55.1K 427 82

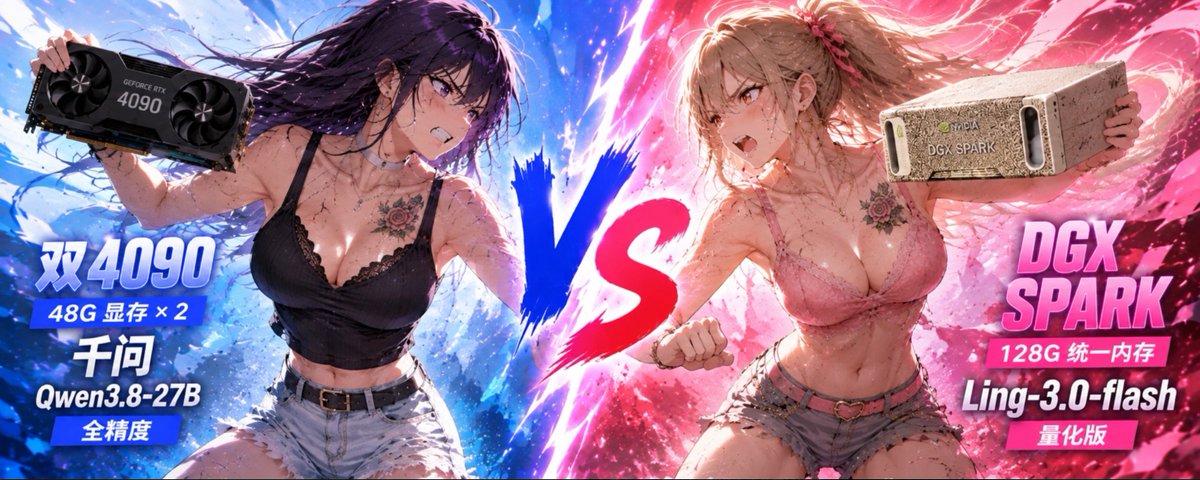
最强的矛与盾:本地部署大模型到底该买什么

本文对比 NVIDIA DGX Spark 与双 48G 魔改 RTX 4090 两台偏科硬件,测试 Qwen3.8-27B(Dense)与 Ling-3.0-flash(稀疏 MoE)四个组合的推理表现。作者详细讲解 Dense/MoE 区别、显存带宽与算力的关系、投机解码与 MTP 原理,并给出单会话速度、并发吞吐的实测数据。结论是 Spark 适合跑 MoE 或量化模型,双 4090 借助高带宽速度更快,Ling 在并发服务上吞吐约为 Qwen 的 2.4 倍,并给出选购建议。

技术 › LLM 实践哥MinLi 2026-08-1830.4 KB 298.1K 264 89