Wiki 知识库

全部文档 / 标签: MTP

2 篇
清除

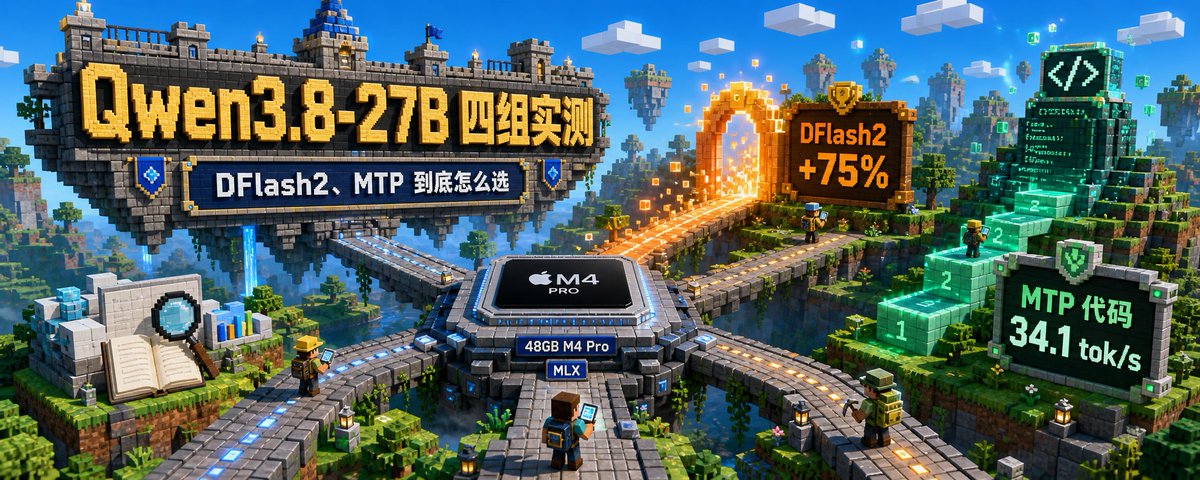
同一台 M4 Pro 实测四组 Qwen3.8-27B:DFlash2、MTP 到底怎么选

作者在 48GB M4 Pro MacBook 上对比了 Qwen3.8-27B 的四组运行配置:官方 4-bit、Uncensored 版、官方 4-bit + DFlash2 草稿模型,以及 oQ4e + MTP。结果显示 DFlash2 平均提速 75%(约 26.96 token/s),数学与 GSM8K 场景超过两倍;oQ4e + MTP 在长文与代码负载下分别达 24.9 和 34.1 token/s,代码吞吐最高但部署复杂、首 token 延迟明显。结论是日常优先官方 4-bit + DFlash2,代码和长输出用 MTP,Uncensored 仅限隔离环境研究使用。

技术 › LLM 雪瑜 2026-08-248.2 KB 9.1K 57 82

最强的矛与盾:本地部署大模型到底该买什么

本文对比 NVIDIA DGX Spark 与双 48G 魔改 RTX 4090 两台偏科硬件,测试 Qwen3.8-27B(Dense)与 Ling-3.0-flash(稀疏 MoE)四个组合的推理表现。作者详细讲解 Dense/MoE 区别、显存带宽与算力的关系、投机解码与 MTP 原理,并给出单会话速度、并发吞吐的实测数据。结论是 Spark 适合跑 MoE 或量化模型,双 4090 借助高带宽速度更快,Ling 在并发服务上吞吐约为 Qwen 的 2.4 倍,并给出选购建议。

技术 › LLM 实践哥MinLi 2026-08-1830.4 KB 298.1K 264 89
