Wiki 知识库

全部文档 / 标签: 模型发布

5 篇
清除

BestBlogs 早报|Kimi K3.1 Pro 发布,Claude Duet 的安全、隐私与保障机制,天猫数字员工实践篇拆解

本期早报聚焦 AI 智能体的长程执行与工程实践。精讲一介绍月之暗面 Kimi K3.1 Pro,3 万亿参数、100 万上下文,在代码、3D 创作、金融研究和长程 Agent 任务上表现突出,尤其展示了模型修正仿真器错误完成人体行走控制的能力。精讲二解读 Claude Duet 的安全机制,包括动作审批、敏感信息检查与凭证隔离三层设计。精讲三拆解天猫数字员工的全链路交付技术,涵盖沙箱隔离、会话延续、身份绑定与度量体系。速览部分还涵盖美团 AutoResearch 自进化系统、Cloudflare CTO 谈智能体安全、LangChain 上下文工程检索实践及 Factory 自主软件工程等内容。

技术 › LLM ginobefun 2026-10-2428.5 KB 2.9K 4 83

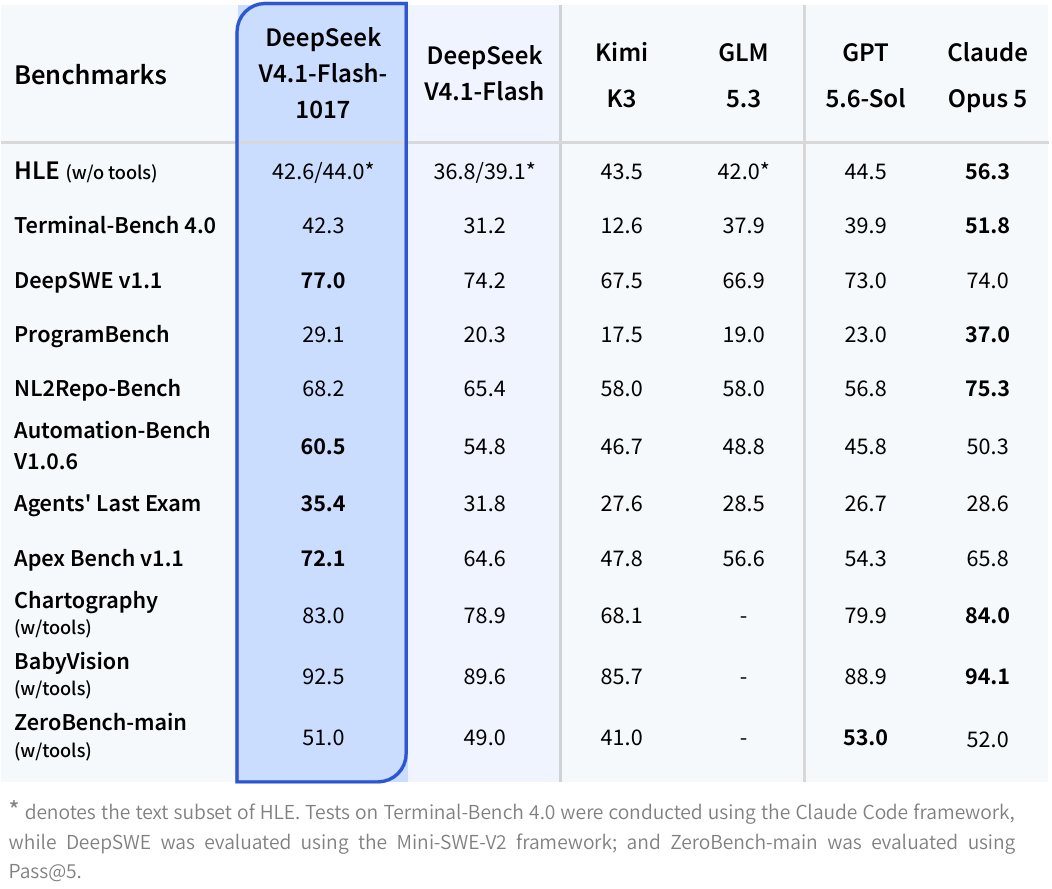
DeepSeek-V4.1-Flash-1017 发布

DeepSeek 发布 V4.1-Flash-1017 模型,性能更强、任务完成更快、输出更短,实现性能与成本的帕累托改进,已在官网、App 和 API 上线。模型通过强化学习自反馈优化端到端项目开发能力,覆盖游戏创建到 3D 建模等完整项目构建,并针对 DeepSeek Harness、腾讯 CodeBuddy、WorkBuddy 等工具优化。同时 Search & Fetch API 面向所有人开放,基于自研搜索引擎,每端点 $0.75/千次调用,已在 Hugging Face 和 ModelScope 开源。

技术 › LLM DeepSeek (@deepseek_ai) 2026-10-173.1 KB 79

Grok 4.7:不是能力跃迁,是一次定价进攻

文章分析 Grok 4.7 发布,认为其核心不是能力跃迁而是定价进攻:输出价格仅为 GPT-5.6 Sol 的 30%、Fable 5.1 的 12%。在 CursorBench 4.0 上,Grok 4.7 Extra High 得分 46.3%,接近 Opus 5 Max 的 46.6%,但成本仅一半。相比 Grok 4.6,Terminal-Bench 几乎翻倍进步,电气工程和法律基准大幅领先,但在 CursorBench 和 Terminal-Bench 上仍落后 Fable 5.1。技术改进包括更大基座、更长 RL 训练、更强的自我验证和 500K 上下文,并为 Grok Bot harness 做原生训练。作者指出,强模型低价化正在削弱「强模型规划、弱模型执行」的省钱架构逻辑。

技术 › LLM yibie 2026-09-227.4 KB 1.5K 1 83

Introducing Gemini 3.7 Flash

Google 推出 Gemini 3.7 Flash,这是其 Flash 系列中最智能的模型,专为编码和智能体设计。相比 3.6 Flash,它在软件工程、知识工作和网页开发方面有显著提升,例如在 FrontierCode 和 DeepSWE 基准上得分更高,并在 WebDev Arena 中 Elo 分数更高。该模型还改进了对复杂文档的处理和真实业务流程的完成能力。开发者体验得到改善,且以半价推出(每百万输入 token 0.75 美元,输出 3.75 美元)。Gemini Spark 也将采用此模型。安全方面,更新了 CBRN 和网络攻击的防护措施。

技术 › LLM Google AI Studio 2026-08-1410.6 KB 116.8K 1.8K 81

美团开源 LongCat-Video-Avatar 1.5 音频驱动虚拟人模型

美团开源了名为 LongCat-Video-Avatar 1.5 的音频驱动虚拟人模型。该模型支持唇形精准匹配、表情自然过渡、全身动作连贯及唱歌表演,综合能力据称超越 HeyGen、Kling Avatar 等商业模型。适用于需要高质量视频生成、本地部署及复杂场景开发的内容创作者、企业和 AI 研究者。

技术 › AI Joruno 2026-05-251.6 KB 52