Wiki 知识库

全部文档 / 标签: 大语言模型

11 篇
清除

7大核心升级,我们终于等来了一个“写作强于代码”的顶级模型:Gemini 4 Argon 深度实测

Google 旗舰模型 Gemini 4 Argon 于 10 月 14 日全面开放。文章详细解析了其 7 大核心升级:百万级 token 输出上限(长解码模式)、Arena 文字榜断层第一的写作能力、强于竞品的空间几何代码生成(3D 古建筑群)、深度推理与仅 15% 的超低幻觉率、原生多模态与 4K 音画同步视频生成、直接交付成品文件(PDF/Excel)而非代码,以及面向备考的苏格拉底式学习模式。作者附上 API 定价对比与 10 段实测提示词,认为其写作能力已超越 Claude Opus 5.5 和 GPT-6 Astra,性价比突出。

技术 › LLM Eian 2026-10-1418.8 KB 67.2K 197 84

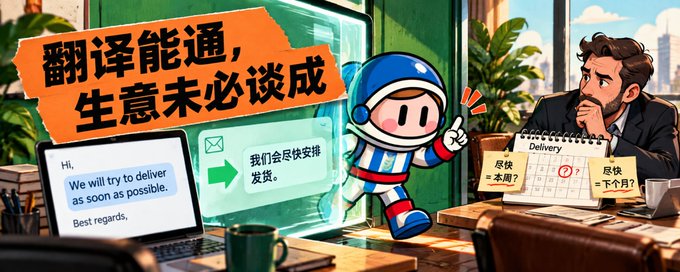
AI翻译越来越好,英语却更值钱了

文章通过外贸从业者林宇的案例,探讨AI翻译时代英语能力的真实价值。作者认为机器翻译降低了语言门槛,但商业沟通中真正稀缺的是理解语气、辨别信息源、判断承诺边界等判断力。文章分析了翻译工具无法替代的环节:追问模糊表达、核实原始资料、控制合同风险等,并指出语言工作者的价值正从'换词'转向'为业务控制错误'。作者建议将英语学习绑定具体业务场景,设定可检验的阶段性目标,用招聘需求和实际订单来评估学习投入,避免陷入培训消费陷阱。核心观点是:工具翻译的是句子,客户购买的是确定性。

技术 › LLM Stanley 2026-09-2922.3 KB 3.3K 83

保姆级讲解|从0到1带你了解最近爆火的Jev模型到底是什么?

文章介绍了TypeSafe AI推出的专用判断模型Jev及其背后的System One Models理念。与通用大语言模型逐token生成不同,Jev专注于答案范围明确的判断任务,提供Choice(选择)、Score(打分)、Noul(概率判断)三种能力,可并行输出多项判断及概率,大幅降低响应时间和调用成本。作者以电商评论处理为例演示了三个特性的用法,并指出Jev与大语言模型是互补关系:判断、分类、打分等环节交给Jev,复杂推理和内容生成仍由大模型承担。这种专用化思路对Agent系统(Harness)友好,有望开辟AI模型分工的新赛道。

技术 › LLM 金尘马 2026-09-2115.7 KB 137.4K 247 80

AI会不会成为人类历史上的“新物种”?

文章从人类进化史切入,借助赫拉利《人类简史》《智人之上》的观点,指出智人依靠语言构建想象共同体而胜出。作者认为AI与蒸汽机等以往技术革命截然不同,它进入语言、判断与决策领域,成为信息网络中的主动节点。文章提出两大反常识观点:AI无需意识即可深刻改变文明;真正的威胁不是失业,而是人类对复杂系统决策权的垄断逐渐外包。作者分析了AI在复制、永生、并行存在等方面突破生物边界的特征,并讨论人类与AI共存的三种路径,最终警示:改变历史走向的往往不是技术本身,而是谁拥有这项技术。

技术 › LLM 伟大 2026-09-0831.8 KB 9.2K 6 66

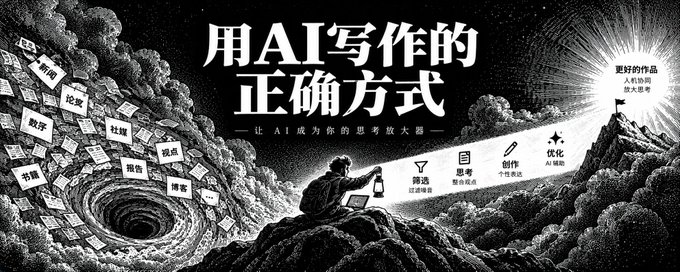
用 AI 写作的正确方式

文章转译自 Nicolas Cole 的《Write with AI》,探讨 AI 时代写作的所有权问题。作者提出语言是开源系统,无人拥有单个词汇或句子,AI 本质上是商品化内容机器,正在让泛泛的、可复制的商品化内容迅速贬值。真正的价值来自人格化内容:由人生事实、观点、洞察、故事和教训累积而成的私人细节,构成独一无二的'个人语言模型'和'数字大脑'。作者建议写作者应让 AI 承担重复性商品化内容的写作,把时间投入到人格化内容上,最终创造出真正原创的想法,从而在 AI 时代建立差异化杠杆。

技术 › LLM Yangyi / Nicolas Cole 2026-09-0835.0 KB 64K 221 72

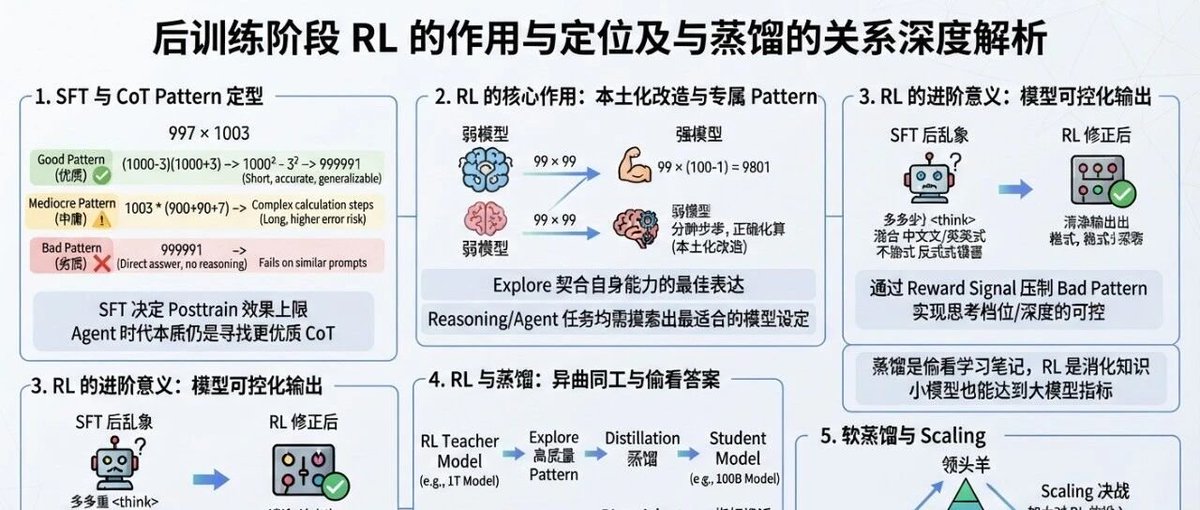
从 RL 到蒸馏,再到软蒸馏:Why RL Matters?

本文探讨了强化学习(RL)在大语言模型后训练阶段的作用,以及它与蒸馏(SFT)的关系。作者认为,SFT 阶段为模型提供了思维链(CoT)模式,而 RL 则帮助模型将这些模式“本土化”,找到最适合自身知识量和分词器的表达方式,并增强模型的可控性。同时,蒸馏(包括软蒸馏)可以高效地将强模型的能力迁移到弱模型,但过度依赖蒸馏会限制模型的进步。文章最后指出,领先团队应加大 RL 投入,而应用型团队则可优先选择蒸馏。

技术 › LLM ybq 2026-08-1611.6 KB 5.2K 43 73

Introducing Gemini 3.7 Flash

Google 推出 Gemini 3.7 Flash,这是其 Flash 系列中最智能的模型,专为编码和智能体设计。相比 3.6 Flash,它在软件工程、知识工作和网页开发方面有显著提升,例如在 FrontierCode 和 DeepSWE 基准上得分更高,并在 WebDev Arena 中 Elo 分数更高。该模型还改进了对复杂文档的处理和真实业务流程的完成能力。开发者体验得到改善,且以半价推出(每百万输入 token 0.75 美元,输出 3.75 美元)。Gemini Spark 也将采用此模型。安全方面,更新了 CBRN 和网络攻击的防护措施。

技术 › LLM Google AI Studio 2026-08-1410.6 KB 116.8K 1.8K 81

听完李飞飞两小时访谈,我重新理解了 AI 时代的“主体性”

本文基于对李飞飞两小时访谈的思考,探讨了AI时代人类“主体性”的重要性。作者指出,AI不仅能学习写作模式,还能帮助人们看见习惯和盲区,但关键在于如何使用:是直接获取答案,还是用它来拓展思考。文章强调,对孩子而言,AI可能剥夺他们与困难相处的机会,因此教育者需参与规则设计。同时,作者认为语言模型虽强,但世界不只由语言构成,空间智能提供了另一种理解方式。最后,作者提出三个问题,提醒人们在AI辅助下保持主动性和判断力,避免过早交出方向盘。

技术 › LLM Yanhua 2026-08-126.1 KB 15.1K 114 62

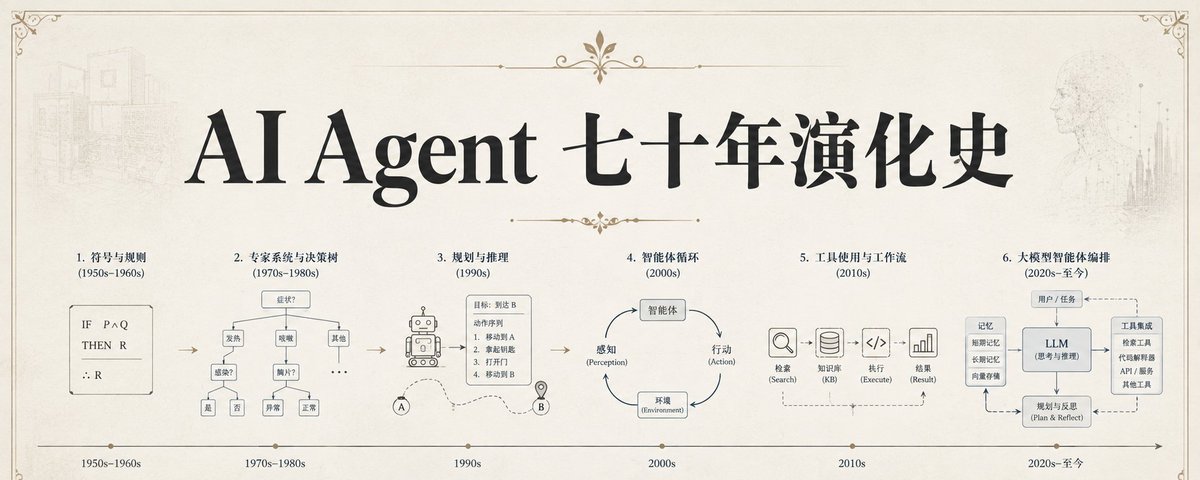
AI Agent 七十年演化史

本文系统梳理了AI Agent从1958年McCarthy的Advice Taker到2026年的七十年演化历程,指出其核心循环架构(感知-规划-行动-反思)自1972年Shakey机器人以来基本未变,真正变化的是循环中负责决策的“大脑”,经历了符号系统、专家系统、深度强化学习到大语言模型的更替。文章认为,大语言模型通过上下文学习和从文本中吸收常识,解决了前两代大脑“常识写不完”的致命缺陷,从而引爆了2023年的Agent浪潮。同时,文章提出关键观点:2023年的Agent技术栈大多是模型缺陷的补丁,随着模型能力增强,这些补丁将逐渐被拆除,最终通过训练直接获得能力。全文以METR时间视野曲线为衡量标尺,并埋下多条线索,在后续章节中逐一展开。

技术 › Agent snowboat 2026-08-1192.8 KB 31.7K 48 74

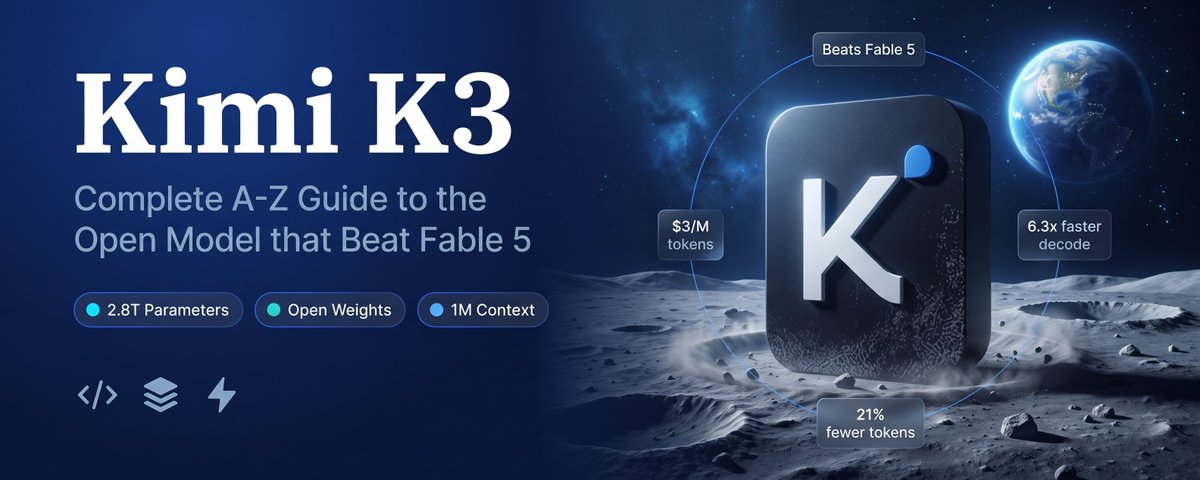
Kimi K3:超越 Fable 5 的开源模型完全指南

本文详细介绍了月之暗面发布的 Kimi K3 模型。该模型拥有 2.8 万亿参数和 100 万 token 上下文,性能超越 Claude Opus 4.8 和 GPT-5.6 Sol,对标 Fable 5。文章分析了其定价策略、架构创新以及模型自主优化架构的能力,展示了其在长程编码和 3D 前端开发方面的强大实力。

技术 › LLM Kirill 2026-07-2141.9 KB 1.3M 394

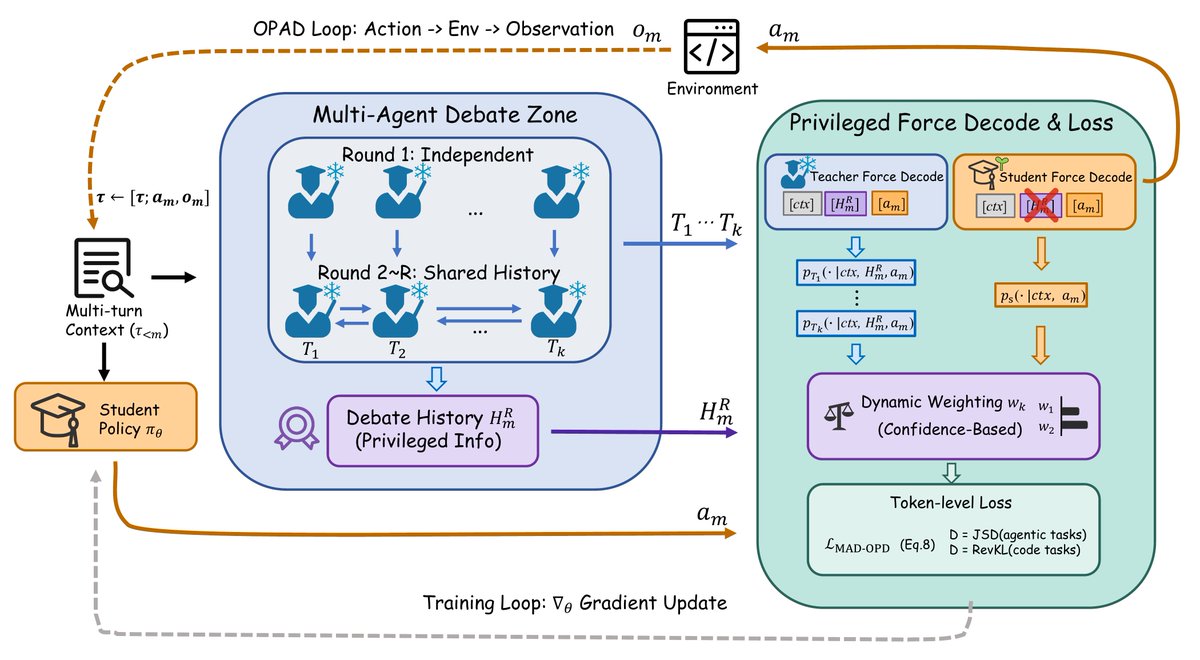
突破OPD天花板:MAD-OPD让小模型通过多教师辩论反超大模型

文章介绍了一种名为 MAD-OPD 的新算法,旨在解决 OPD(On-Policy Distillation)中单教师模型存在盲点导致学生模型学习受限的问题。通过引入多智能体辩论机制,让多个教师围绕学生状态互相纠错并达成共识,再进行蒸馏。实验表明,该方法在 14B+8B 到 4B 的蒸馏任务中,不仅提升了代码生成能力,还在 Agentic 任务中实现了小模型反超大教师的突破。

技术 › LLM 青稞社区 2026-07-136.6 KB 3.7K 22