Wiki 知识库

全部文档 / 标签: 编码Agent

9 篇
清除

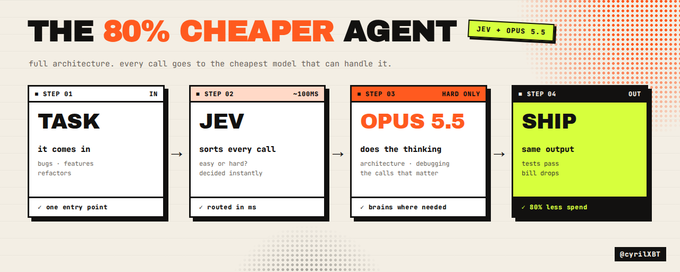
如何构建成本降低 80% 的编码 Agent:Jev + Opus 5.5 完整架构

文章指出当前编码 Agent 在简单决策(如选择加载哪些笔记、任务路由、工具失败处理、测试优先级)上滥用昂贵的前沿大模型,造成成本浪费。作者提出三层架构:Opus 5.5 负责规划、写代码、调试等开放性推理;Jev(TypeSafe 出品,毫秒级响应、输入 $0.042/百万 token、输出免费)负责从固定选项中做小决策并返回概率;Harness 层构建选项、校验概率阈值并在低置信度时回退到 Opus。文章给出四个具体决策点及代码实现:按标题分块并用 Jev 并行评分筛选相关笔记(将 30k token 降至 6k)、任务路由、工具失败处理、测试优先级选择。实测一个功能开发会话成本从 $6.42 降至 $2.00,降低 69%,且架构可作为函数调用插入现有 Agent 循环,无需重写。

技术 › Agent CyrilXBT 2026-10-2626.0 KB 515.7K 385 87

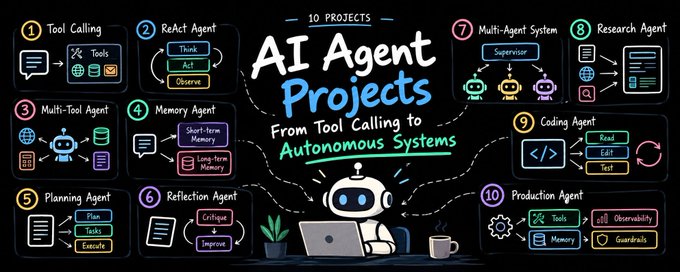
10 AI Agent Projects That Take You From Tool Calling to Autonomous Systems

文章介绍了10个循序渐进的 AI Agent 实战项目,帮助开发者从简单的工具调用进阶到自主智能体系统。项目包括:工具调用 Agent、ReAct 推理循环、多工具选择、记忆 Agent(短期与长期记忆)、规划 Agent(任务分解)、反思 Agent(自我评估与修订)、多 Agent 协作系统、研究 Agent、编码 Agent 等。文章通过架构图、技术栈(Python、OpenAI、LangGraph、Pydantic)和学习要点,阐述了智能体设计中的核心问题:工具选择、记忆管理、任务分解、错误恢复、自我验证及多 Agent 协调等。

技术 › Agent Jaydeep 2026-10-0512.7 KB 17.4K 254 73

Coding Agent Workflows for Software Engineering

本文介绍 Atomic 团队提出的编码 agent 工作流概念:将软件开发流程定义为可执行的显式路径,用 TypeScript 表达,包含输入与成功标准、有边界的阶段与工具、可检视的移交、相关检查、审查批准点、停止与恢复条件六大要素。文章对比了一次性提示与结构化工作流的适用场景,说明 agentic coding 与 agentic engineering 的区别,并介绍工作流如何在运行时物化为可检视的 DAG,以及功能交付、缺陷排查、迁移、发布准备等常见工作流形态,强调可验证性与人工控制的重要性。

技术 › Agent yibie 2026-10-028.4 KB 2.4K 30 68

DeepSeek Harness v0.2 桌面版发布

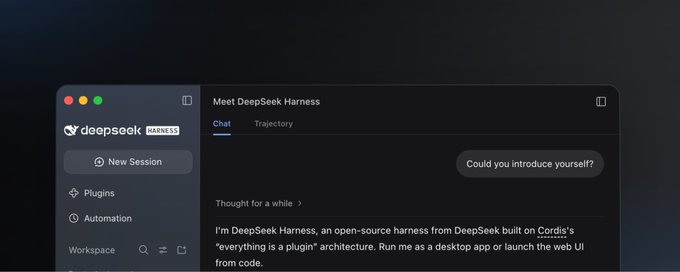
DeepSeek 发布 Harness v0.2 预览版,推出 macOS 和 Windows 桌面应用。新版本改进了文件显示、内容预览和代码变更展示,简化定时任务的设置与管理。核心亮点是插件系统:新增插件管理器,无需终端命令即可安装、禁用或卸载插件;实验性创作者模式允许用户用自然语言描述需求,自动创建插件。官方数据显示 Harness 是 DeepSeek API 用户中最广泛使用的编码 Agent。未来计划改进沙箱与安全、Agent 团队、长期记忆、浏览器自动化、远程访问,并建设官方插件市场,完善插件 API 兼容性。

技术 › Harness Engineering DeepSeek Harness 2026-10-017.2 KB 1.1M 5.9K 70

Grok 4.7:不是能力跃迁,是一次定价进攻

文章分析 Grok 4.7 发布,认为其核心不是能力跃迁而是定价进攻:输出价格仅为 GPT-5.6 Sol 的 30%、Fable 5.1 的 12%。在 CursorBench 4.0 上,Grok 4.7 Extra High 得分 46.3%,接近 Opus 5 Max 的 46.6%,但成本仅一半。相比 Grok 4.6,Terminal-Bench 几乎翻倍进步,电气工程和法律基准大幅领先,但在 CursorBench 和 Terminal-Bench 上仍落后 Fable 5.1。技术改进包括更大基座、更长 RL 训练、更强的自我验证和 500K 上下文,并为 Grok Bot harness 做原生训练。作者指出,强模型低价化正在削弱「强模型规划、弱模型执行」的省钱架构逻辑。

技术 › LLM yibie 2026-09-227.4 KB 1.5K 1 83

DeepSeek-V4.1-Flash on Fireworks: Astra-level DeepSWE at 1/15th the cost

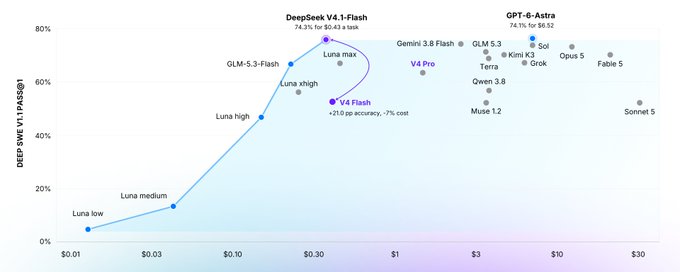
Fireworks 发布的 DeepSeek-V4.1-Flash 在 DeepSWE 基准测试中以每任务 $0.43 的成本达到 GPT-6 Astra 级别的编码准确率,价格仅为 1/15。该模型采用 552B MoE 编码器-解码器分离激活架构(输入 8B、输出 16B 活跃参数),配合 KV Cache 优化(HBM 占用降至 1/4),在 Terminal-Bench 2.1 上以 12x 更低成本逼近 Astra。但在 HLE 学术推理上落后于 Astra;oracle 路由测试显示两模型组合可超越 Astra 单模型表现,凸显多模型路由系统的价值。

技术 › LLM Fireworks 2026-09-169.1 KB 24.1K 200 75

One Terminal, Ten Agents: Herdr Orchestration (Skill)

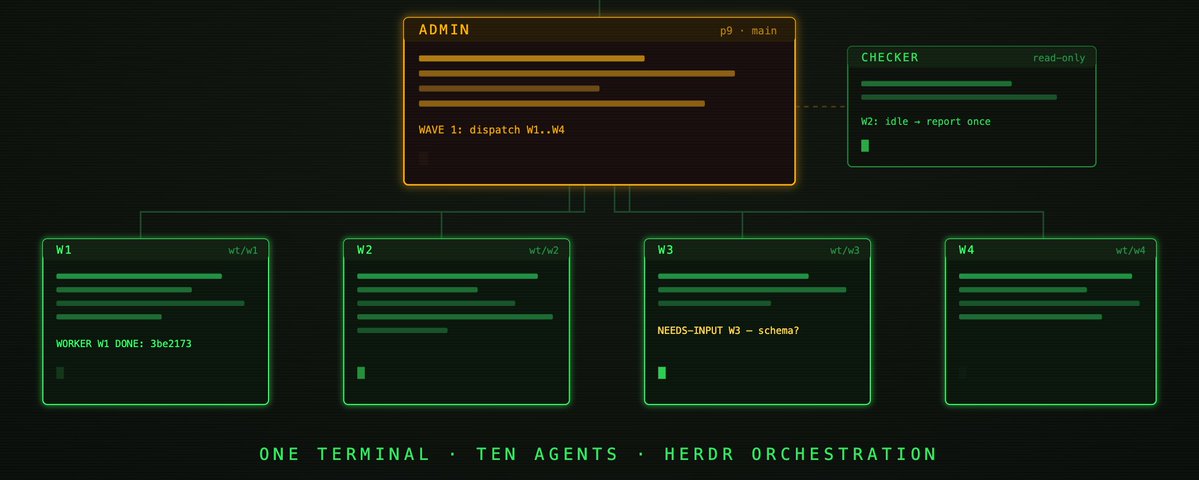
本文介绍 Herdr 编排方法,解决多编码 Agent 并行协作中的冲突与失控问题。通过严格的层级结构(Main、Admin、Worker、Checker 四种角色)、git worktree 物理隔离、依赖排序的 Wave 调度、三个哨兵字符串协议、只读 Checker 观察者模式以及人工审批的交付门禁,实现一个编排者管理 N 个工作者且零合并冲突。文中每条硬规则都源自真实失败教训,强调可预测性优于巧妙性,最后该 Skill 甚至由自己的 fleet 完成了公开发布。

技术 › Agent Ask Prateek 2026-09-0210.2 KB 1.8K 11 81

构建 AI 支出与 ROI 之间缺失的语义层

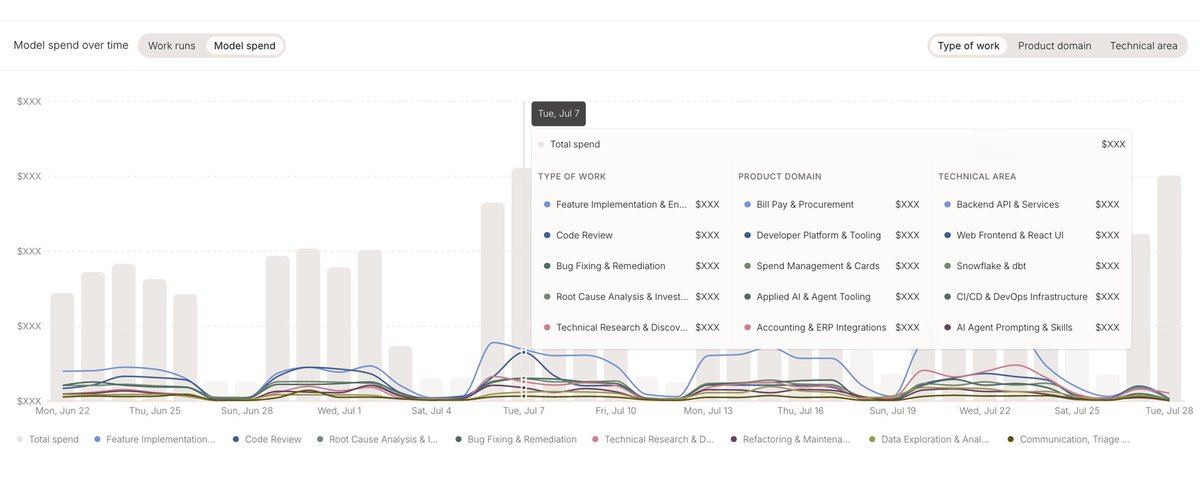
Ramp Labs 介绍了一套将 Agent 运行轨迹转化为语义层的流水线,用于实现 AI 支出到 ROI 的归因。系统首先将相互关联的多个 session 重建为完整的 agent run,再由抽取模型将 run 拆分为具有独立目标和结果的工作项(work item),并关联模型花费、团队、仓库等信息。基于内部编码 agent Inspect,三周内分析了约 20 万次运行、识别约 25 万个工作项,使公司能够从'AI 花了多少钱'进阶到'AI 产出了什么、回报如何'的评估。

技术 › Agent René Sultan / Ramp Labs 2026-09-0225.1 KB 137.4K 420 80

BestBlogs 早报 · 08-29|AI 原生开发重排团队,LLM 网关直面故障取舍

本期早报精选 AI 工程领域三篇精讲:Amazon 50 个工程团队试点揭示 AI 原生开发的关键在于重构上下文、代码库与验证机制,而非简单叠加工具,高表现团队生产力提升可达 4.5 倍以上;Twilio 分享生产化 LLM 网关经验,指出可用性、延迟、护栏与成本无法同时最大化,需按业务路径做故障取舍;斯坦福研究者通过 J-space 实验探讨 AI 可解释性,区分看见、验证与控制三个层次。速览部分涵盖 AI 推理成本优化、Uber 多智能体代码审查、Figma MCP Server、Context Engineering 及 Spring 可观测性等实践。

技术 › LLM ginobefun 2026-08-2928.0 KB 5.3K 2 83