Wiki 知识库

全部文档 / 标签: 横评

4 篇
清除

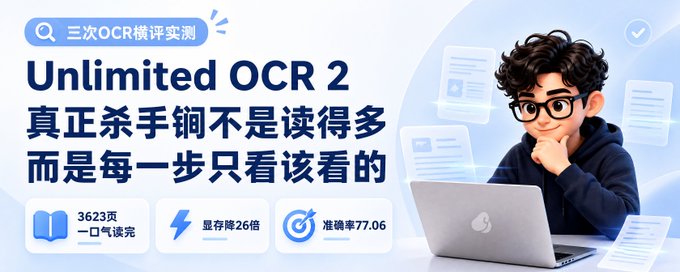
文心 Unlimited OCR 2 横评:杀手锏不是读得多,而是每一步只看该看的

作者基于此前多次 OCR 横评经验,介绍百度文心团队开源的 Unlimited OCR 2。作者实测 1665 页《平凡的世界》图片版 PDF,40 分钟完整解析,3623 页《哈利·波特》也只需 90 分钟。其核心创新是 SR-SWA(稀疏参考滑动窗口注意力),通过 Page Gate 划定相关页面、Token Sieve 挑选 top-k 视觉块,使每步计算量不随页数增长;配合无限解码机制,百页文档峰值显存从 47GB 降至 1.77GB。与全注意力相比快 7 倍,在 MarathonDocBench 上保持 SOTA。短板是全局结构信息(如标题层级)保留不足。

技术 › LLM Berryxia.AI 2026-10-2710.4 KB 2.8K 18 75

不拍视频做口播:数字人怎么选、怎么调、怎么建(附实测对比)

作者实测了 14 个数字人生成方案,用同一段配音和素材对比后,认为同价位中 HeyGen Avatar 5 效果最好,嘴型、声音和肢体动作最自然。文章总结了让数字人更逼真的 4 个细节:参考图应追求好看而非像本人、口型不能有延迟、肢体动作要自然且参考照片中需包含手部、提示词难以弥补模型能力不足。最后手把手讲解如何免订阅创建 AV5 数字分身并调用 API 出片,并指出了清理旧形象、避免遮挡嘴巴、锁定 AV5 引擎、注意竖屏裁剪和账户余额等 4 个常见坑。

技术 › 工具与效率 Leaf Yeah! 2026-09-297.8 KB 28.2K 86 85

8款前沿大模型能力横评:10个维度50项测试全解读

本文对8款前沿大模型进行了为期两天的深度横评,通过10个维度、50个细项的两轮测试,对比了模型在一次性复杂任务与拆解任务稳定性上的表现。文章详细解读了测试方法、评分标准及各模型优劣势,最终得出了适用于真实工作流的参考结论。

技术 › LLM huangserva 2026-08-1729.7 KB 30.7K 43 86

千元横测 GPT、DeepSeek、Xiaomi、MiniMax:最强模型与 Agent 的绝配组合

本文详细横评了 GPT 5.5、MiniMax M2.7、DeepSeek V4 Pro 和小米 Mimo-V2.5-Pro 四款大模型在 Hermes Agent 场景下的表现。通过 Skill 打包、网页开发、PPT 制作、知识库整理及浏览器自动化五项任务,测试了各模型的逻辑推理、审美迁移、长文本处理及 API 消耗能力。最终结果显示,不同模型在 Agent 任务中各具特色,需根据具体场景选择最优解。

技术 › Agent 卡尔的AI沃茨 2026-05-0119.4 KB 2.8K 9 75