Wiki 知识库

全部文档 / 标签: 语音合成

15 篇
清除

当前主流 TTS 文字转语音方案梳理

文章系统梳理了 2026 年主流开源 TTS 方案:CosyVoice 2 低延迟流式,适合实时语音 Agent 与数字人;GPT-SoVITS 擅长小样本音色微调与克隆;ChatTTS 拟人口语自然,适合 AI 播客;F5-TTS 与 Breeze-TTS 2 基于流匹配免对齐克隆,稳定性好;Fish Audio Drama 3 情绪表现力全面但算力要求高;MaskGCT 鲁棒性强,可处理气声耳语等极端发音;KittenTTS 2 体积极小,可在 CPU 端侧运行。各方案定位不同,读者可按延迟、音色、表现力与资源需求选型。
技术 › TTS 陈大黄 2026-10-252.5 KB 63

Ming-3.0-TTS 实操:声音克隆、原创音色和停顿控制,我都测试了一遍

作者实测蚂蚁灵波开源的 Ming-3.0-TTS 模型的三种核心能力:Voice Design(用文字描述创造原创音色)、Freeform(导演式指令控制重音、停顿和情绪)以及声音克隆(支持在正文中插入叹气、咳嗽、呼吸等声音事件标签)。文章详细介绍了从 Hugging Face 在线体验到本地部署的完整流程,包括参考音频准备、音色描述写作模板、命令行操作等,并提出判断 TTS 能否进入 AI 视频工作流的五项标准,如音色身份稳定性、重音停顿准确性、声音事件自然度等。

技术 › TTS 蔡文彬CyberBin 2026-10-219.6 KB 3.9K 54 82

本地配音:开源 VoiceStudio 把订阅制按在地上

文章介绍了开源项目 VoiceStudio(作者 debpalash),一个纯 Python、AGPL-3.0 协议的本地配音工具,定位为「开源、全程本地的 ElevenLabs 平替」。它支持声音克隆、声音设计、带时间轴对齐的视频配音、语音转写、有声书和批量任务,只需几十秒参考录音即可抽音色,官方支持六百多种语言。项目半年内获得约 6.7 万 Star,桌面端基于 Electron,数据全部留在本地不上传云端,兼容 NVIDIA CUDA 和苹果 Metal,并提供 Local API 和 MCP 供 Claude Code、Codex 等 Agent 调用。文章同时提醒性能受硬件限制、授权需分别确认,以及克隆声音必须取得对方授权。

技术 › TTS 北衡 2026-10-204.2 KB 2.3K 18 82

开源 TTS / 配音工具怎么选:10 个按用途分好

作者为搭建视频配音工作流,测评并整理了 10 个开源 TTS 项目,按用途分为四组:中文配音带情绪(IndexTTS、VoxCPM、Qwen3-TTS、CosyVoice)、声音克隆与个性化(GPT-SoVITS、Chatterbox)、多人对话与播客(Fish Speech、SoulX-Podcast)、轻量实时(Kokoro、VibeVoice-Realtime)。文章为每个工具提供官方安装命令、可直接复制给 Agent 的提示词、显存配置要求、许可证说明及踩坑经验,强调选型应先看用途和显卡配置,再看 GitHub 星数。

技术 › TTS 风渡fengdu 2026-10-1624.9 KB 13.3K 135 87

发现一个中文语音数据集:218人8万多条语音

作者发现一个中文语音数据集,包含218人的8万多条语音,情感中性,并带有性别、年龄、母语口音等标注,字音准确率达98%以上,经过专业标注和严格质检。开源TTS模型如F5、Spark、IndexTTS2都需要参考语音,自己录制麻烦,该数据集可以省去这一步。作者是在为Qiaomu Reader开发电子书朗读功能时发现的。文中附有数据集官网地址和语音样例链接。

技术 › TTS 向 向阳乔木 (@vista8) 2026-10-12976 B 60

Muse 接入 Fish Audio:从注册到出声,全流程

本文是一篇详细的接入教程,介绍如何在 Muse 中接入 Fish Audio TTS 服务。作者 TaoBuilds 对比了 Azure(稳定但音色固定)与 Fish Audio(支持声音克隆和特色音色)的差异,并给出六步接入流程:注册 Fish Audio 账号、切换到 Developer 模式、确认每月 8000 点的免费额度、创建 API Key、在 Muse 中关联 Key、编写调用脚本并实测出声,全程约 5 分钟。接通后日常语音仍走免费的 Azure,特色音色和声音克隆则用 Fish Audio 完成。文末提醒注意免费额度用量、不要克隆真人声音公开发布,以及 Key 泄露时的处理方法。

技术 › TTS TaoBuilds 2026-10-093.2 KB 9K 88 77

火山引擎豆包语音 TTS:免费 API 申请与接入教程

本文详细介绍了火山引擎豆包语音合成模型 2.0 的免费 API 申请与接入流程。作者一步步讲解了注册火山引擎控制台、开通语音合成 2.0 服务领取免费额度、创建 API Key 的方法,并说明音色 ID 与资源 ID 必须配对的规则。文章以 whiteboard-video Skill 为例演示了配置方法,并用 PowerShell 测试接口调用。同时整理了踩坑记录,包括 403 权限错误(需重建 Key)、音色与资源 ID 不配对、Key 泄露处理、Windows 手动安装 FFmpeg 等常见问题,最后提示通过用量统计合理节省免费额度。

技术 › TTS 一碗咕咪酱·AI GTM 2026-10-076.0 KB 2.6K 27 79

Seed Audio 1.0 影视级配音模型:被人严重低估的音频模型

文章介绍了 Seed Audio 1.0 影视级配音模型的强大能力。相比传统 TTS,它情绪维度广、精度细,支持动态情绪匹配;无需音色克隆,上传约 15 秒参考音频即可复刻音色;可指定输出时长、语速及停顿,方便后期对轨;支持 20 种语言并适配出海需求,还能演绎人物状态、通过提示词设计音效和配乐。作者建议包含角色介绍与台词分配以提升声音丰富度,但不建议配音中加入音效。应用场景包括广告、短视频、有声小说、漫剧、ASMR 和带货等。

技术 › TTS 冰河 2026-10-041.3 KB 68

不拍视频做口播:数字人怎么选、怎么调、怎么建(附实测对比)

作者实测了 14 个数字人生成方案,用同一段配音和素材对比后,认为同价位中 HeyGen Avatar 5 效果最好,嘴型、声音和肢体动作最自然。文章总结了让数字人更逼真的 4 个细节:参考图应追求好看而非像本人、口型不能有延迟、肢体动作要自然且参考照片中需包含手部、提示词难以弥补模型能力不足。最后手把手讲解如何免订阅创建 AV5 数字分身并调用 API 出片,并指出了清理旧形象、避免遮挡嘴巴、锁定 AV5 引擎、注意竖屏裁剪和账户余额等 4 个常见坑。

技术 › 工具与效率 Leaf Yeah! 2026-09-297.8 KB 28.2K 86 85

Codex直出,开源一个手绘风视频Skill,让长文一键转视频!

万象AI实验室开源了一个手绘白板风格视频生成Skill,可在Codex中把长文自动转为讲解视频。基于HyperFrames插件,工作流程包括:自动拆分文章为2-6个镜头、生成白底黑线手绘稿、通过HTML叠加渲染文字标注、使用Mac内置语音配音、虚拟马克笔逐步揭示画面并渲染成视频。整个过程无需额外API,十几分钟即可完成,适合信息密度高的技术科普和分析文章,不适合叙事性强的内容。已在GitHub开源,安装简单,配音可替换为个人音色定制专属Skill。

技术 › Skill MixAILab | 万象AI实验室 2026-09-197.4 KB 14.5K 103 80

图解 ASR 和 TTS:HuggingFace 开源模型测评

作者实测了 HuggingFace 上多语种榜单第一、可本地部署的开源语音模型 Hojo-ASR-Multi-V1 和 Hojo-TTS-Light-40M。通过普通话、粤语、四川话及多国外语的实际听写测试,发现该 ASR 模型在普通话和粤语表现出色,但在方言虚词、专名和噪声场景下会出错;TTS 小模型在 CPU 上即可快速合成中英夹杂语音。文章还分析了模型体量、内存和 RTF 的关系,并给出不同场景下 ASR/TTS 开源模型的选型建议。

技术 › TTS WquGuru 2026-09-0514.2 KB 108.2K 105 86

We Made Our Best Voice Model Free. Here's the GPU Math Behind It.

Fish Audio 通过重构 S2.1 Pro 语音模型的服务栈,将 GPU 利用率从约 50% 提升至 90% 以上,使原本需要四块 H200 的请求量现在一块即可承载。核心技术包括:针对 TTS decode 小矩阵形状定制的 FP8 CUDA 内核(比 torch.compile-fused cuBLAS 快 2.1–4.3 倍)、Continuous Batching(并发 1 到 64 吞吐量提升约 52 倍,仅增加 37ms 延迟)、Kubernetes 与 Slurm 弹性调度填充空闲算力,以及自建网络与存储基础设施。所有推理变更均需通过正确性与性能双重门槛。这些优化带来的单位经济效益使 Fish Audio 能够将完整的 S2.1 Pro 模型免费开放,并开源了 fish-scales-ops 内核库。

技术 › TTS Fish Audio 2026-08-289.6 KB 13.5K 227 84

免费开源TTS模型Confucius 4-TTS:本地声音克隆实战与WeSight集成

文章介绍了如何利用网易有道开源的免费TTS模型Confucius 4-TTS实现本地声音克隆。作者展示了将该模型集成到WeSight桌宠中,实时使用复刻音色进行任务播报的过程。该模型仅1.3B大小,支持14种语言的无参考文本克隆,并提供了详细的本地部署代码及在Mac和远程服务器上的运行方案。

技术 › TTS 苍何 2026-06-288.1 KB 44.3K 311

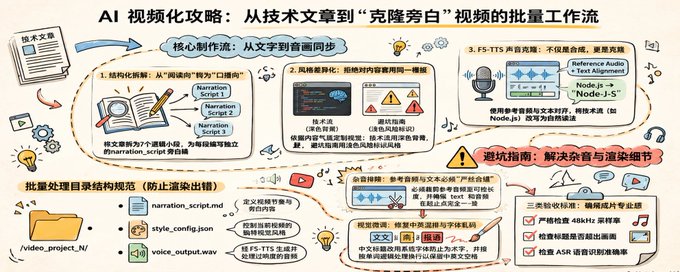
HyperFrames + F5:批量文章转视频实战

本文详述了一套将技术文章批量转化为带克隆旁白视频的自动化工作流。作者通过结合 HyperFrames 与 F5-TTS,将文章拆解为口播脚本,针对不同技术风格定制视频界面,并重点解决了文本对齐、技术术语发音及字体显示等常见问题,提供了完整的从脚本到成片的质量验收标准。

技术 › TTS A AFei Liang 2026-06-2410.3 KB

ElevenLabs 推出 Dubbing V2:端到端 AI 配音模型

ElevenLabs 发布全新 Dubbing V2 端到端 AI 配音模型。该模型摒弃了传统的“转写-翻译-合成”三段式流程,直接基于原始表演进行声音建模。它支持 90 多种语言和口音,能完美保留原说话人的音色、情绪、呼吸节奏及身份特征,实现音色穿越和情绪保真。同时支持音频、视频及文字输入,提供限时免费体验。

技术 › TTS 小互 2026-05-292.3 KB 82