Wiki 知识库

全部文档 / 标签: 性能测试

6 篇
清除

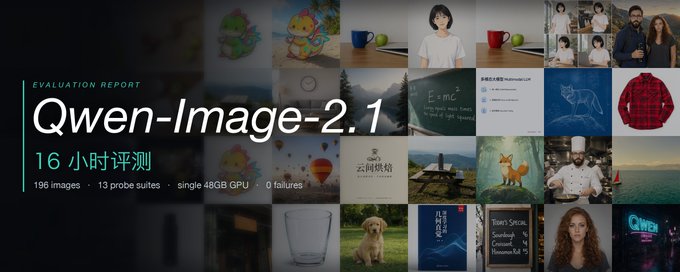
万字长文:通宵评测Qwen-Image-2.1

作者在48GB的4090上对Qwen-Image-2.1进行了13组实验、196张图的深度评测。模型视觉生成为7B DiT架构,配Qwen3-VL编码指令与参考图,支持原生RGBA透明。评测发现其强项为中文排版、原生透明通道和多图身份保持,弱项是「替换」语义常退化为「添加」、编辑具有非局部性、缺乏时间维度建模。文章详细测试了文字渲染阈值、透明度真实性、指令遵循、编辑精度、多图参考及性能表现,并给出KV cache与显存的权衡策略。最后作者通过360°转台动画实验,揭示了条件图下seed敏感性等反直觉发现,定位其为关键帧生成器而非视频模型。

技术 › LLM 实践哥 Li 2026-09-2118.2 KB 525.6K 599 90

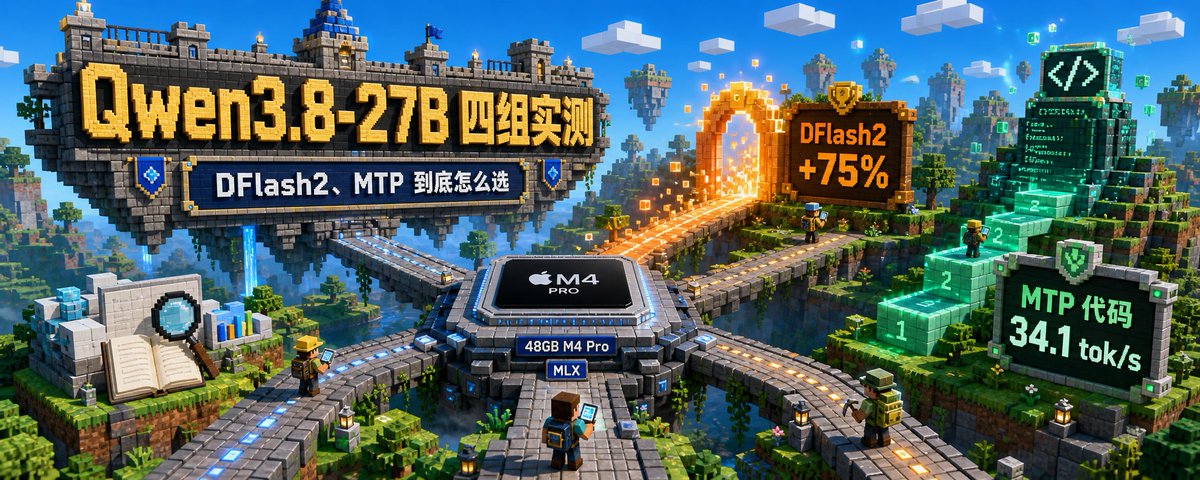
同一台 M4 Pro 实测四组 Qwen3.8-27B:DFlash2、MTP 到底怎么选

作者在 48GB M4 Pro MacBook 上对比了 Qwen3.8-27B 的四组运行配置:官方 4-bit、Uncensored 版、官方 4-bit + DFlash2 草稿模型,以及 oQ4e + MTP。结果显示 DFlash2 平均提速 75%(约 26.96 token/s),数学与 GSM8K 场景超过两倍;oQ4e + MTP 在长文与代码负载下分别达 24.9 和 34.1 token/s,代码吞吐最高但部署复杂、首 token 延迟明显。结论是日常优先官方 4-bit + DFlash2,代码和长输出用 MTP,Uncensored 仅限隔离环境研究使用。

技术 › LLM 雪瑜 2026-08-248.2 KB 9.1K 57 82

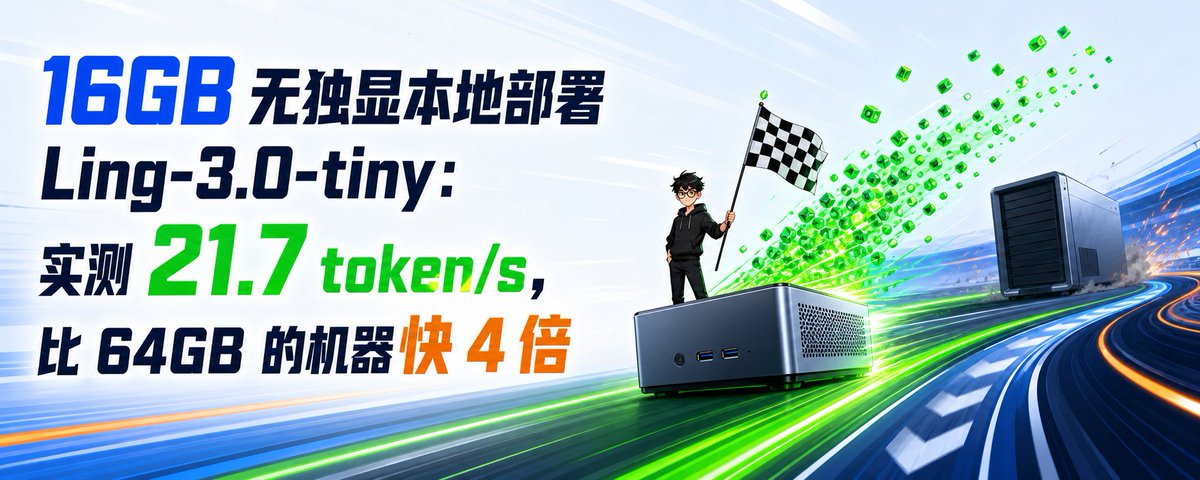
16GB 无独显本地部署 Ling-3.0-tiny 实测:21.7 token/s 与推理引擎版本的秘密

作者在一台单通道 16GB 内存、无独显的 Ryzen 5 5600G 台式机上,使用 llama.cpp 官方版部署 Ling-3.0-tiny(Q4KM 量化),实测生成速度 21.70 tok/s,比配置更强的 64GB+3090 机器快近 4 倍。经排查,差异源于推理引擎版本而非硬件。文章还分析了该模型线性注意力架构带来的超低上下文内存开销(约 6.79 KiB/token),总结了思考模式、Windows 编码、线程设置三个实践坑,并给出三步部署教程,证明普通电脑即可流畅本地运行该模型。

技术 › LLM 阿良|AI 工作流 2026-08-2414.2 KB 71.3K 177 90

8款前沿大模型能力横评:10个维度50项测试全解读

本文对8款前沿大模型进行了为期两天的深度横评,通过10个维度、50个细项的两轮测试,对比了模型在一次性复杂任务与拆解任务稳定性上的表现。文章详细解读了测试方法、评分标准及各模型优劣势,最终得出了适用于真实工作流的参考结论。

技术 › LLM huangserva 2026-08-1729.7 KB 30.7K 43 86

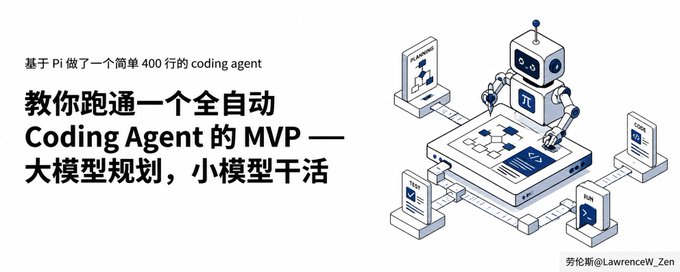
全自动 Coding Agent 实战:大模型规划,小模型干活

文章验证了一个关于多 Agent 编排的猜想,通过搭建 hero-coding MVP,对比了 ChatGPT 5.4、Ling-2.6-flash 和 Ling-2.5-1T 在编码任务中的表现。结果显示,非思考小模型(Flash)在明确 Bug 修复上比思考模型快 31%,而 Ling-1T 在加功能任务上仅需 11% 的 Token 和 63% 的时间。作者总结出“大模型规划,小模型干活”的最佳实践,并强调了非思考模型必须配合 Harness 工程兜底的重要性。

技术 › Agent 劳伦斯 2026-04-2910.4 KB 194K 459 82

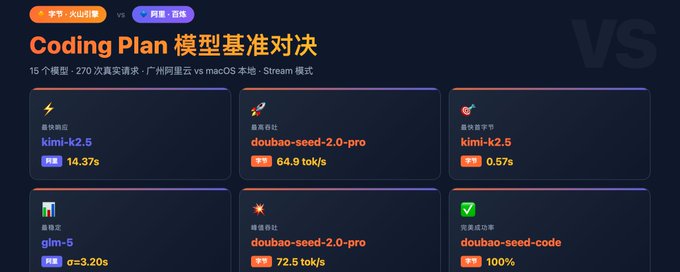
火山方舟 vs 阿里百炼|Coding Plan 实测对比报告

本文对比了字节火山方舟与阿里百炼两大平台的 Coding Plan API 服务性能。通过 270 次请求测试,从响应速度、吞吐量(TTS)和稳定性三个维度,对包括 GLM、Kimi、DeepSeek 等主力模型进行了评估。结果显示,对于相同的旧版本模型,阿里百炼在速度上完胜;而字节方舟在模型更新速度(如 k2.6)和覆盖广度上更具优势。

技术 › LLM luolei 2026-04-223.9 KB 46.6K 94 81