Eval工程:如何真正评估AI系统是否变得更好
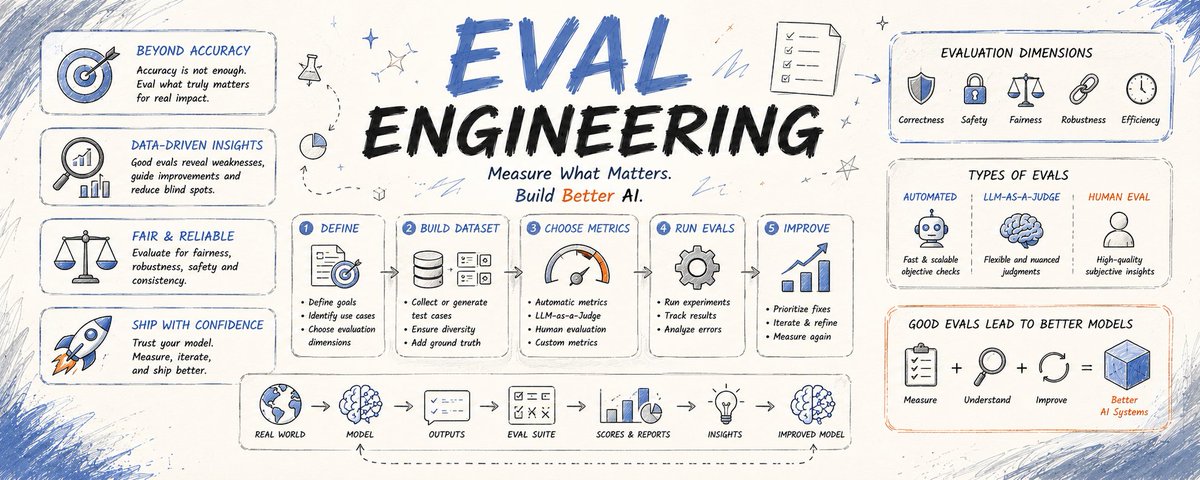
文章介绍了“评估工程”的概念,强调主观感觉无法替代系统化测试。构建可靠的AI评估体系需要三个核心部分:具有代表性的数据集、客观的打分器和预设的及格阈值。作者详细阐述了如何构建包含常规、边缘和已知失败的数据集,以及如何选择精确匹配、规则打分或模型打分机制。最后强调,评估必须在每次系统变更时自动运行,以防微小的改动引发严重的隐性回归。
文章介绍了“评估工程”的概念,强调主观感觉无法替代系统化测试。构建可靠的AI评估体系需要三个核心部分:具有代表性的数据集、客观的打分器和预设的及格阈值。作者详细阐述了如何构建包含常规、边缘和已知失败的数据集,以及如何选择精确匹配、规则打分或模型打分机制。最后强调,评估必须在每次系统变更时自动运行,以防微小的改动引发严重的隐性回归。
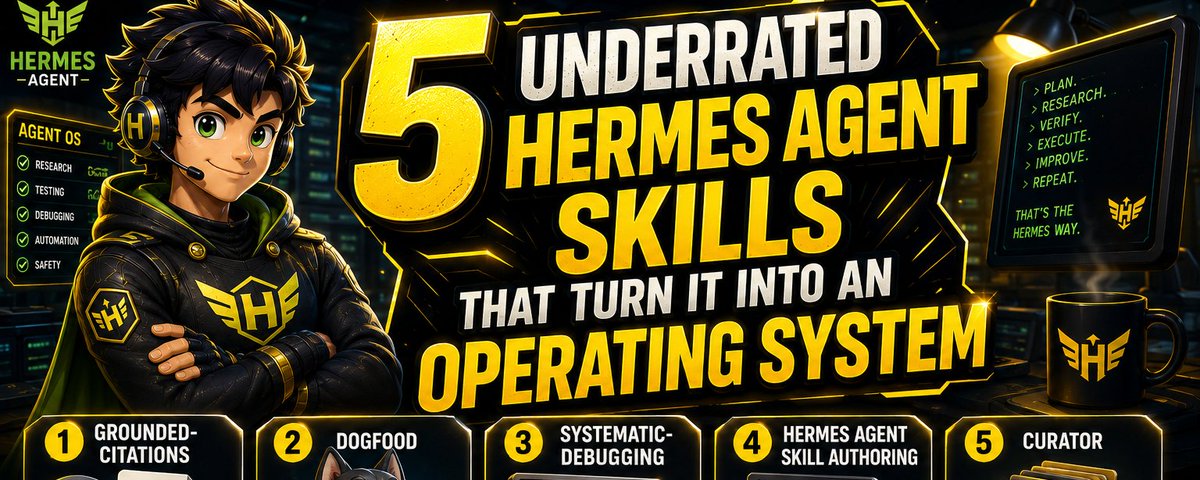
本文介绍了能将 Hermes Agent 提升为操作系统的五个强大且常被低估的技能。grounded-citations 通过要求提供可验证来源来确保研究准确性;dogfood 作为测试代理,以真实用户视角发现产品交互缺陷;systematic-debugging 强调在修改代码前先进行结构化调查以找到根本原因;hermes-agent-skill-authoring 将重复工作转化为可复用的记忆技能。这些技能大幅提升了 AI 工作流的可靠性、可扩展性和操作效率。