Wiki 知识库

全部文档 / 标签: Continuous Batching

4 篇
清除

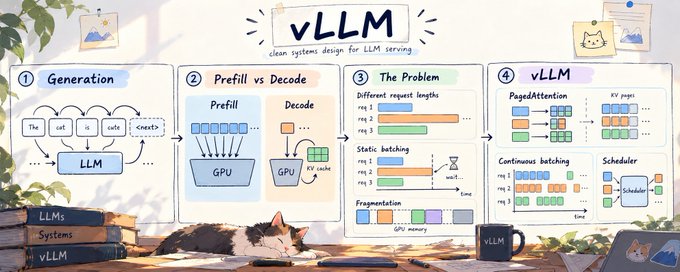
vLLM 架构之美:PagedAttention 与 Continuous Batching 解析

作者赞颂 vLLM 的软件设计之美。文章首先介绍 LLM 自回归生成的基本原理,以及推理的两个阶段:计算密集的 Prefill 和带宽受限的 Decode,指出 KV Cache 动态增长与静态批处理带来的内存浪费问题。vLLM 借鉴操作系统分页思想,将 KV Cache 切分为固定大小的块并维护逻辑到物理的块表(PagedAttention),将内存浪费降至约 3%;配合 Continuous Batching 和动态调度,避免已完成的请求阻塞整个批次,让 GPU 始终保持高效。作者认为 vLLM 的成功源于借鉴已被大规模验证的成熟系统概念。

技术 › LLM Atharva 2026-09-275.1 KB 21K 401 56

LLM 推理引擎到底是怎么工作的:从 token 到 KV 缓存、连续批处理,再到 Agent Loop

文章基于 TogetherAI 团队 Zain 的分享,沿一个请求的完整生命周期拆解 LLM 推理引擎(vLLM、SGLang、TensorRT-LLM)的内部机制。核心洞察是:prefill 计算受限、decode 内存带宽受限;KV cache 用空间换掉平方级计算,但成为显存瓶颈。引擎通过连续批处理让 GPU 每 pass 都不空闲,PagedAttention 像操作系统管理内存一样管理 KV cache(碎片率从 60-80% 降到 4% 以下),chunked prefill 摊平长 prompt 带来的延迟尖峰。Agent 循环因每轮重发完整对话、输入越来越长而输出极短,使其痛点落在 prefill 与 KV cache 上:prefix caching 可将 100 轮 agent 的总 prefill 工作量从约 55 倍降到约 10 倍,'缓存为王'是 agent 与引擎的交汇点。

技术 › LLM meng shao 2026-09-139.5 KB 46.7K 414 81

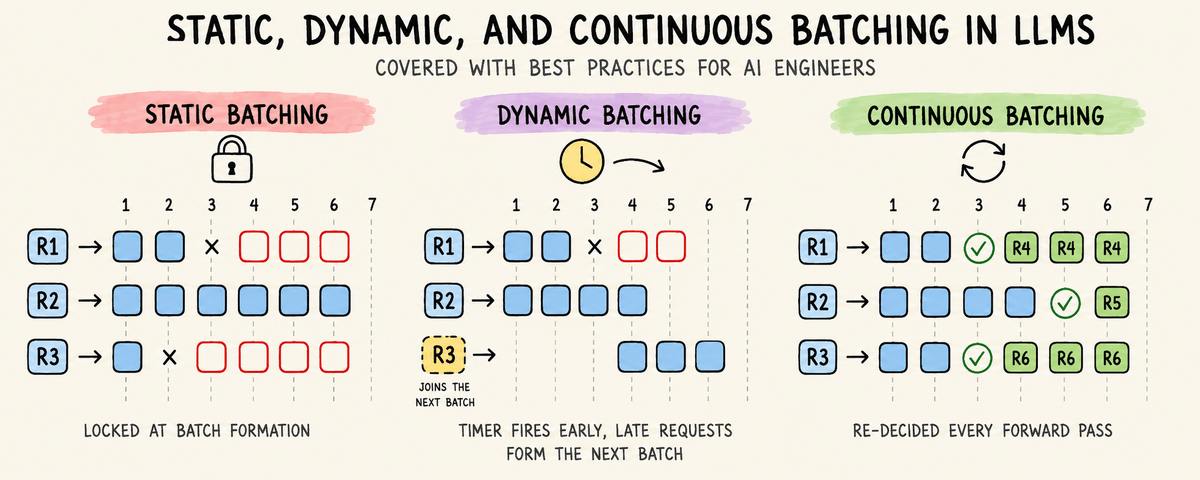
Static vs. Dynamic vs. Continuous Batching in LLMs, clearly explained

文章从第一性原理剖析了 LLM 推理服务中三种批处理策略。现代 GPU 在 LLM 解码时受显存带宽限制,计算单元大量空闲,批处理可将权重读取成本分摊到多个序列以提升吞吐。由于自回归解码的输出长度不可知、序列间相互依赖,传统批处理存在短板:静态批处理在批开始时一次决定,受最慢成员拖累;动态批处理加入定时器,缓解入批等待但仍整批绑定;连续批处理(iteration-level scheduling)在每次前向传播后重新调度,完成的序列立即让位给排队请求,是现代推理引擎高吞吐的关键。文章还讨论了固定输出场景下静态批处理的适用性,并给出 vLLM 和 Triton 的配置示例。

技术 › LLM Akshay 2026-09-0112.8 KB 57.2K 285 78

We Made Our Best Voice Model Free. Here's the GPU Math Behind It.

Fish Audio 通过重构 S2.1 Pro 语音模型的服务栈,将 GPU 利用率从约 50% 提升至 90% 以上,使原本需要四块 H200 的请求量现在一块即可承载。核心技术包括:针对 TTS decode 小矩阵形状定制的 FP8 CUDA 内核(比 torch.compile-fused cuBLAS 快 2.1–4.3 倍)、Continuous Batching(并发 1 到 64 吞吐量提升约 52 倍,仅增加 37ms 延迟)、Kubernetes 与 Slurm 弹性调度填充空闲算力,以及自建网络与存储基础设施。所有推理变更均需通过正确性与性能双重门槛。这些优化带来的单位经济效益使 Fish Audio 能够将完整的 S2.1 Pro 模型免费开放,并开源了 fish-scales-ops 内核库。

技术 › TTS Fish Audio 2026-08-289.6 KB 13.5K 227 84