发现一个中文语音数据集:218人8万多条语音
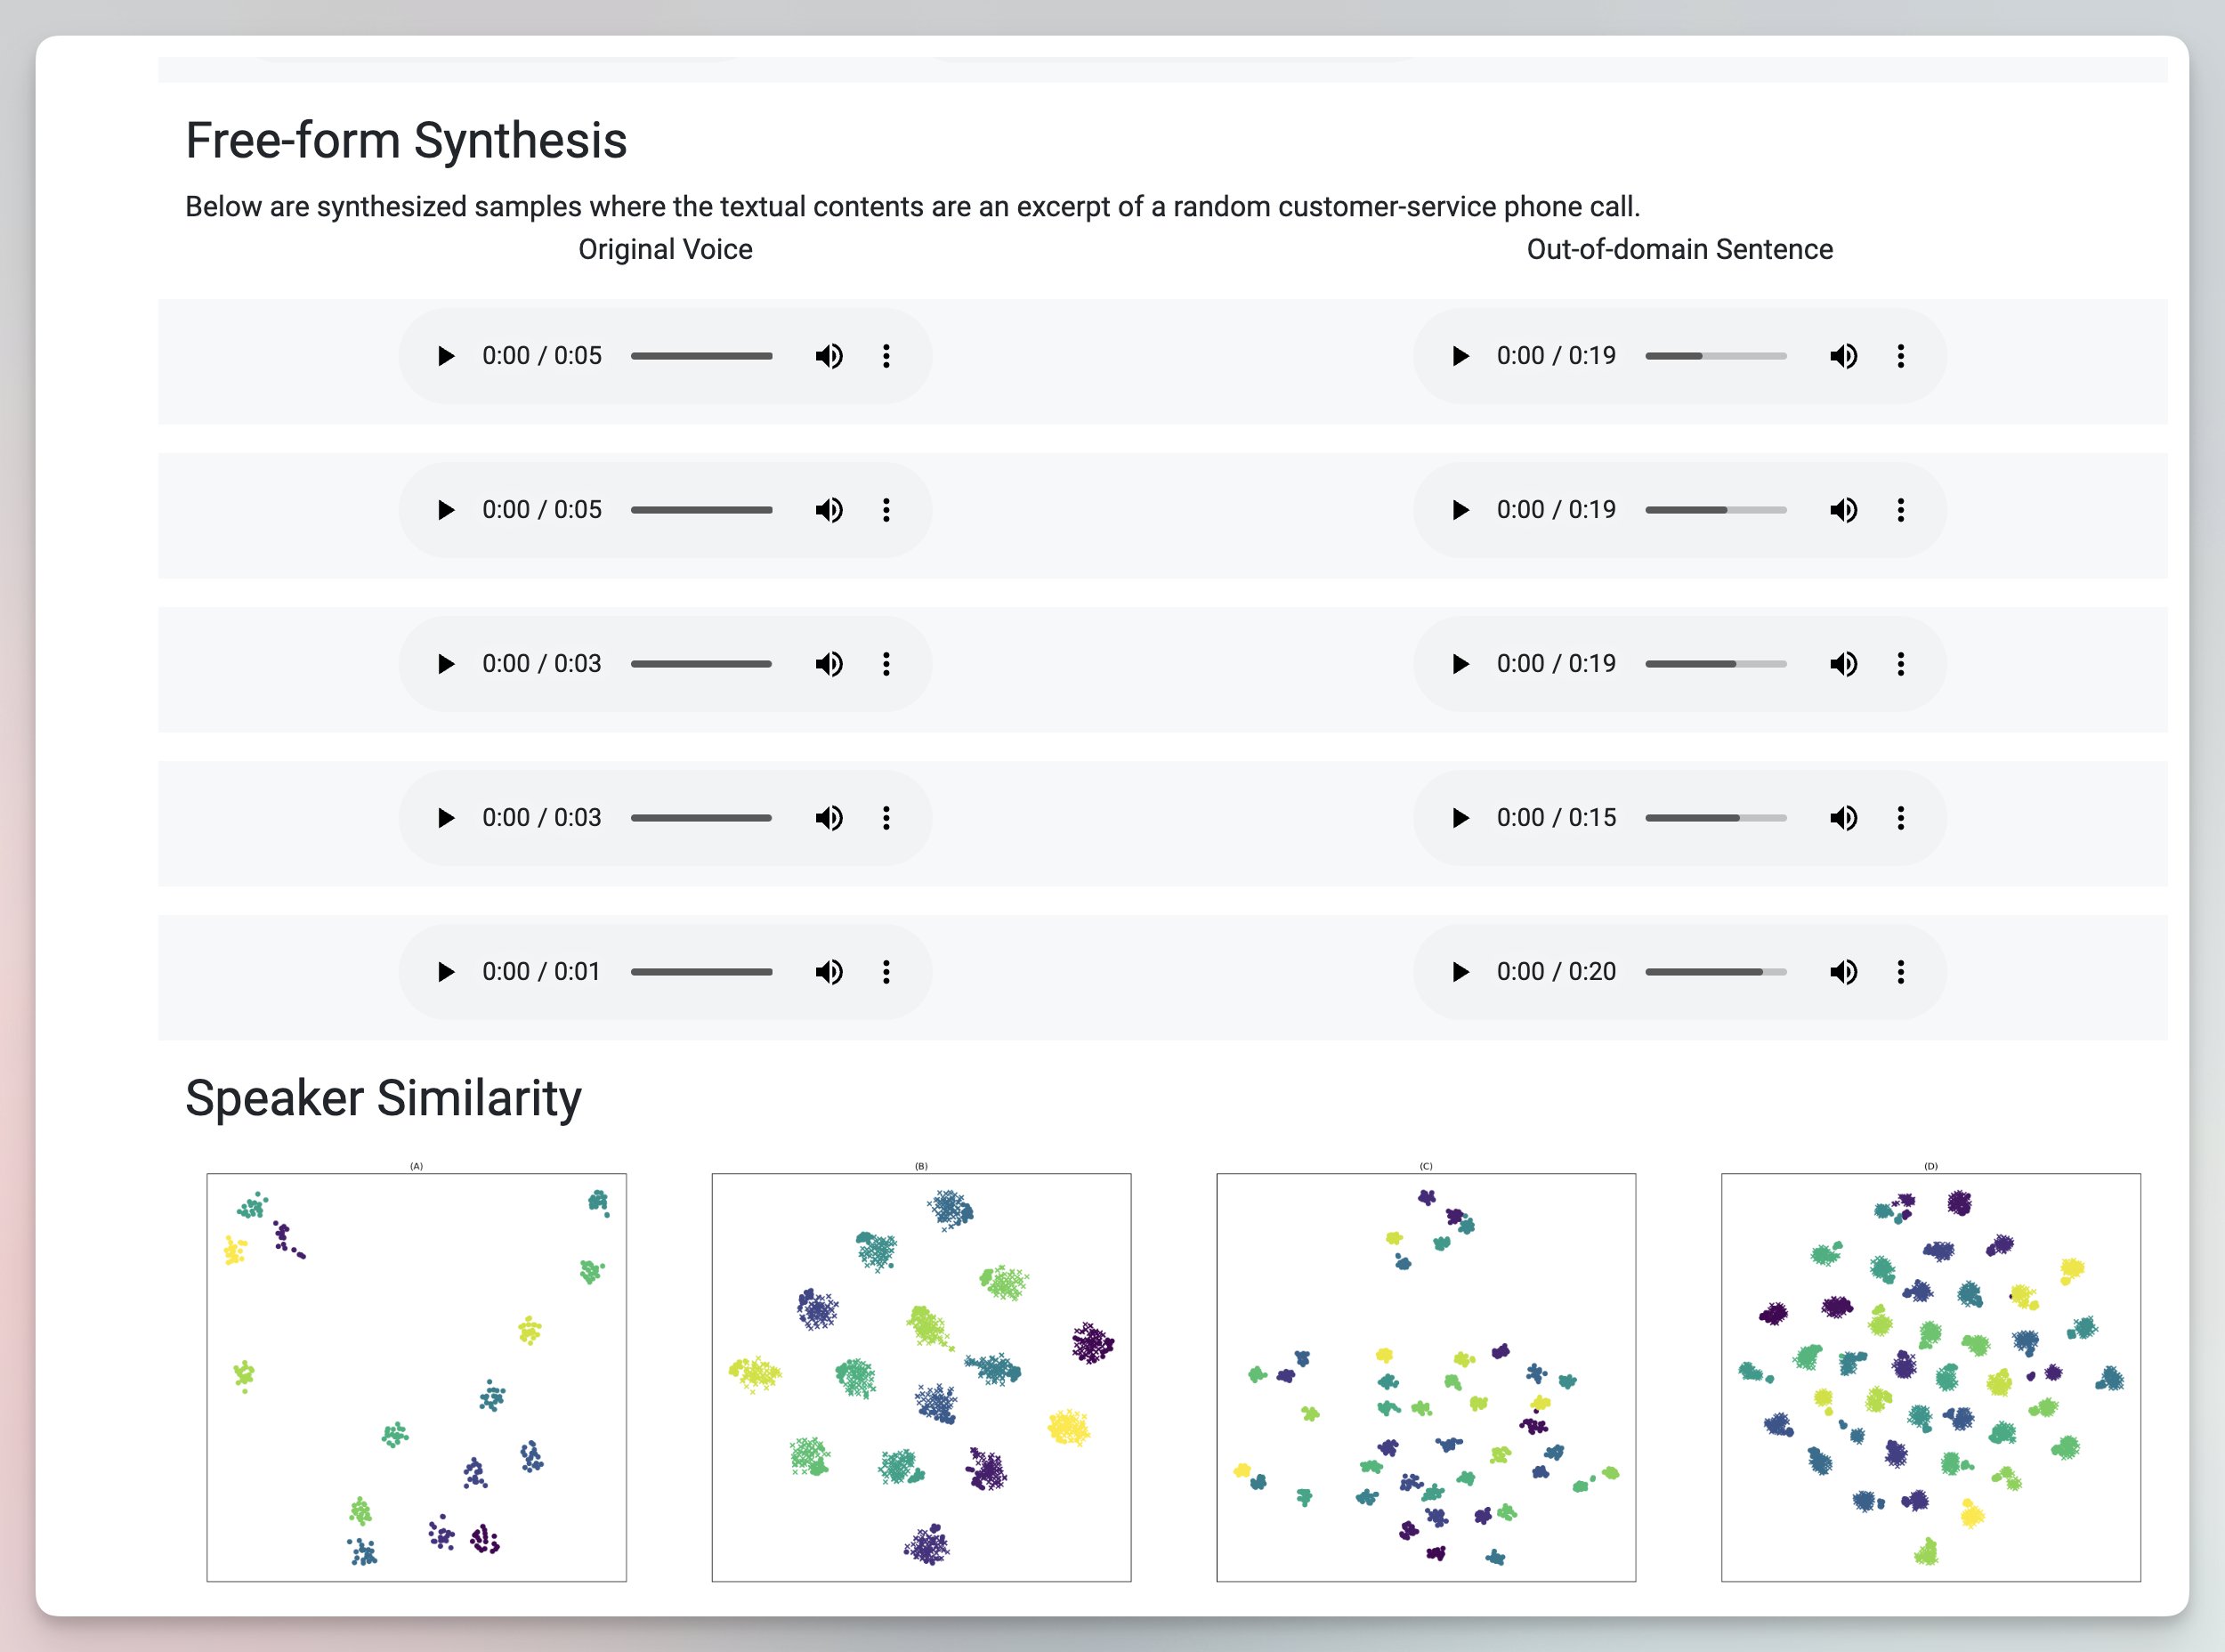
作者发现一个中文语音数据集,包含218人的8万多条语音,情感中性,并带有性别、年龄、母语口音等标注,字音准确率达98%以上,经过专业标注和严格质检。开源TTS模型如F5、Spark、IndexTTS2都需要参考语音,自己录制麻烦,该数据集可以省去这一步。作者是在为Qiaomu Reader开发电子书朗读功能时发现的。文中附有数据集官网地址和语音样例链接。
作者发现一个中文语音数据集,包含218人的8万多条语音,情感中性,并带有性别、年龄、母语口音等标注,字音准确率达98%以上,经过专业标注和严格质检。开源TTS模型如F5、Spark、IndexTTS2都需要参考语音,自己录制麻烦,该数据集可以省去这一步。作者是在为Qiaomu Reader开发电子书朗读功能时发现的。文中附有数据集官网地址和语音样例链接。
作者开源了一套AI视频自动化生产工作流BoomEarth,一周内在多个平台涨粉2000多。该工作流从定稿到出片仅需20-30分钟,内置九套视频风格,支持自定义IP形象。文章详细介绍了部署步骤:安装Git、Node.js、FFmpeg等基础环境,接入本地IndexTTS2配音,配置生图与ASR字幕服务,并通过Agent编排内容理解、画面生成、配音字幕、视频合成与质检归档的完整流程。文章强调先跑通30秒短验证片再扩展,按阶段恢复失败任务,避免重复扣费,实现部署一次、重复使用的低门槛视频生产线。
本文分享了作者在制作AI视频过程中,从使用MiniMax云端API转向本地部署IndexTTS2的实践经验。作者详细对比了两者在中英混排发音、音频格式、离线能力、声线一致性及成本等方面的优缺点,最终选择了IndexTTS2以保障视频工作流的可控性与稳定性。
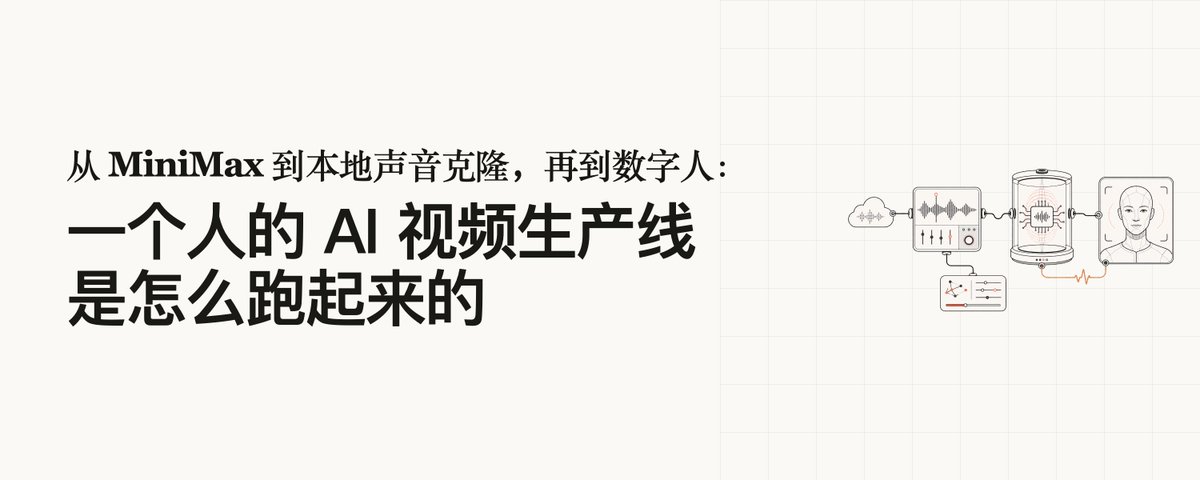
文章详细记录了作者构建个人 AI 视频生产线的全过程。包括从 MiniMax 云端声音克隆迁移到本地 IndexTTS2 以降低成本和延迟,解决参考音频漂移问题;接入 HeyGen 数字人实现虚拟分身,并通过脚本自动化视频合成与人脸裁切。文章分享了具体的代码配置、生产流程(脚本、配音、字幕、合成)以及避坑指南,适合高频视频创作者参考。
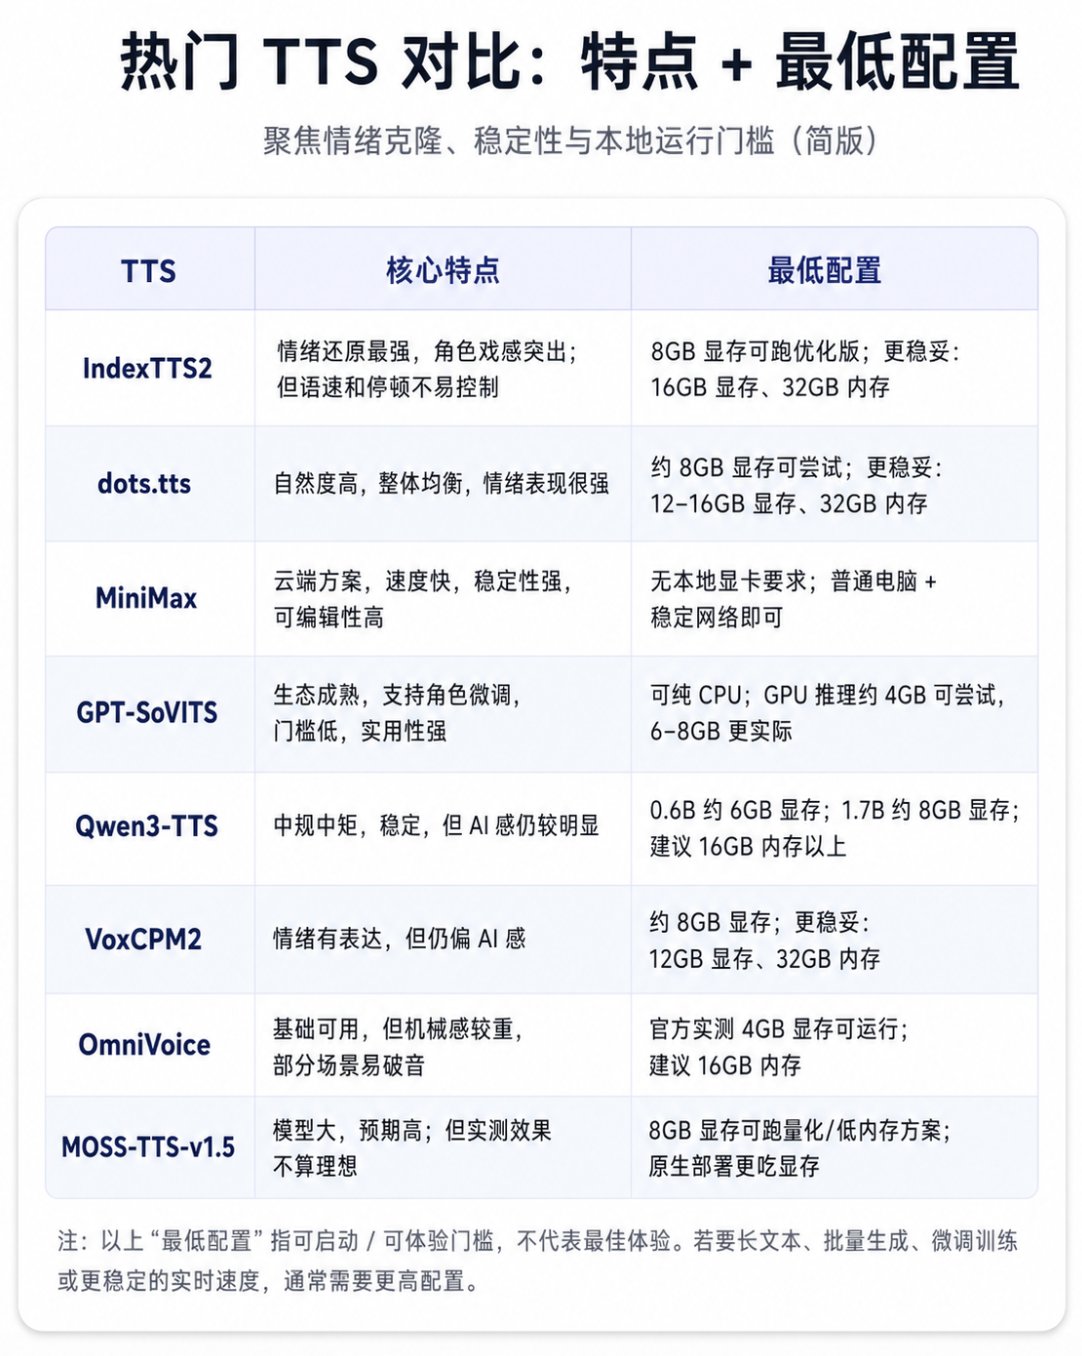
文章评测了多款热门 TTS 工具:IndexTTS2 擅长情绪克隆,dots.tts 表现均衡,MiniMax 省心且速度快,GPT-SoVITS 最实用且门槛低。同时指出了 Qwen3-TTS 等工具的不足,并提供了本地部署的硬件建议。