发现一个中文语音数据集:218人8万多条语音
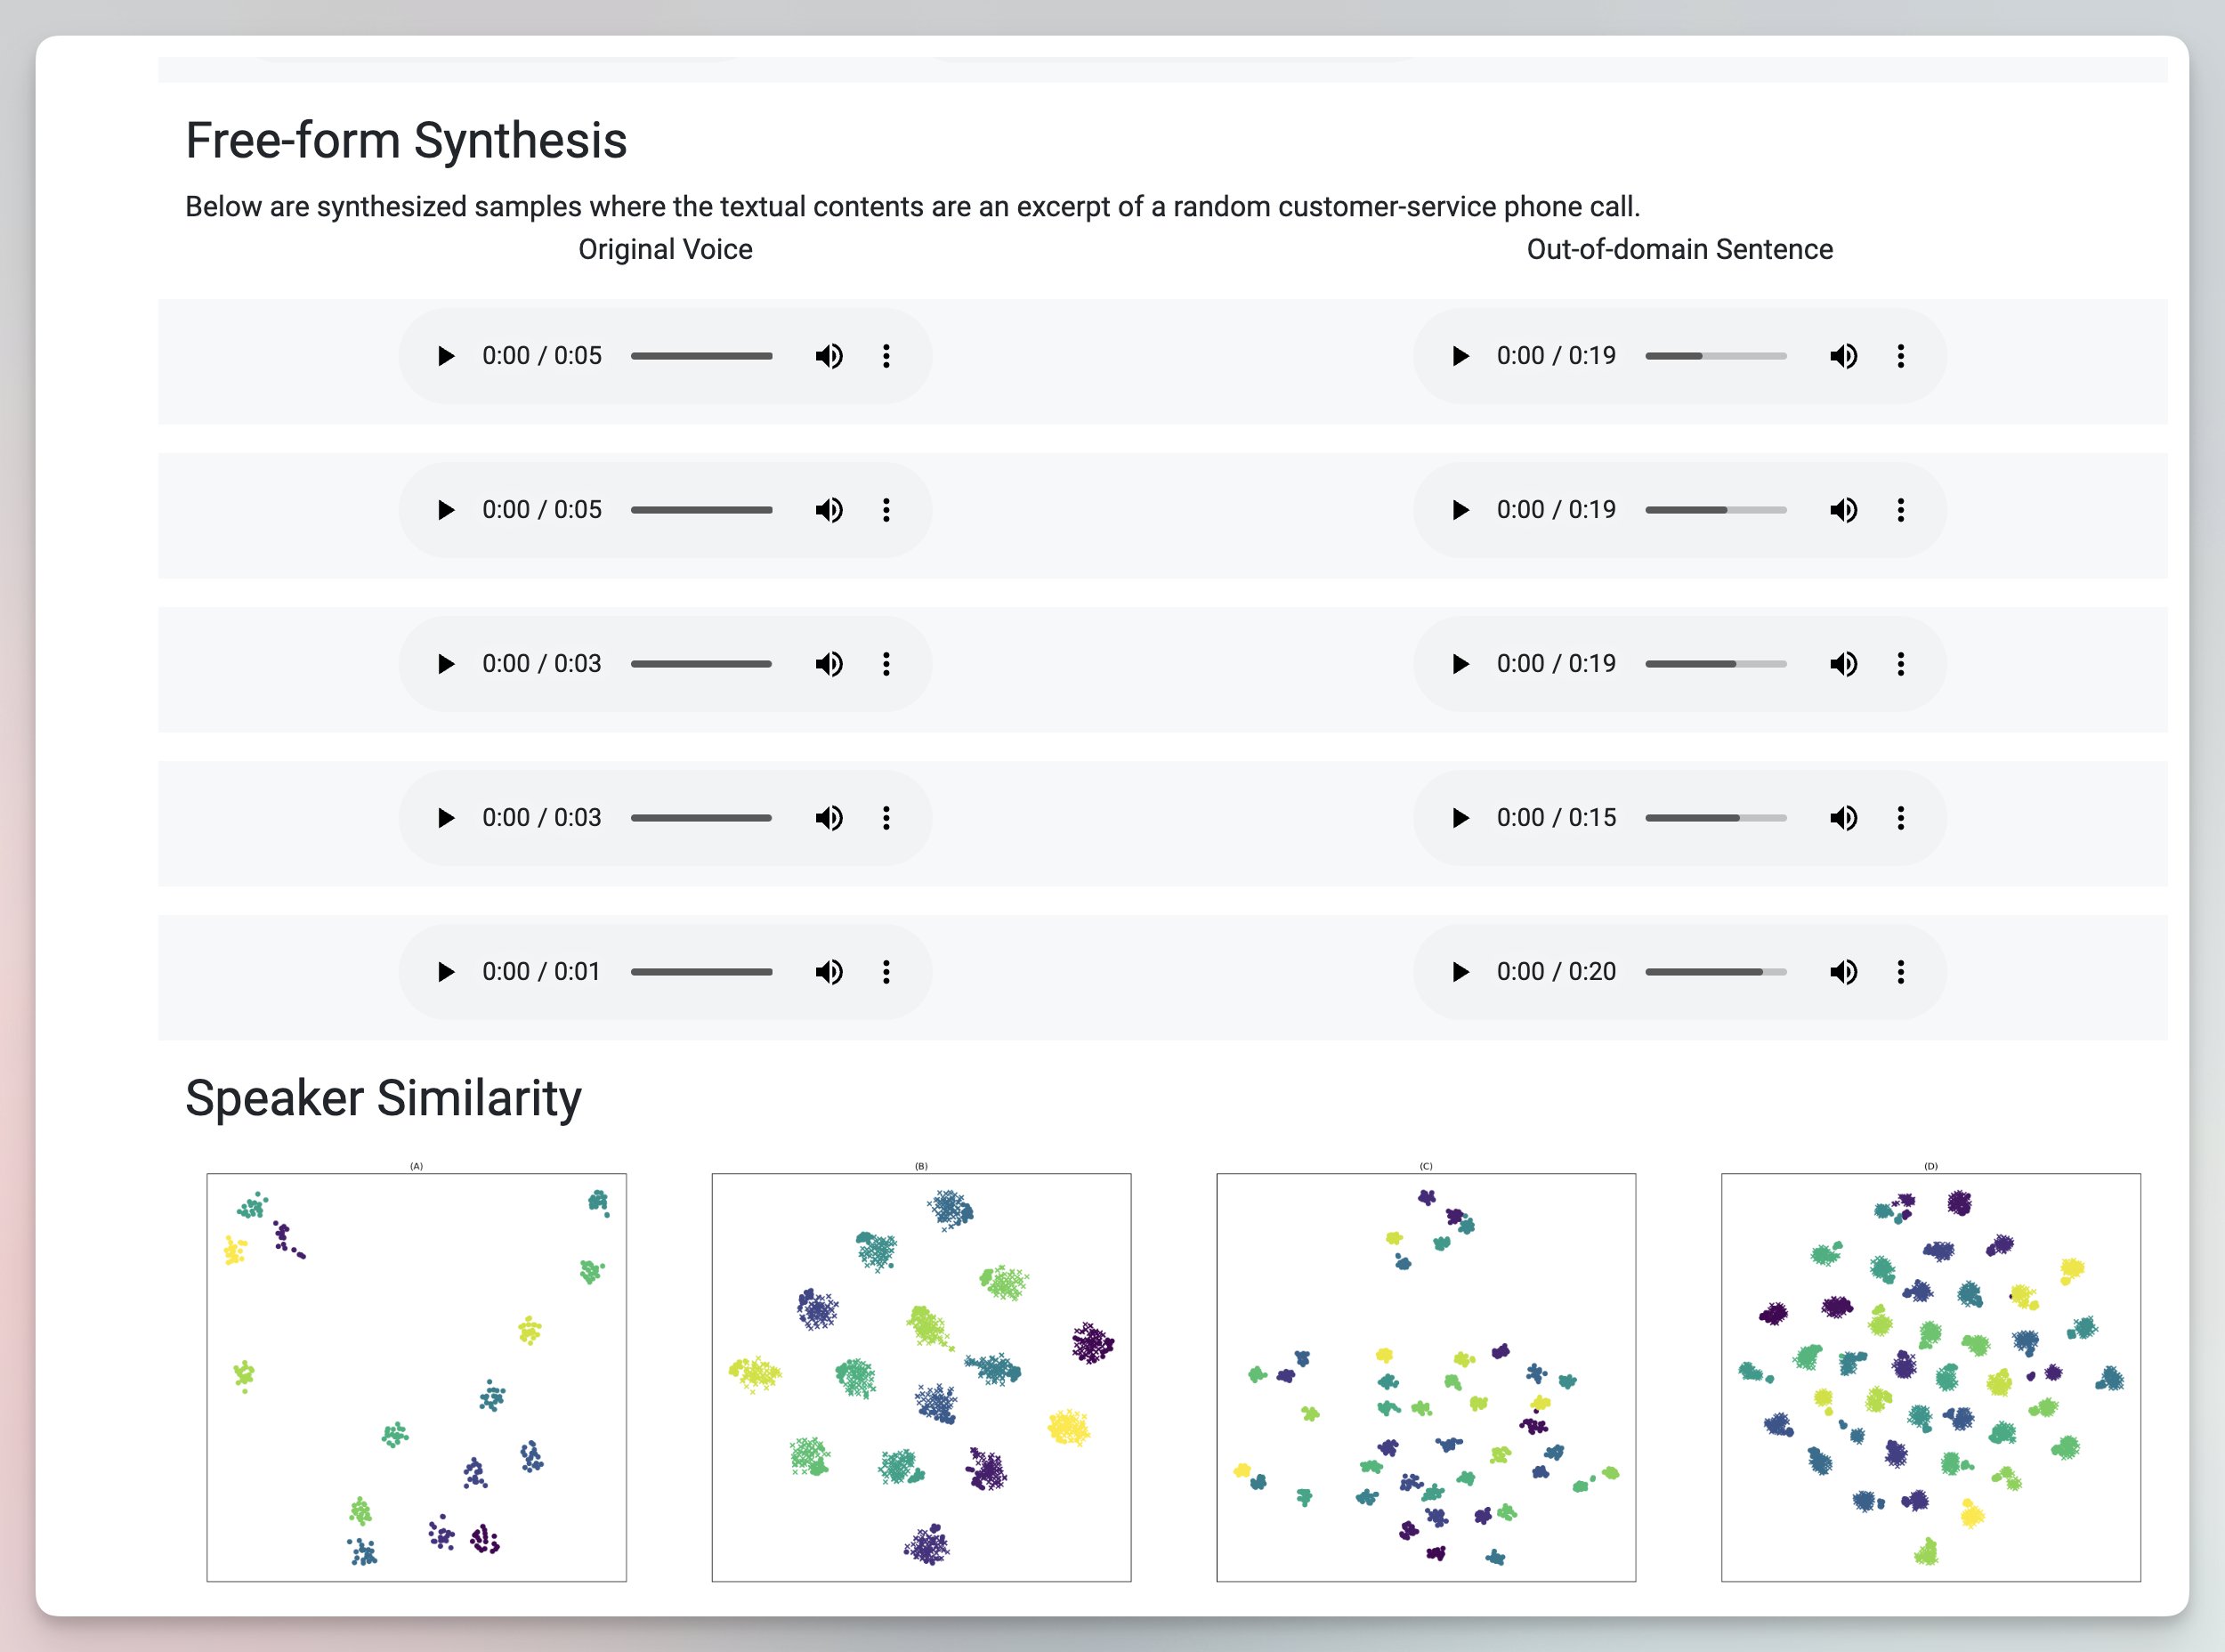
作者发现一个中文语音数据集,包含218人的8万多条语音,情感中性,并带有性别、年龄、母语口音等标注,字音准确率达98%以上,经过专业标注和严格质检。开源TTS模型如F5、Spark、IndexTTS2都需要参考语音,自己录制麻烦,该数据集可以省去这一步。作者是在为Qiaomu Reader开发电子书朗读功能时发现的。文中附有数据集官网地址和语音样例链接。
作者发现一个中文语音数据集,包含218人的8万多条语音,情感中性,并带有性别、年龄、母语口音等标注,字音准确率达98%以上,经过专业标注和严格质检。开源TTS模型如F5、Spark、IndexTTS2都需要参考语音,自己录制麻烦,该数据集可以省去这一步。作者是在为Qiaomu Reader开发电子书朗读功能时发现的。文中附有数据集官网地址和语音样例链接。
作者分享了一个低成本利用Gemini Pro会员搭建个人选题与素材库的思路:通过Gemini Spark结合YouTube与Google Drive,自动搜集感兴趣创作者(如Dan Koe)的高播放量视频,将标题、链接、摘要与逐字稿整理到Google Sheets和Docs中。同时演示了打造X情报雷达的方法,自动汇总特定主题的可核实推文。文章强调素材搜集后需自行筛选与核对,并将素材库与写作Skill衔接,形成搜集、整理、入库、筛选、写作、回存的完整流程。
文章回顾了作者 Kevin Fischer 四年来探索赋予 AI“灵魂”的旅程。他批评了当前业界只追求智能的竞赛,提出真正重要的是“临场感”。通过构建名为 Spark 的数字金毛犬,并采用类似“傀儡师”的远程操控技术进行家庭实验,作者发现建立情感联结的关键不在于复杂的对话,而在于“被关注”的感觉。技术实现上,Spark 摒弃了单一模型,采用了包含视觉、情感、预测等多个协作 Agent 的架构,模拟人类意识涌现的过程。
文章介绍了 Spark,一个轻量级的自进化智能体框架。Spark 旨在让开发者和创作者能够构建递归自我改进循环,通过“Domain Chips”(领域芯片)实现专业化与工具执行。作者受 Karpathy 和 Carmack 原则启发,推出了 Spark Researcher 运行时核心和加密交易领域芯片作为示例。该项目还即将推出名为 Spark Swarm 的集体进化网络,允许智能体相互分享、学习和进化。