Wiki 知识库

全部文档 / 标签: LLM as Judge

2 篇
清除

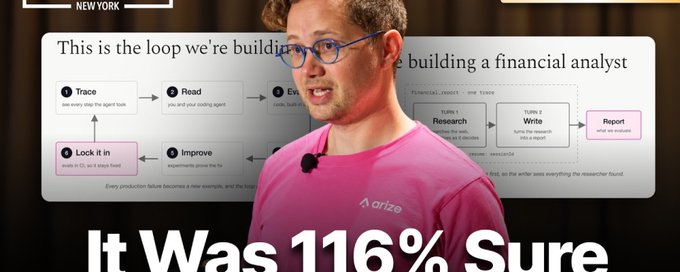
npm 创始人 Laurie Voss:如何判断你的 AI 智能体是否足够优秀

本文整理了 npm 联合创始人 Laurie Voss 在 AI Engineer 纽约 workshop 上关于 AI Agent 评估方法的分享。他从一份分析师共识加总为 116% 的特斯拉研报切入,阐述 trace(日志)与 eval(评估)的区别,强调先人工精读十几条记录再设计评估的重要性。文章详细介绍了从免费代码断言、LLM 裁判到黄金数据集校准裁判的完整评估体系,指出选择正确的评估问题比调优评估更重要,并以'评结果而非评步骤'为原则,演示了通过一行 prompt 修改将可操作性从 5/16 提升到 48/48 的案例。最后他强调将评估接入 CI、区分能力评估与回归评估,才能持续保证 Agent 质量。

技术 › Agent Saito 2026-10-278.6 KB 453 2 84

Top AI Papers of the Week (9月21日-9月27日)

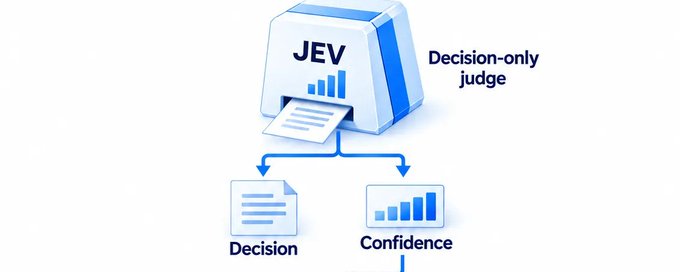
DAIR.AI 每周精选五篇 AI 论文:(1) 小米 MiMo 团队的 HySparse2 混合稀疏注意力架构,通过两级 KV 共享将百万 token 预填充成本降低至原方案的几分之一,同时提升长上下文检索精度;(2) MIT 与 Sakana AI 的 SIFT,用 LLM judge 加 Bradley-Terry 模型替代昂贵基准评估,将自改进智能体搜索成本降至约十分之一;(3) GAVEL 图世界模型,无需改动权重即将小模型长时程机器人任务成功率翻倍;(4) WFM Wiki 基础模型,针对 markdown 链接式长期记忆的图检索;(5) JEV 决策型 judge 模型,成本仅为 GPT-6 的约 1/277。

技术 › LLM DAIR.AI 2026-09-2816.0 KB 37.8K 146 80
