Wiki 知识库

全部文档 / 标签: 评估

13 篇
清除

npm 创始人 Laurie Voss:如何判断你的 AI 智能体是否足够优秀

本文整理了 npm 联合创始人 Laurie Voss 在 AI Engineer 纽约 workshop 上关于 AI Agent 评估方法的分享。他从一份分析师共识加总为 116% 的特斯拉研报切入,阐述 trace(日志)与 eval(评估)的区别,强调先人工精读十几条记录再设计评估的重要性。文章详细介绍了从免费代码断言、LLM 裁判到黄金数据集校准裁判的完整评估体系,指出选择正确的评估问题比调优评估更重要,并以'评结果而非评步骤'为原则,演示了通过一行 prompt 修改将可操作性从 5/16 提升到 48/48 的案例。最后他强调将评估接入 CI、区分能力评估与回归评估,才能持续保证 Agent 质量。

技术 › Agent Saito 2026-10-278.6 KB 453 2 84

AI 落地的四道坎 -- 本体、评估、信任、维护 | 峰会洞察 02

本文是硅谷101 Alignment 峰会 Day 1 下半场的深度纪要,总结出 AI 落地的四道坎:本体、评估、信任、维护,且四道坎都不在模型本身。机器人领域模型大小被物理参数封顶,数据质量与多样性之争可统一为数据金字塔,触觉数据与跨本体抽象是关键;世界模型定义仍在发散,AMD 收购 World Labs 释放垂直整合信号,评估工具的缺失是最大短板;Agent 的真正瓶颈是信任而非模型,企业需渐进开放权限,云端 agent 基础设施有大量脏活,交互范式需摆脱聊天框。作者结合一线信号给出创业与投资判断。

技术 › Agent Cloris 2026-10-1388.1 KB 8.2K 22 82

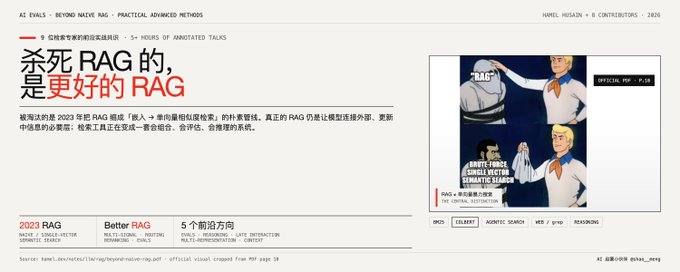
杀死 2023 RAG 的,是更好的 RAG:9 位检索专家的前沿实战共识「Beyond Naive RAG」

本文介绍 Hamel Husain 主编的演讲合集《Beyond Naive RAG》,汇集 9 位一线检索专家的共识:朴素 RAG(切块+单向量+余弦检索)已失效,但检索增强生成本身远未死亡。全书论证三条主线:长上下文不能替代检索(Context Rot 证明上下文越长模型越不可靠);评估先于优化(公开基准已污染,须建自有黄金数据集);复杂性不是目的(慎用图数据库等过度工程)。涵盖 ColBERT 后期交互、推理增强检索(Promptriever、Rank1)、多重表示与智能路由、FreshStack 评估指标等前沿方法,提出'评估驱动+多表示+推理增强+克制架构'的实践观。

技术 › LLM meng shao 2026-10-1211.9 KB 4.7K 43 84

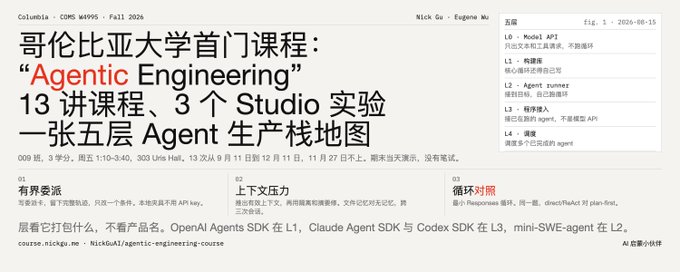
哥伦比亚大学首门 Agentic Engineering 课程解读

文章介绍哥伦比亚大学 2026 秋季首门 Agentic Engineering 课程(COMS W4995-009),其核心立场是:Agent 本质是包裹模型的软件工程(harness),而非模型本身。课程分基础、架构、设计与生产化、期末项目四个模块共 13 讲,配备三个重实践的 Studio 实验:委托与可观测运行、长上下文压力测试与记忆架构、Agent 循环受控对比。文章还解读了课程的五层 Agent 生产栈分类法(L0 模型 API 到 L4 协调系统)与六大学习目标,认为该课将喧闹的 AI Agent 话题还原为可严肃讲授的工程学科,其课程网站和 Studio 设计即使不选课也值得从业者研读。

技术 › Agent meng shao 2026-09-2613.5 KB 13K 133 85

LLM-as-Judge Architectures: Putting Evals Into Your Agent Runtime

文章探讨将 LLM-as-Judge 从离线评估工具迁移到 Agent 运行时架构中的趋势。传统确定性软件可通过类型检查、断言等方式验证结果,而 AI 应用输出往往需要判断性评估,LLM judge 能让应用自我完成这些判断。作者介绍了几种常见模式:使用另一个模型(包括专用小型评估模型以降低成本)、将大而模糊的判断拆解为多个小判断并用 DAG 结构组合、用成对比较代替打分以规避位置偏差、在 Agent 工作过程的关键节点(如检索、方案选择)设置检查点而非仅评估最终答案,以及使用多评委投票、辩论等机制提升可靠性。

技术 › LLM Josh Rosen 2026-09-0913.2 KB 90.3K 681 77

什么是 Eval?为什么它决定了 AI 项目能不能真正落地

文章系统讲解了 Eval(评估)在 AI 工程中的核心地位。作者将 Eval 比喻为'给 AI 考试',介绍了构成评估闭环的关键要素:Golden Set(考题库)、Rubric(评分标准)、评分方式(规则、人工、LLM-as-a-Judge)和 Eval Report(成绩单)。文章指出没有 Eval 的 AI 开发容易沦为'凭感觉调 Prompt',无法回答版本是否真的提升、幻觉率是否下降等关键问题。作者强调 AI 项目应遵循 Build → Eval → Analyze → Improve 的迭代流程,Eval 是 AI FDE 的核心能力,'能运行'和'可交付'之间隔着一套完整的评估体系。

技术 › LLM Builder 2026-08-2814.6 KB 30.8K 290 78

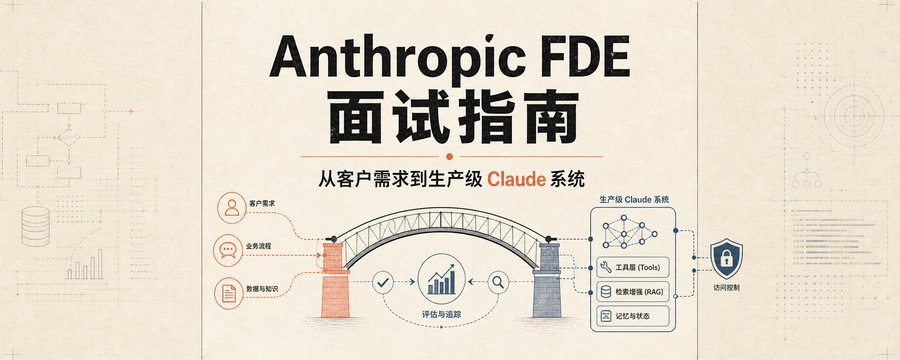
Anthropic FDE(Forward Deployed Engineer)面试指南

本文翻译并评述了 Chill Interview 的 Anthropic FDE 面试指南。FDE 岗位要求候选人同时具备生产级工程能力、Claude 与智能体系统能力、客户需求梳理能力、安全与可靠性意识,以及在不确定环境中自主推进的能力。文章详细拆解了面试流程各环节(简历筛选、招聘初筛、技术编程轮、Applied AI 构建轮、客户需求访谈、系统设计、价值观面试等)的考察重点、常见题型、评分点与备考建议,并强调候选人要避免表现得像「只会做 AI 演示原型的人」,需能交付经得起企业现实考验的生产系统。

技术 › Agent DuoRou Liu 2026-08-2627.5 KB 3.4K 18 85

Inside an Applied AI company

本文深入探讨了应用型AI公司的核心运作模式,以保险行业为例,阐述了从初始70%准确率到承诺98% SLA的差距如何通过工程、GTM和应用AI团队的协作来弥合。文章强调了“harness”作为产品的重要性,包括工具、集成、文件系统、编排和监管五个方面,并指出评估(evals)作为平台核心原语的关键作用。作者认为,应用型AI公司通过紧密的客户反馈循环和垂直领域的深度整合,构建了难以复制的竞争优势,而非传统的数据护城河。

技术 › Agent Adithya Sanjay 2026-08-129.5 KB 68K 182 72

AI 开始优化 AI 自己的生产线了:Superpowers 6

本文通过 Superpowers 6 的案例,指出 AI 已突破代码生成,开始具备流程优化与管理能力。AI 审计并改进了自己的工作流,实现了降本增效。文章强调,在 AI 自动化“判断力”的时代,人类的核心价值已从操作机器转向构建诚实可靠的评估系统,即在幻觉与自我欺骗面前,坚持用 Eval 记分牌揭示真相。

技术 › LLM DataDan 2026-07-056.5 KB 9.6K 35

AI 工程评估方法详解:Manual、Code 与 LLM-as-a-judge

文章阐述了 AI 工程闭环中评估环节的重要性,详细介绍了手动评估、基于代码的确定性评估以及 LLM-as-a-judge 三种主要方法。作者建议从手动审查开始建立直觉,逐步定义并自动化具体的失败模式。文章还探讨了基于参考与无参考评估的区别,并强调应结合多种方法,优先使用二值评分以确保评估的清晰性与可靠性。

技术 › LLM Lotte 2026-05-208.8 KB 40.9K 417 83

Designing eval datasets for LLM applications

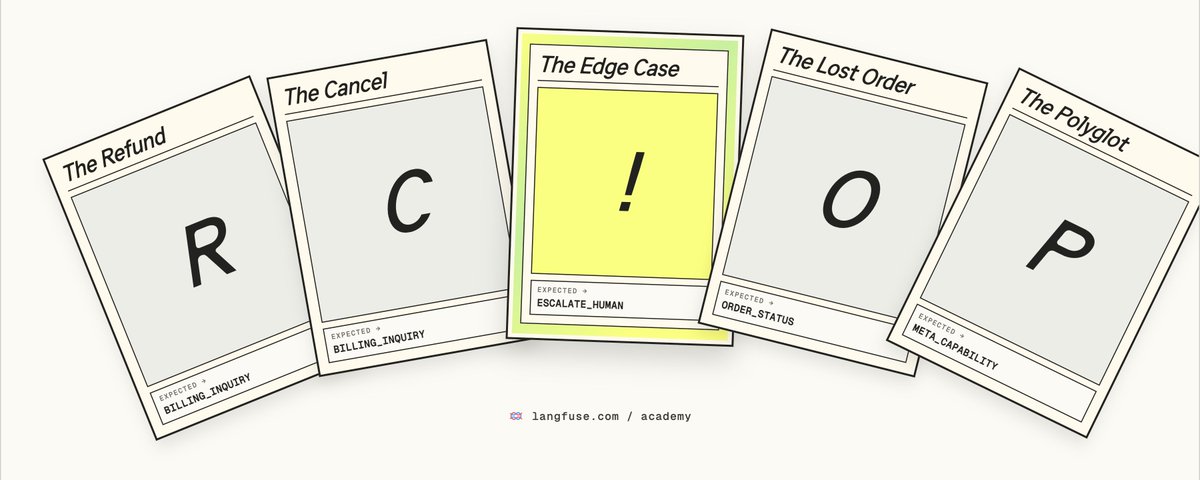
本文是 Langfuse Academy 系列的一部分,深入探讨了 AI 工程生命周期中的数据集设计。文章解释了数据集如何连接生产监控与开发迭代,详细介绍了数据集项的三个核心字段(输入、期望输出、元数据)及不同的评估模式。此外,文章还分享了构建高质量数据集的最佳实践,包括如何定义范围、确定规模,以及如何从生产 Trace、手工编写和合成数据中起步。

技术 › LLM Lotte 2026-05-186.3 KB 39.8K 321 80

编写 Agent Skills 的 8 个技巧

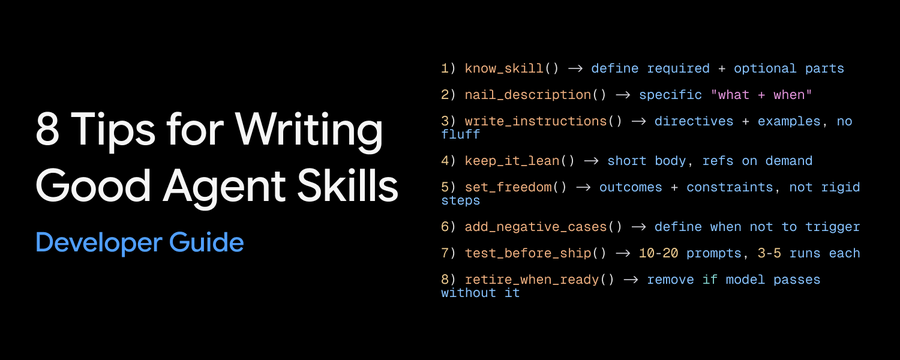
本文是 Philipp Schmid 关于如何编写高效 AI Agent Skills(技能)的实用指南。文章指出技能虽然灵活但难以掌握,并提出了 8 个核心建议:明确技能定义(能力型 vs 偏好型)、精确描述触发条件、编写指令而非冗长文章、保持内容精简、给予 Agent 适当的自由度而非死板的步骤、定义负向触发条件、通过多轮测试评估效果,以及当模型能力提升时及时淘汰冗余技能。

技术 › Agent Philipp Schmid 2026-04-1414.2 KB 83.6K 527 84