Wiki 知识库

全部文档 / 标签: 稀疏注意力

9 篇
清除

读 2.83% 的 key 就够了

一位18岁大学生仅用iPhone 16e和Kaggle笔记本,开发出稀疏注意力机制ALHR(Adaptive Learnable Hierarchical Routing)。该方法通过给key矩阵构建静态二叉树,配合预算预测器、邻居搜索和树下降三步推理,让每个query只读取所需key。在1024 token的MQAR测试中,仅读取2.83%的key即可达到92.1%准确率(稠密基线94.9%),KV压缩35.3倍。训练分三段:先训稠密教师模型,再用其注意力矩阵标注top-k key训练树模块,最后无教师联合训练。目前因未做kernel优化比稠密注意力慢约10倍,代码由Claude Sonnet 5.5生成,Apache-2.0开源。

技术 › LLM yibie 2026-10-105.0 KB 1.3K 2 76

Top AI Papers of the Week (9月21日-9月27日)

DAIR.AI 每周精选五篇 AI 论文:(1) 小米 MiMo 团队的 HySparse2 混合稀疏注意力架构,通过两级 KV 共享将百万 token 预填充成本降低至原方案的几分之一,同时提升长上下文检索精度;(2) MIT 与 Sakana AI 的 SIFT,用 LLM judge 加 Bradley-Terry 模型替代昂贵基准评估,将自改进智能体搜索成本降至约十分之一;(3) GAVEL 图世界模型,无需改动权重即将小模型长时程机器人任务成功率翻倍;(4) WFM Wiki 基础模型,针对 markdown 链接式长期记忆的图检索;(5) JEV 决策型 judge 模型,成本仅为 GPT-6 的约 1/277。

技术 › LLM DAIR.AI 2026-09-2816.0 KB 37.8K 146 80

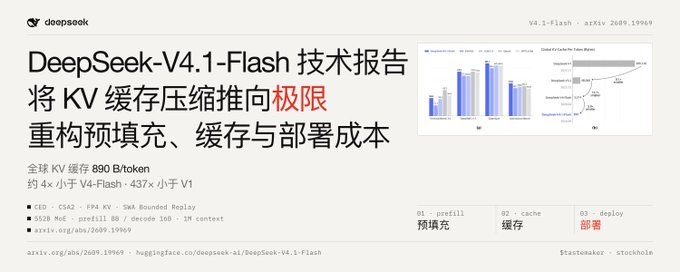
DeepSeek-V4.1-Flash 技术报告:将 KV 缓存压缩推向极限,重构预填充、缓存与部署的成本结构

本文深度解读 DeepSeek-V4.1-Flash 技术报告,该模型通过 CED 不对称编码器-解码器架构、CSA2 跨层稀疏注意力复用、FP4 主 KV 量化及 SWA Bounded Replay 近似恢复四项设计,将常驻 HBM 的全局 KV 缓存降至 890 bytes/token(约为上一代四分之一),持久化缓存降至八分之一。文章详细解析各项技术的原理与协作机制,澄清了对压缩数字的常见误读,评估模型能力变化,并与 PagedAttention、MiniCache 等已有 KV 压缩路线对比,指出该工作将缓存压缩从算法点推进为面向百万 token 长程 agent 场景的系统级共同设计,同时讨论其证据强度与局限。

技术 › LLM meng shao 2026-09-1921.7 KB 7K 25 82

DeepSeek V4.1 Flash:架构学习笔记

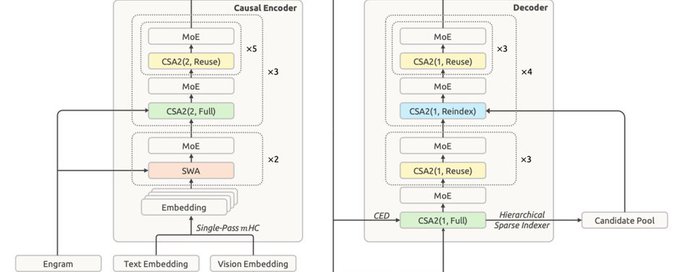
本文是 DeepSeek V4.1 Flash 的架构学习笔记。文章详细解析了其 Causal Encoder-Decoder(CED)结构,该结构通过前后半段网络的不对称计算减少长输入处理成本。核心创新在于 KV 缓存压缩:通过 CSA2 跨层共享全局 KV、FP4 量化、分层稀疏检索以及 SWA 有界回放等设计,将全局 KV 降至约 890 字节/token,持久化缓存约为上一代的 1/8。文章还讨论了这些设计如何协同工作,使长上下文在 Agent 场景下更可负担。

技术 › LLM AI Dance 2026-09-1113.1 KB 21.3K 203 79

GLM 5.3: Scaling with Post-training, Intuitively Explained

文章解析了 GLM-5.3 如何在不重新预训练的情况下,仅通过规模化后训练(RL)超越 GLM-5.2,印证了 Sutton 的苦涩教训。重点包括:一是面向真实专家工作的环境设计,用研究代理生成长时程任务,配合严格的验证器三重检查防止 reward hacking;二是沿用 GLM-5.2 的 MoE 架构(744B 总参、~40B 激活),采用 MLA 压缩 KV cache、DeepSeek 稀疏注意力降低长上下文成本、MTP 投机解码平均每次接受约 4.5 个 token,以及 IndexShare 在相邻层共享索引实现 2.9 倍 FLOPs 节省;三是 SAO 算法与 slime 基础设施,将低廉的 rollout 转化为稳定的大规模后训练。

技术 › LLM Alex Ker 2026-08-2913.2 KB 103.9K 410 77

GLM-5.3-Flash 发布:多模态大模型,开始真正“看着自己干活”了

文章介绍了智谱 GLM-5.3-Flash 模型的发布。该模型总参数量 320B、激活 18B,采用稀疏与线性注意力混合架构,注意力计算量降低 3 倍,支持 1M 上下文。作为 GLM-5 系列首个原生多模态模型,其最大亮点是视觉能力被直接纳入 Coding 循环,模型可观察网页截图、渲染结果和交互反馈,自主发现并修正问题,实现“生成—检查—迭代—交付”的完整闭环。文章还展示了其在游戏开发、3D 建模、办公文档和法律金融场景的应用,并给出 API 使用细节,认为大模型竞争正从回答质量转向完整工作的交付质量。

技术 › LLM Smartpig 2026-08-276.8 KB 6.5K 11 77

一文科普 主流 LLM 注意力机制

本文系统科普了主流LLM的注意力机制,指出其并非简单的单线升级,而是可组合的四个维度:KV缓存表示、注意力连接范围、序列混合器及位置稳定化技术。文章详细解析了MHA、MQA、GQA、MLA等机制对显存带宽的影响,以及全注意力、稀疏注意力、线性注意力等在降低长序列计算复杂度上的权衡。最后通过对比DeepSeek、Qwen、Kimi等代表模型,澄清了常见误区,为机制选择提供了准确的技术指导。

技术 › LLM 山景城小路 2026-08-1021.7 KB 8.6K 41 88

企业 AI 的真相:从列表记忆到图谱记忆

文章通过资深员工离职导致“组织记忆”流失的案例,剖析了当前企业 AI 协作工具的痛点。作者指出,主流的列表式记忆和密集注意力机制难以承载企业的核心决策上下文,而 Tanka 采用的图谱式记忆和稀疏注意力机制,通过构建实体关系网络,实现了真正的“组织记忆”沉淀。文章从技术架构、成本模型及适用场景三个维度,论证了为何这一路径是解决企业知识管理的未来方向。

技术 › Agent Berryxia.AI 2026-05-1510.6 KB 14.8K 43 78