Wiki 知识库

全部文档 / 标签: 内存优化

3 篇
清除

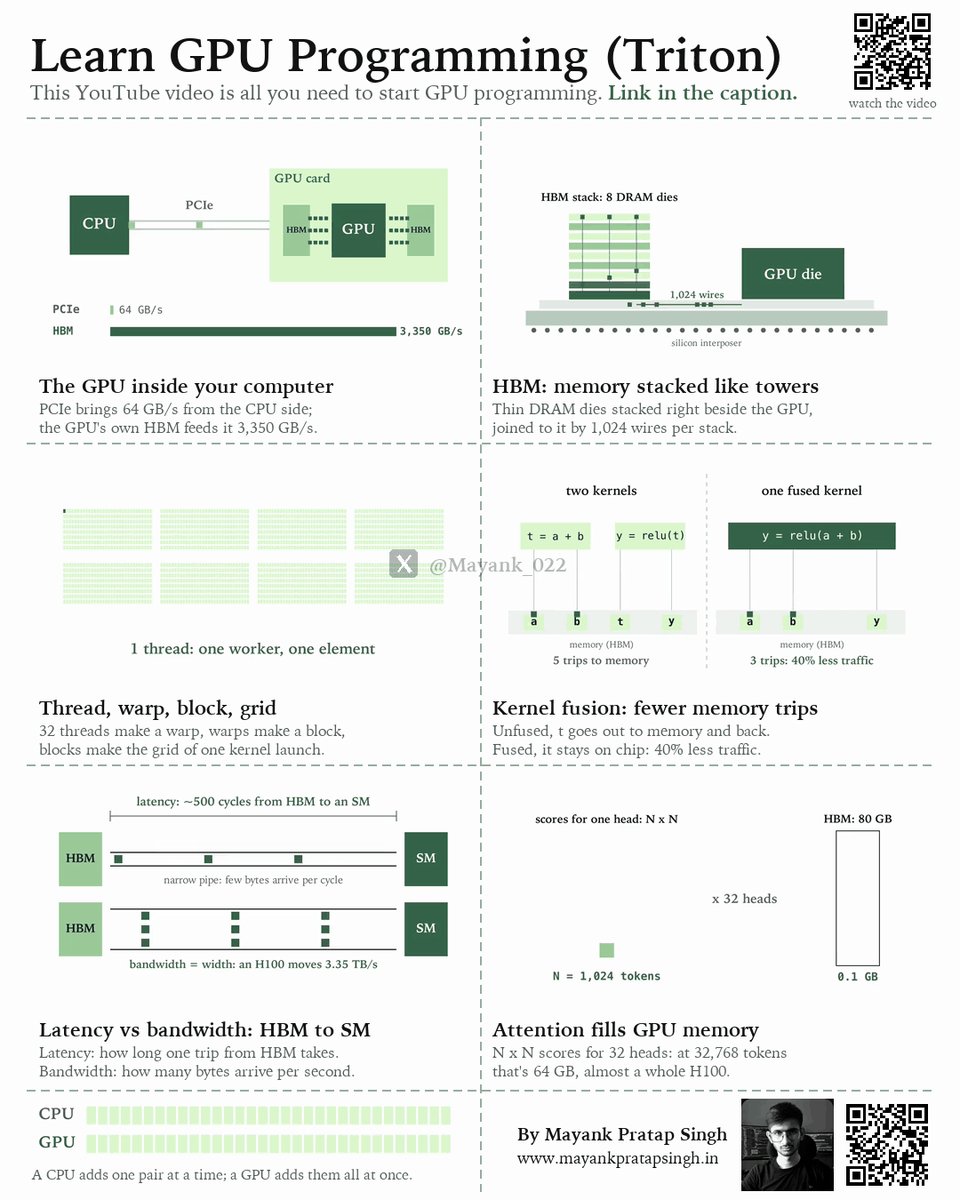
用一部全动画视频开始学习 GPU 编程(Triton 系列)

作者发布了一个全动画形式的 GPU 编程系列讲座首集,时长约一小时,通过可视化方式讲解 GPU 工作原理。内容涵盖:GPU 在计算机中的位置(PCIe、NVLink、集群)、NVIDIA H100 内部结构(SM、张量核心、共享内存)、线程/warp/block/grid 概念、内存体系(SRAM、DRAM、HBM、缓存)、延迟隐藏与核融合等优化技术,以及 Triton 的设计理念。还介绍了 FlashAttention 如何优化注意力计算。讲座无需 CUDA 或硬件背景,后续将推出 Triton kernel 编写和推理优化等课程。

技术 › 编程语言 Mayank Pratap Singh 2026-10-053.0 KB 56

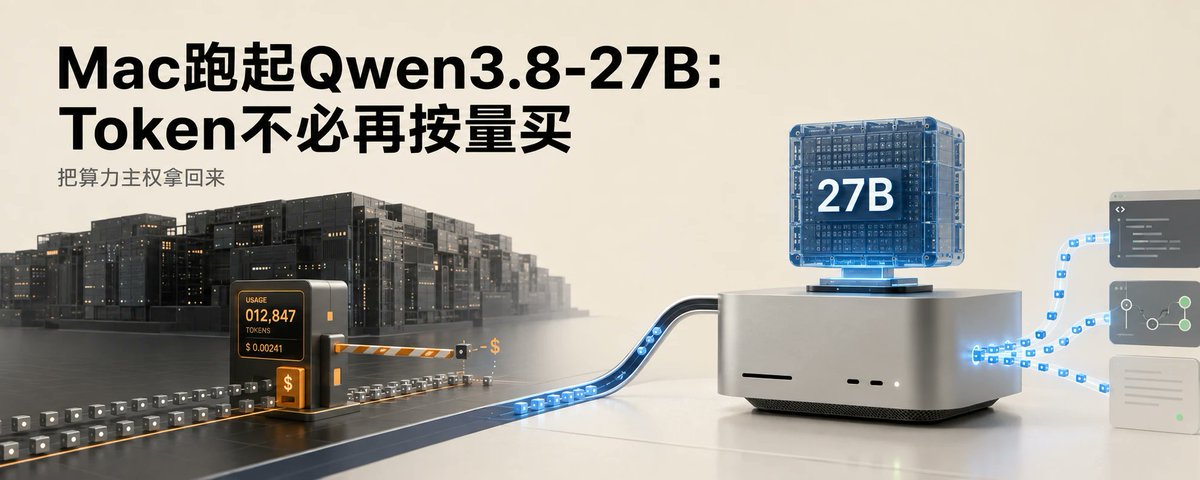
从零安装Qwen3.8-27B:Mac本地部署与性能调优指南

本文详细介绍了如何在 Apple Silicon Mac 上从零部署 Qwen3.8-27B 模型。作者苏乐指出,普通 Mac 无需升级到最新 Mac Studio 即可运行该模型,关键在于算清内存账:模型权重、上下文缓存、运行缓冲、草稿模型和系统开销共享统一内存。文章对比了 4-bit、8-bit 和 BF16 量化版本的选择建议(24GB/32GB 选 4-bit,48GB/64GB 可选 8-bit),并提供了完整的部署流程:使用 uv 管理环境、通过 hf 命令下载模型、先测 baseline 速度再逐步开启优化。文章还解释了 DFlash 2 投机解码加速原理——通过轻量草稿模型并行提出候选 token,再由主模型验证,从而显著提升生成速度。

技术 › LLM 苏乐 2026-09-0137.3 KB 435.7K 623 85

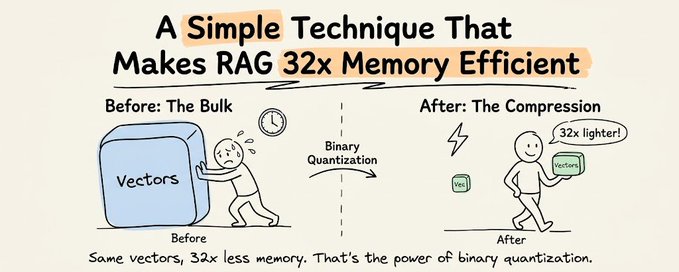
如何提高 RAG 32x 的内存效率(附代码说明)

本文介绍了利用二进制量化技术将 RAG(检索增强生成)系统内存效率提高 32 倍的方法。作者以 Perplexity 和 Azure 为例,详细展示了如何使用 Llama Index、Milvus 向量数据库和 Groq 托管的 Kimi-K2 模型构建系统。该系统可在 30 毫秒内查询 3600 万个向量,并在 1 秒内生成响应。文章提供了从数据加载、生成二值嵌入、向量索引到检索生成的完整代码实现。

技术 › LLM Avi Chawla 2026-04-055.4 KB 854.4K 907 78