Wiki 知识库

全部文档 / 标签: Scrapling

2 篇
清除

AI Agent 现在几乎可以从整个互联网抓取数据了

文章介绍了三个 GitHub 开源工具,让 AI Agent 几乎可以从整个互联网抓取数据。Agent-Reach 将 X、YouTube、Reddit、GitHub 等平台整合到一个入口;Patchright Enhanced 基于 Playwright 监听网站请求,即使网站没有 API 也能通过脚本提取数据;Scrapling 是面向任意网页的通用自适应抓取框架。用户只需告诉 Agent 想要什么数据,Agent 会自动编写代码、完成采集并返回结果,例如分析 X 账号帖子话题表现、收集 Reddit 和 YouTube 上的产品评价等,相当于给 Agent 装上了读取整个互联网的眼睛。
技术 › Agent AI Will (@FinanceYF5) 2026-10-032.6 KB 63

AI爬虫:让Agent真正“看见”世界

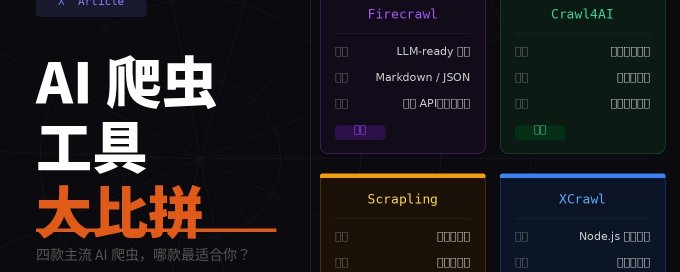
文章阐述了传统爬虫与AI爬虫的区别,指出AI爬虫能渲染JS、绕过反爬并提供LLM友好的Markdown/JSON数据,是Agent实现决策闭环的关键。文章详细介绍了Firecrawl、XCrawl、Scrapling及Crawl4AI这四款工具,分析了它们的优势、劣势及实战应用场景,旨在帮助开发者选择合适的工具以强化AI Agent的数据获取能力。

技术 › Agent omegaAI 2026-05-023.7 KB 35.9K 84 69