Crawl4AI:7万星开源神器把网页秒变LLM能吃的干净Markdown
文章介绍了一款名为 Crawl4AI 的开源爬虫工具,GitHub 星标超 7 万。该工具专为 RAG 和 Agent 设计,能将网页快速转换为干净的结构化 Markdown 数据。其特点包括零 API Key、异步浏览器池、智能去噪、支持 CLI/Docker 部署以及强大的反爬策略,被视为构建 LLM 数据管道的利器。
文章介绍了一款名为 Crawl4AI 的开源爬虫工具,GitHub 星标超 7 万。该工具专为 RAG 和 Agent 设计,能将网页快速转换为干净的结构化 Markdown 数据。其特点包括零 API Key、异步浏览器池、智能去噪、支持 CLI/Docker 部署以及强大的反爬策略,被视为构建 LLM 数据管道的利器。
文章推荐了10个用于全网数据采集和规避反爬虫策略的优质GitHub仓库。这些工具包括Firecrawl、Crawl4AI、browser-use等,涵盖了网页爬取、数据清洗、模拟真人操作、指纹伪装及移动端控制等功能,旨在帮助用户高效获取AI训练所需的干净数据。
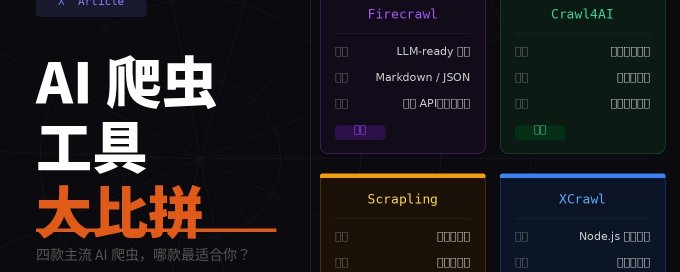
文章阐述了传统爬虫与AI爬虫的区别,指出AI爬虫能渲染JS、绕过反爬并提供LLM友好的Markdown/JSON数据,是Agent实现决策闭环的关键。文章详细介绍了Firecrawl、XCrawl、Scrapling及Crawl4AI这四款工具,分析了它们的优势、劣势及实战应用场景,旨在帮助开发者选择合适的工具以强化AI Agent的数据获取能力。