Wiki 知识库

全部文档 / 标签: 数据采集

14 篇
清除

花两千踩坑四大 Personal Agent,我用 3 个提示语把 33% 成功率救活了

作者花费两千元和两周时间实测 Google Muse、Grok Bot、OpenAI Dots、Manus Cue 四大 Personal Agent,测了 12 个自媒体平台的数据采集,最终成功委托率仅 33%。文章指出 Personal Agent 无法完全替代本机,存在账号登录、多任务管理等问题。作者最终选择 OpenAI Dots 作为云端方案,配合本机 Codex,总结出三个核心提示语:多任务进度条追踪、Computer Use 六道门采集验证、云端融合日报生成,并分享了邮件自动分拣回复、飞书文档中转等实用技巧,搭建了一套覆盖数据采集、日报和 AI 选题的完整工作流。

技术 › Agent 卡尔的AI沃茨 2026-10-1914.5 KB 17.4K 92 84

MediaCrawler:约 65K Star,七个平台公开数据一键采

文章介绍了开源爬虫项目 MediaCrawler(约 64.8K Star),该项目自 2023 年 6 月持续维护至今。其核心思路是绕开接口签名加密,基于 Playwright 浏览器自动化,在登录态下让浏览器自行计算签名,并默认使用 CDP 模式连接用户本机 Chrome,复用已有登录状态。项目支持小红书、抖音、快手、B站、微博、贴吧、知乎七个平台,可按关键词搜索、指定 ID 采集,支持评论楼中楼、作者主页监控、词云生成、多格式存储(CSV/JSON/SQLite/MySQL 等)及 WebUI。作者提醒注意账号风控、开源版功能边界、非商用协议及平台改版风险,认为该工具适合做选题素材采集和学习浏览器自动化,但强调只采公开数据、合规使用。

技术 › 工具与效率 北衡 2026-10-185.3 KB 1.2K 18 82

AI Agent 现在几乎可以从整个互联网抓取数据了

文章介绍了三个 GitHub 开源工具,让 AI Agent 几乎可以从整个互联网抓取数据。Agent-Reach 将 X、YouTube、Reddit、GitHub 等平台整合到一个入口;Patchright Enhanced 基于 Playwright 监听网站请求,即使网站没有 API 也能通过脚本提取数据;Scrapling 是面向任意网页的通用自适应抓取框架。用户只需告诉 Agent 想要什么数据,Agent 会自动编写代码、完成采集并返回结果,例如分析 X 账号帖子话题表现、收集 Reddit 和 YouTube 上的产品评价等,相当于给 Agent 装上了读取整个互联网的眼睛。

技术 › Agent AI Will (@FinanceYF5) 2026-10-032.6 KB 63

新媒体分析器 New Media Analyzer 发布!内容创作与分析竞品利器!

作者冰河发布了一款免费开源的新媒体分析工具,帮助内容创作者分析竞品账号。该工具支持抖音、公众号、小红书三个平台的博主数据采集,可将作品数据和口播文案整合,并借助大模型(如 Deepseek、GPT、Claude)进行 AI 拆解分析,揭示爆款内容的底层逻辑,包括钩子开头、选题思路等。文章详细介绍了工具的安装配置(macOS/Windows)、语音转写方式(本地模型或火山引擎 ASR)、红狐 Hub API 采集、账号采集操作、数据大盘和博主管理等功能。工具支持续采、去重、报告重算和 JSON 导出,B站与油管采集功能后续推出,供个人学习使用、禁止商用。

技术 › 工具与效率 冰河 2026-09-1311.7 KB 16.4K 42 76

一个脚本过一夜就能做完的事,Axis Robotics 花了 1200 万美元

文章批评 Axis Robotics 融资1200万美元、雇人用鼠标在浏览器遥操作仿真机械臂采集五万条数据集的做法。作者指出利用已发表的演示增强技术(350-400倍扩增率),同样数据仅需约130条真实演示即可生成,每条数据成本高达240美元,且存在物理与动作统计的双重分布位移。文章提出'验证比生产更便宜'的信息市场定律,批评按条计酬会催生'劣质数据驱逐优质数据'的格雷欣法则,并介绍Stonk Robotics基于方案(程序化策略)而非轨迹的替代设计,主张购买判断、评测等无法被制造的东西。

投资 › 加密货币 StonkRobotics 🤖 2026-09-0633.0 KB 743 5 89

开源抖音视频逐字稿批量导出 Skill

作者介绍了基于豆包工作 APP 开源的一个 Skill,可一句话批量导出抖音视频逐字稿。只需提供抖音博主主页链接,Skill 便能自动批量获取视频的公开信息(标题、点赞、评论、逐字稿等),并借助豆包内置的逐字稿获取能力,省去下载视频、提取音频和 ASR 转写等繁琐步骤。数据可写入飞书多维表格,还能由 AI 自动生成选题方向和主题总结。作者实测采集 10 条视频仅需约 5 分钟,已采集 100 多个视频仅消耗月额度 6%。开源地址在 GitHub 的 social-media-data-tools 仓库。

技术 › Skill 金尘马 2026-08-275.4 KB 152.3K 548 76

10个强大的开源GitHub网络爬虫仓库推荐

本文分享了10个极其强大的GitHub开源爬虫与数据采集项目,如Firecrawl、Crawl4ai、Browser-use和Scrapy等。这些工具涵盖了自动化渲染、网页转Markdown、AI智能体操控浏览器、隐形反反爬及移动端数据抓取等功能。借助这些免费开源的工业级框架,开发者能够高效、低门槛地获取互联网各处的结构化数据,实现媲美昂贵商业付费API的采集效果。

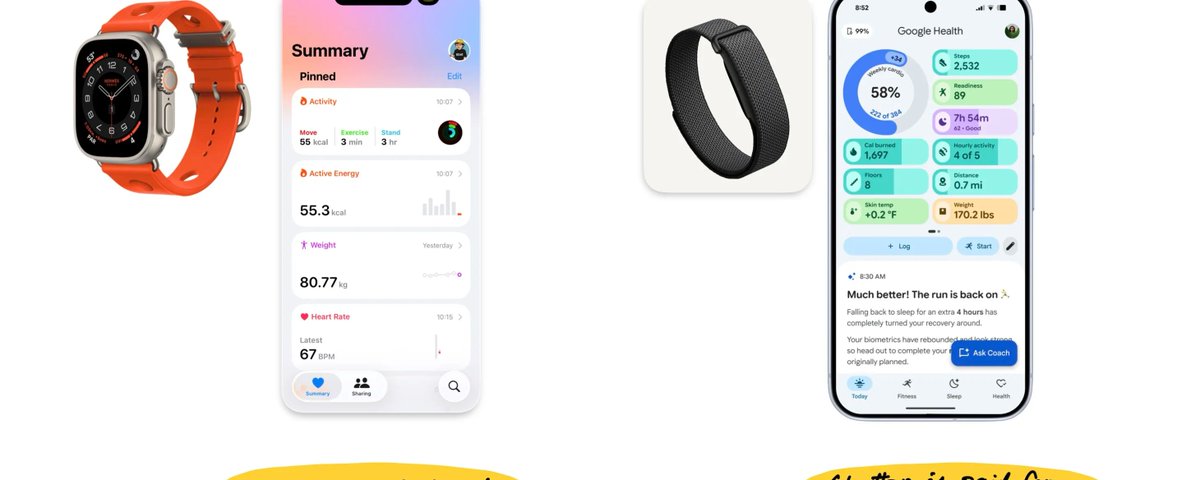
我戴了三周 Fitbit,终于看懂了 Apple 和 Google 的健康生意

作者通过三周佩戴 Fitbit 对比 Apple Health 和 Google Health,发现前者安静克制,后者主动互动。这种差异源于不同的商业模式:Apple 依赖硬件生态,Google 则依赖数据和 AI 反馈。文章深入剖析了两者在数据采集、AI 教练设计及产品逻辑上的根本区别,并警示小团队不应盲目照搬,需找到适合自身的商业引擎。

技术 › 方法论 Bear Liu 2026-07-2216.1 KB 21.4K 47

想用Hermes和Openclaw白嫖全网数据又不想被反爬的收藏着10个仓库就够了

文章推荐了10个用于全网数据采集和规避反爬虫策略的优质GitHub仓库。这些工具包括Firecrawl、Crawl4AI、browser-use等,涵盖了网页爬取、数据清洗、模拟真人操作、指纹伪装及移动端控制等功能,旨在帮助用户高效获取AI训练所需的干净数据。

技术 › Openclaw 鸟哥 | 蓝鸟会 2026-07-012.8 KB

Claude Code 全网爬取指南:五款核心工具配置

本文介绍了如何通过配置五个关键开源项目和官方插件,赋予 Claude Code 强大的全网数据采集能力。内容涵盖社媒平台API对接、反爬虫对抗、浏览器自动化、人工辅助监工以及全自动联网接管等场景。作者提出了“从轻到重,够用就停”的配置原则,并展示了自动扒取课程、翻译字幕并归档的实战工作流。

技术 › Agent Echo ./ 2026-06-043.3 KB 163.7K 1.8K 79

公众号文章批量采集完全指南

文章详细介绍了5种批量采集微信公众号文章的方法,涵盖从淘宝代采、开源工具使用到API逆向工程。作者重点实战了通过逆向微信接口获取文章列表,并利用破解的API签名将内容批量转换为Markdown的技术方案,提供了完整的Python清洗脚本与防封控建议。

技术 › 工具与效率 百 百年 AI×SEO 2026-04-2610.6 KB 88