Wiki 知识库

全部文档 / 标签: 数据抓取

12 篇
清除

AI Agent 现在几乎可以从整个互联网抓取数据了

文章介绍了三个 GitHub 开源工具,让 AI Agent 几乎可以从整个互联网抓取数据。Agent-Reach 将 X、YouTube、Reddit、GitHub 等平台整合到一个入口;Patchright Enhanced 基于 Playwright 监听网站请求,即使网站没有 API 也能通过脚本提取数据;Scrapling 是面向任意网页的通用自适应抓取框架。用户只需告诉 Agent 想要什么数据,Agent 会自动编写代码、完成采集并返回结果,例如分析 X 账号帖子话题表现、收集 Reddit 和 YouTube 上的产品评价等,相当于给 Agent 装上了读取整个互联网的眼睛。
技术 › Agent AI Will (@FinanceYF5) 2026-10-032.6 KB 63

如何自动化获客(完整指南)

本文是一份自动化获客完整指南,介绍如何利用 AI agent(如 grok bot、hermes)和 skill 文件,为数字产品、本地实体生意或无产品者自动生成线索。核心方法:找到已付费人群,抓取公开数据,生成买家画像与广告素材,通过 whop ads 投放或渲染物业修复效果触达业主,最终将线索卖给企业。文章分三条 pipeline:数字线索、实体线索、线索变现,并说明 agent 负责寻找、画像、素材、渲染、外联等,仅少数环节需人工决策。

技术 › Agent Chris Everest(yibie 整理) 2026-09-1421.0 KB 13.8K 119 83

构建永不枯竭的外呼线索引擎:基于Google Maps的潜在客户挖掘流水线

文章介绍了一套自动化的销售线索挖掘系统,解决了传统数据商名单因被过度触达而疲劳的问题。系统每周爬取Google Maps全美本地服务商户数据,通过四信号评分模型(无团队页、无定价页、版权年份新、无营销技术栈)筛选新开业、欠发展的企业,再结合评论时间估算企业年龄,经三级联系人数据增强与邮箱验证后,用LLM(Claude Sonnet)基于4T/4P框架生成个性化邮件,并经QA门控推送到邮件营销平台。整个流水线部署在Railway上持久运行,支持断点续跑与余额监控。

技术 › 工具与效率 Troy 2026-08-2510.3 KB 45.8K 122 86

My SEO Tracking Tool Missed 2 of 4 AI Overviews. So I Tested What Actually Works.

作者对比了SemScraper和DataForSEO两个SERP API在捕获Google AI Overview方面的表现。通过7个查询的并行测试,发现SemScraper在4个有AI Overview的查询中全部捕获,而DataForSEO只捕获了2个。作者认为差异源于抓取时机,而非代码质量,并指出即使最昂贵的企业级工具(如Bright Data)也承认AI Overview捕获是概率问题。此外,文章还讨论了2026年2月和5月Google向追踪机器人提供伪造SERP的事件,强调依赖单一API的风险。最终,作者选择SemScraper,并建议用户不要盲目信任单一数据源。

利用 AI 智能体在 Reddit 上赚钱的完整指南

本文作者分享了如何利用 Reddit 社区和 AI 智能体实现日入千美元的变现策略。核心思路是“需求导向”:先通过 Reddit 挖掘用户反复提及且具有急迫性的真实痛点,而不是盲目开发产品。作者建议使用特定的提示词让大模型挖掘个人经验,并结合 Apify MCP 将抓取的 Reddit 数据喂给 Claude 进行深度需求分析。最后,利用 AI 根据用户真实用语编写 PDF 指南或付费新闻通讯,仅向急需解决问题的受众提供真正有价值的方案。

技术 › Agent Chris 2026-08-1019.8 KB 113K 588 83

10个强大的开源GitHub网络爬虫仓库推荐

本文分享了10个极其强大的GitHub开源爬虫与数据采集项目,如Firecrawl、Crawl4ai、Browser-use和Scrapy等。这些工具涵盖了自动化渲染、网页转Markdown、AI智能体操控浏览器、隐形反反爬及移动端数据抓取等功能。借助这些免费开源的工业级框架,开发者能够高效、低门槛地获取互联网各处的结构化数据,实现媲美昂贵商业付费API的采集效果。

跨境电商选品自动化:用 Hermes Agent + XCrawl 把半天工作压缩到 3 分钟

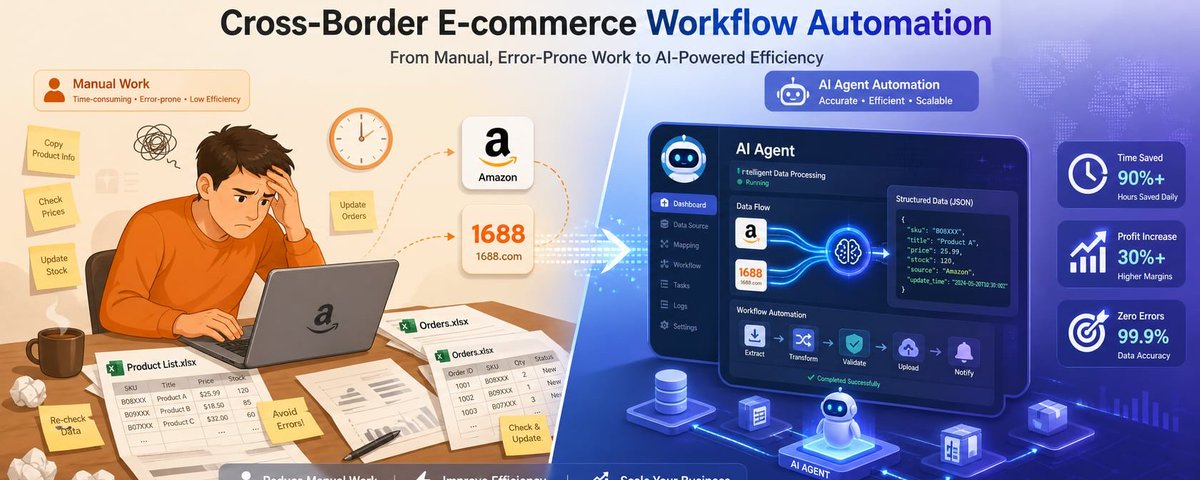
本文分享了一个利用 Hermes Agent 和 XCrawl 实现 Amazon 选品自动化的实战案例。通过抓取 Amazon 榜单数据并匹配 1688 货源,AI Agent 能在 3 分钟内完成利润计算与结构化分析,将传统需 4-6 小时的人工流程大幅压缩。文章详细解析了 API 调用细节、反爬虫应对策略及 ROI 计算,展示了工具与工作流结合的实战价值。

技术 › Hermes huangserva 2026-05-0815.2 KB 88.2K 211 90

AI爬虫:让Agent真正“看见”世界

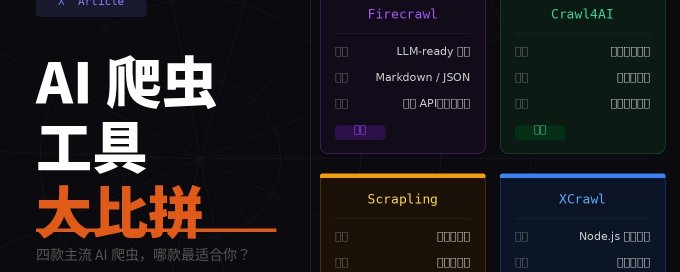
文章阐述了传统爬虫与AI爬虫的区别,指出AI爬虫能渲染JS、绕过反爬并提供LLM友好的Markdown/JSON数据,是Agent实现决策闭环的关键。文章详细介绍了Firecrawl、XCrawl、Scrapling及Crawl4AI这四款工具,分析了它们的优势、劣势及实战应用场景,旨在帮助开发者选择合适的工具以强化AI Agent的数据获取能力。

技术 › Agent omegaAI 2026-05-023.7 KB 35.9K 84 69

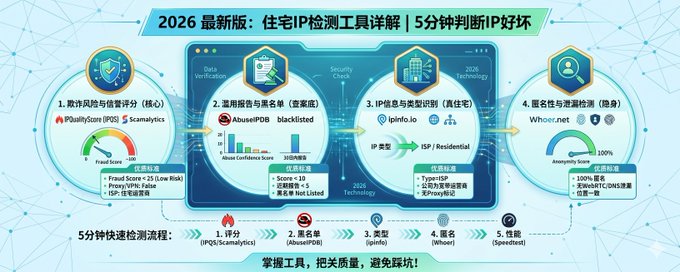
住宅IP检测工具详解:2026最新版,教你5分钟判断IP好坏

本文系统介绍了2026年最新的住宅IP检测工具与方法,旨在帮助用户筛选纯净、稳定的住宅IP。文章从欺诈风险评分(如IPQS、Scamalytics)、滥用报告(AbuseIPDB)、IP类型识别(ipinfo)、匿名性检测(Whoer)及性能测试五个维度进行详细解析。文中不仅提供了各项指标的具体合格标准(如欺诈分数<25),还总结了一套高效的5分钟快速检测流程,并建议结合指纹浏览器使用以确保IP质量。

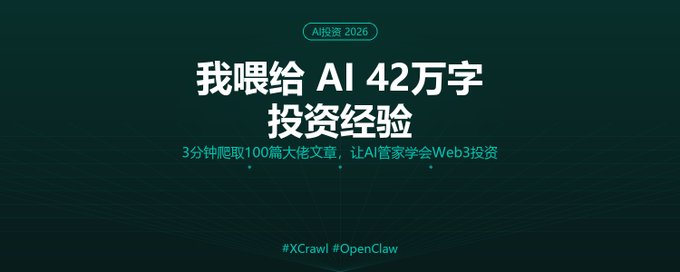
为了让 AI 管家学会交易,我直接爬取了 42万字投资大佬的文章喂给它

作者为了训练自己的 AI 管家“贾维斯”掌握 Web3 投资技能,利用 XCrawl 爬虫工具批量抓取了投资大佬 Chris Dixon 的 42 万字博客文章,并将其转化为干净的 Markdown 数据喂给 AI。文章详细介绍了从数据采集、清洗到 AI 学习框架构建的全过程,展示了如何利用 AI Agent 吸收专家知识并进行投资策略分析。

技术 › Agent 我真的没有拼多多 2026-03-2510.5 KB 68