10个强大的开源GitHub网络爬虫仓库推荐
本文分享了10个极其强大的GitHub开源爬虫与数据采集项目,如Firecrawl、Crawl4ai、Browser-use和Scrapy等。这些工具涵盖了自动化渲染、网页转Markdown、AI智能体操控浏览器、隐形反反爬及移动端数据抓取等功能。借助这些免费开源的工业级框架,开发者能够高效、低门槛地获取互联网各处的结构化数据,实现媲美昂贵商业付费API的采集效果。
本文分享了10个极其强大的GitHub开源爬虫与数据采集项目,如Firecrawl、Crawl4ai、Browser-use和Scrapy等。这些工具涵盖了自动化渲染、网页转Markdown、AI智能体操控浏览器、隐形反反爬及移动端数据抓取等功能。借助这些免费开源的工业级框架,开发者能够高效、低门槛地获取互联网各处的结构化数据,实现媲美昂贵商业付费API的采集效果。
文章推荐了10个用于全网数据采集和规避反爬虫策略的优质GitHub仓库。这些工具包括Firecrawl、Crawl4AI、browser-use等,涵盖了网页爬取、数据清洗、模拟真人操作、指纹伪装及移动端控制等功能,旨在帮助用户高效获取AI训练所需的干净数据。
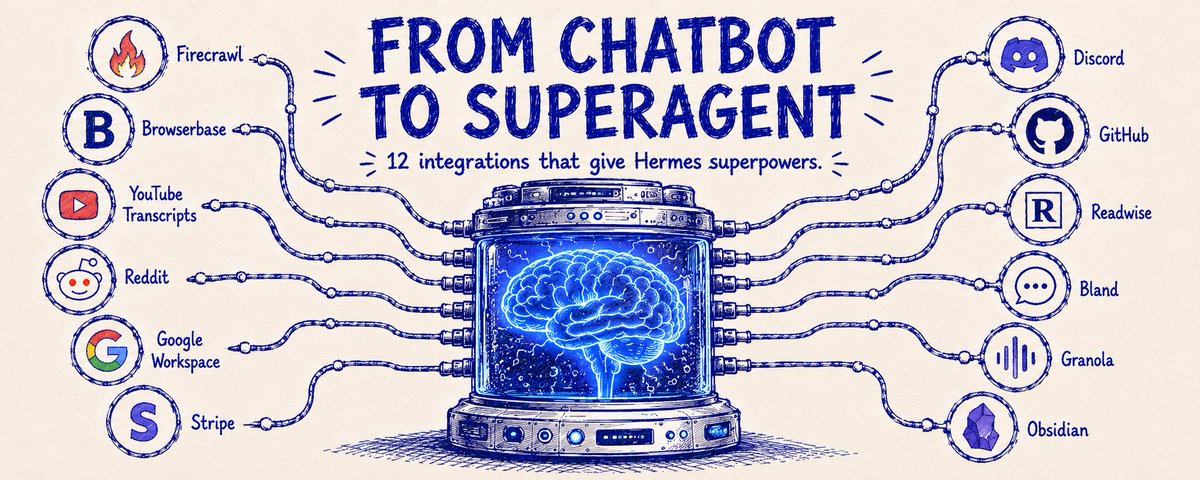
文章指出,Hermes本身只是一个被隔离的“大脑”,只有通过集成工具(感官和四肢)才能发挥威力。作者提出了将Hermes转化为超级智能体的四大任务类别:研究、行动、工作区(Workspace)和记忆,并详细介绍了12个核心工具(如Firecrawl、Browserbase、Stripe、Obsidian等)的具体应用。文章通过展示赞助商筛选、客户支持自动化等实际工作流,说明了多工具协同如何释放Agent的巨大潜能。
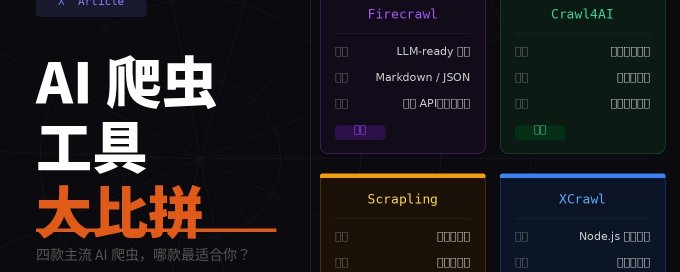
文章阐述了传统爬虫与AI爬虫的区别,指出AI爬虫能渲染JS、绕过反爬并提供LLM友好的Markdown/JSON数据,是Agent实现决策闭环的关键。文章详细介绍了Firecrawl、XCrawl、Scrapling及Crawl4AI这四款工具,分析了它们的优势、劣势及实战应用场景,旨在帮助开发者选择合适的工具以强化AI Agent的数据获取能力。
文章介绍了一款自建的网页抓取神器,通过Firecrawl、Jina和Playwright三层策略,能一键抓取微信公众号、知乎等任意网站内容,自动下载图片并转存Markdown到Obsidian本地,解决了网页复制格式乱和外链失效问题。