Wiki 知识库

全部文档 / 作者: 码良 / 标签: Anthropic

4 篇
清除

Agent 高频题 04. Agent 效果怎么评测:评测集怎么建、指标怎么定、怎么证明变好了

本文是 Agent 高频面试题详解系列第 4 题,系统讲解 Agent 效果评测体系。文章基于 64 场面试面经分析,归纳出评测追问的八个方向,并结合 Anthropic、OpenAI 等实践经验展开:先明确评什么(Agent 评测难在结果在环境状态中、路径不唯一、结果不确定);评测集怎么建(题目来自真实失败、业务方、合成数据,注意分层、防泄露与防过拟合);谁来打分(代码判分、模型判分、人工判分三种方式的取舍,LLM-as-a-Judge 的位置偏差、冗长偏差等已知问题及校准方法);以及如何通过基线对比、多次运行排除随机性,证明改进真实有效。文章强调评的是 Harness 和模型的整体,判结果而非规定路径。

技术 › Agent 码良 2026-10-2562.0 KB 5.1K 38 88

Agent 高频题 03. 为什么要多 Agent:怎么拆、怎么通信、结果谁汇总

本文是 Agent 面试高频题详解第 3 题,围绕多 Agent 架构展开。作者结合 50 位作者、63 场面试的面经,系统梳理了六个追问方向:要不要拆、怎么拆、怎么通信、结果谁汇总等。文章指出单 Agent 在上下文膨胀、工具过多、提示词分支复杂、无法并行四方面会卡住;同时多 Agent 有 token 成本(约为普通对话 15 倍)、协调开销、信息丢失和错误传播等代价。文中总结了主从、流水线、并行分片、执行加审查、按意图转交五种结构,以及上下文、工具权限、可验收三类拆分边界,并对比 Skill、MCP、Workflow、SubAgent 等概念的适用场景,最后给出通信方式与面试应答要点。

技术 › Agent 码良 2026-10-2350.2 KB 38.9K 148 84

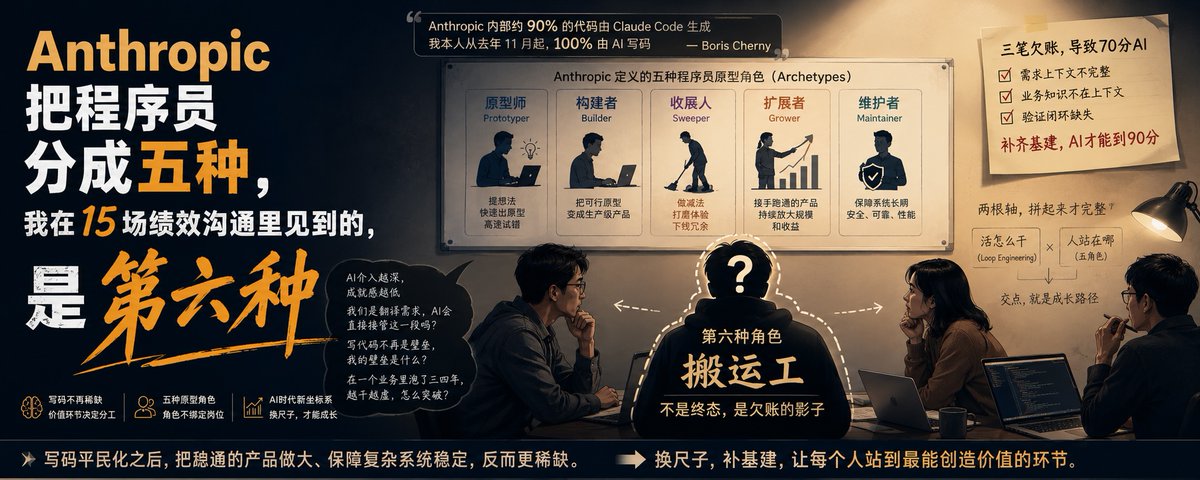
Anthropic 把程序员分成五种,我在 15 场绩效沟通里见到的,是第六种

文章讨论了 Anthropic 提出的程序员五种价值创造角色,并结合大厂团队的实际情况,提出了第六种角色“搬运工”。通过 15 场绩效沟通,作者分析了程序员在 AI 时代的焦虑与转型,指出解决之道在于补齐基建欠账和重新定义价值坐标。

技术 › Claude Code 码良 2026-08-0611.9 KB 4.6K 17

炸裂,Anthropic 给 Opus 5 删掉了 80% 的系统提示词

Anthropic 团队将 Claude Code 的系统提示词删减了 80%,但编码评测没有损失。文章指出,许多规则是为老模型打的补丁,已过时。最佳实践转向:用锚点代替禁令,用接口设计代替举例,以及渐进披露。建议开发者清理“拐杖”型规则,保留护栏与品味,用评测集支撑删除决策。

技术 › LLM 码良 2026-07-2514.6 KB 2.7K 15