Wiki 知识库

全部文档 / 标签: LLM-as-a-Judge

7 篇
清除

Agent 高频题 04. Agent 效果怎么评测:评测集怎么建、指标怎么定、怎么证明变好了

本文是 Agent 高频面试题详解系列第 4 题,系统讲解 Agent 效果评测体系。文章基于 64 场面试面经分析,归纳出评测追问的八个方向,并结合 Anthropic、OpenAI 等实践经验展开:先明确评什么(Agent 评测难在结果在环境状态中、路径不唯一、结果不确定);评测集怎么建(题目来自真实失败、业务方、合成数据,注意分层、防泄露与防过拟合);谁来打分(代码判分、模型判分、人工判分三种方式的取舍,LLM-as-a-Judge 的位置偏差、冗长偏差等已知问题及校准方法);以及如何通过基线对比、多次运行排除随机性,证明改进真实有效。文章强调评的是 Harness 和模型的整体,判结果而非规定路径。

技术 › Agent 码良 2026-10-2562.0 KB 5.1K 38 88

Jev-as-a-Judge for Agent Evaluations

本文介绍了如何使用 TypeSafe AI 的决策模型 Jev 作为 LLM Judge 来评估 Agent 的表现(Jev-as-a-Judge)。与只看最终回复不同,Jev 会阅读完整轨迹(用户请求、工具调用及结果、最终回复),将标准转化为预定义问题,并返回带置信概率的判定。文章通过退款 Agent 示例演示了 Playground 的使用,说明如何设定阈值将运行分为通过、失败和人工复核三类。研究显示,该接受-升级模式比 GPT-6 单独判断更准确且成本大幅降低。作者强调需先用人工标注验证 Jev 的可靠性,能用代码检查的事实性问题就不需要 Judge,将 Jev 保留给需要阅读理解的判断。

技术 › Agent elvis 2026-10-078.3 KB 92.7K 438 83

Use Jev to extract signals from millions of chat agent traces

本文介绍如何利用 Jev 类模型大规模分析数百万条聊天 Agent 生产轨迹,从中提取失败信号。传统 LLM-as-a-judge 评估依赖采样以控制成本,而 Jev 类模型可在同一上下文中并行回答多个问题,以极低成本对全部轨迹进行全面评估。文中讨论了显式反馈、行为追踪、事实结果和对话信号等不同类型的用户信号,并以航班改签客服对话为例,展示如何同时捕捉后续提问、用户挫败感和结果满意度等维度。文章最后介绍如何在 Langfuse 中配置基于 Jev 的批量评估模板,实现生产信号的监控与可视化。

技术 › LLM Annabell 2026-09-245.7 KB 59.9K 171 70

Will TypeSafe's Jev change how we build AI applications?

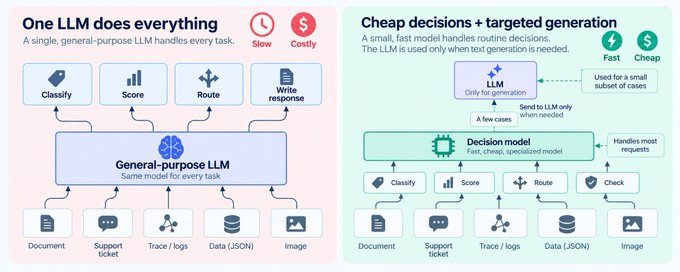
文章分析了 TypeSafe 发布的新模型 Jev——一种只能做分类、评分和路由决策、不能生成文本的'System One'模型。Jev 比通用 LLM 快 40-200 倍、便宜 40-400 倍,通过 RLCD 训练方法实现零样本概率判断。早期独立测试显示其准确率接近 GPT-5.6 等大模型,垃圾邮件分类甚至可媲美有标注训练的分类器。代价是失去了解释能力,无法说明判断理由。作者认为这可能改变 AI 应用架构:用 Jev 做大规模廉价监控评估,用 LLM 判官处理少量样本以获取改进方向信号。

技术 › LLM Aparna Dhinakaran 2026-09-1912.8 KB 15.2K 202 78

什么是 Eval?为什么它决定了 AI 项目能不能真正落地

文章系统讲解了 Eval(评估)在 AI 工程中的核心地位。作者将 Eval 比喻为'给 AI 考试',介绍了构成评估闭环的关键要素:Golden Set(考题库)、Rubric(评分标准)、评分方式(规则、人工、LLM-as-a-Judge)和 Eval Report(成绩单)。文章指出没有 Eval 的 AI 开发容易沦为'凭感觉调 Prompt',无法回答版本是否真的提升、幻觉率是否下降等关键问题。作者强调 AI 项目应遵循 Build → Eval → Analyze → Improve 的迭代流程,Eval 是 AI FDE 的核心能力,'能运行'和'可交付'之间隔着一套完整的评估体系。

技术 › LLM Builder 2026-08-2814.6 KB 30.8K 290 78

如何构建可持续维护的评估集

本文介绍了如何为AI Agent构建可长期维护的评估(eval)指标体系。指标分三类:目标指标、护栏指标和运营指标,三者结合使用。候选指标来源于错误分析和产品目标与硬约束。并非所有候选都值得跟踪:一次性问题用prompt修改解决即可,只有需要持续追踪的泛化问题才建指标;每个指标必须与具体决策挂钩,否则就是噪音。从零开始时,可先阅读30-50条trace并用自由文本笔记聚类失败模式。此外需定期重跑错误分析、退役失效指标,并警惕Goodhart定律导致的过拟合。

技术 › LLM Lotte 2026-08-198.4 KB 89.1K 476 83

AI 工程评估方法详解:Manual、Code 与 LLM-as-a-judge

文章阐述了 AI 工程闭环中评估环节的重要性,详细介绍了手动评估、基于代码的确定性评估以及 LLM-as-a-judge 三种主要方法。作者建议从手动审查开始建立直觉,逐步定义并自动化具体的失败模式。文章还探讨了基于参考与无参考评估的区别,并强调应结合多种方法,优先使用二值评分以确保评估的清晰性与可靠性。

技术 › LLM Lotte 2026-05-208.8 KB 40.9K 417 83