资料越多,AI结果就越好吗?聊聊上下文工程
文章讨论了向AI提供工作文件和聊天记录时的常见误区:资料多不等于重点清晰。作者介绍了“上下文工程”的核心思路,将材料分为四类:必须保留的关键信息、可压缩为摘要的长背景、暂不需要归档的大资料以及应剔除的过期内容。长任务应重新交代当前进度,大资料按需索取而非全量塞入,并用结构化“便笺”式指令明确任务、依据、约束和边界。核心观点是:先想清楚AI此刻要做什么,再把真正用得上的信息放到它眼前。
文章讨论了向AI提供工作文件和聊天记录时的常见误区:资料多不等于重点清晰。作者介绍了“上下文工程”的核心思路,将材料分为四类:必须保留的关键信息、可压缩为摘要的长背景、暂不需要归档的大资料以及应剔除的过期内容。长任务应重新交代当前进度,大资料按需索取而非全量塞入,并用结构化“便笺”式指令明确任务、依据、约束和边界。核心观点是:先想清楚AI此刻要做什么,再把真正用得上的信息放到它眼前。
作者将《红楼梦》中的大观园重建为可在浏览器中漫游的三维世界,把文本与空间放进同一窗口。项目整理了二十处景致,涵盖五十九回原文、三十三首诗词和一百五十八位人物。读者可点选景致查看对应原文与诗笺,跟随第十七回贾政游园路线导览,或在漫步模式中自由行走,并可切换四季、昼夜与天气共三十六种环境状态。整个项目依据原著游园路线与北京大观园复建格局推定,最终打包为约 2.7 MB 的 HTML 文件,离线也能体验,成为一份可交互、可行走的阅读批注。
作者分享其开源公文排版 Skill 走红后的复盘:发布后自测发现电子红头模式存在标题贴线、字体错误等问题,坦言自己常用路径绕过了该功能,导致未经验证的信任。随后逐项核对国标,通过生成 18 份 Word/PDF 共 37 页的场景测试,修复了间距、字段挤位、命令格式理解偏差、标题样式缺失、红头纸套打和字体替换等隐蔽问题。文章核心观点:AI 大幅加快了开发速度,但无法省掉面向真实使用场景的验证与返工,'测试过了'需要具体化到场景、环境和结果。
文章介绍了开源中文表达 Skill「辞达」v1.0.0。作者认为工整、分点、逻辑清楚不应自动被视为“AI味”,真正需要修改的是空话套句、机械重复和逻辑断点。辞达以“达意”为先,按 P0–P4 优先级处理文本:先意义与逻辑,再结构、语域、节奏,最后语言打磨。它提供快速优化、深度重写、解释改动和风格校准四种工作方式,内置 8 条工作流、7 类平台适配(覆盖公众号、小红书、知乎等)。辞达不以躲避 AI 检测为目标,采用 MIT 许可证,支持 Claude Code、Codex、OpenCode 等兼容 Agent 使用。
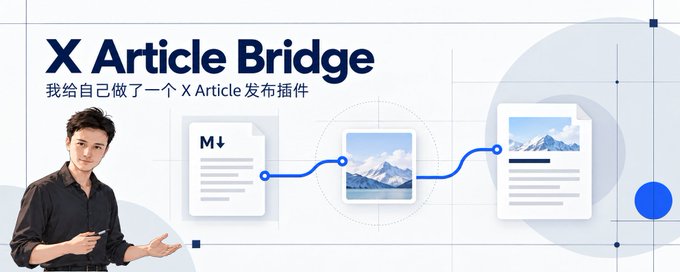
作者分享了在发布 X Article 时遇到的痛点:图片无法随粘贴的网页内容自动上传,需要逐张手动查找、上传并拖放到对应位置,流程繁琐易错。在尝试现有 Markdown 转 X Article 工具后仍不满意,于是自己开发了插件 X Article Bridge。该插件可将已写好的 Markdown 或 HTML 送入打开的 X Article 草稿,支持批量选择图片并按路径匹配、逐张通过 X 官方媒体入口上传并还原到原文位置、单独处理封面选择。作者认为内容工具的价值在于消除发布流程的最后一公里,让写作发布从手工搬家变成交付前检查。
文章探讨了 AI 智能体面临的安全风险,指出其自主性、工具调用、自然语言理解、记忆和多智能体协作等特性放大了攻击面。作者主张采用零信任架构,默认不信任、持续验证,并从身份、权限、隔离、审计、恢复和治理八个方面提出落地建议,强调安全设计应追求让攻击'做不到'而非'做起来麻烦'。
作者在帮家人用AI处理一批国企公文材料时,发现方正CEB格式文件无法被AI读取,而工具未明确报错,导致AI在空输入上生成了看似完整的答案。由于手动用方正阅读器导出效率极低,且GitHub上可用的转换工具稀少且缺乏维护,作者开发了一个CEB转换Skill,可将批量CEB文件转换为PDF、Markdown和纯文本,供AI继续做检索、摘要和起草。测试45份文件全部转换成功。作者提醒:给AI喂材料时应先确认文件是否真正被读取,避免格式问题导致后续分析建立在不完整输入上。
作者在发布 Gongwen 公文排版 Skill 后,发现红头模式下标题几乎贴着红线、字体不对等问题。他重新对照 GB/T 9704-2012 国标,逐条核查生成器和校验器,生成18份Word和18份PDF共37页进行验证,修复了版头字段定位、红线间距、标题样式等问题,并拆分了红头的使用场景。同时坦诚说明了字体缺失、打印套打等尚未解决的问题,将新版发布到 GitHub。
作者分享了开源公文排版 Skill 的经历。最早使用 Claude Code 的 Office 能力生成 Word 文档,但发现原有格式(标题层级、段前段后间距、缩进、页脚等)经常丢失,且 WPS 与 Office 字体命名规则不一致导致排版不稳定。受 Kimi 客户端自动生成标准公文版式的启发,作者将公文格式做成 Skill,并逐项核对 GB/T 9704-2012 国标修正问题。该 Skill 可生成符合标准的页面、字体、标题、正文、文号、署名、日期和页码的可编辑 DOCX 文件,已开源并支持 Codex、Claude Code、OpenCode、Kimi 等多个平台安装使用。
文章复盘了一个不懂传统编程的团队转向 AI 编码的企业级实践。作者提出与主流 Copilot 叙事相反的范式——不是 AI 辅助人,而是人辅助 AI:AI 是执行者,人是决策者,由产品总监负责定义需求、设定边界和裁决。团队踩过两万字 PRD 翻车的坑,总结出传统 PRD 对 AI 的三大致命伤(模糊词、流程图依赖、文档脱节),并沉淀出情景化开发路径(UI First / Data First)、AI 友好型 PRD 四特征(全局术语表、EAR 表、逻辑真值表、UI 绑定)以及用 AI 质检 PRD 的方法。核心结论:输入质量决定 AI 产出质量,把话说清楚从软技能变成硬工程。