Wiki 知识库

全部文档 / 作者: Akshay / 标签: 知识图谱

4 篇
清除

Agent Memory Is Not a Search Problem

文章指出 Agent 记忆系统的核心问题不是检索而是上下文组织。跨 15 个模型、20 万模拟对话的研究显示,任务拆分为多轮会使准确率平均下降 39%,而合并为单轮可恢复大部分损失。文章回顾了 Agent 记忆的四个发展阶段(全量历史、滚动摘要、向量检索、知识图谱),批评语义/情景/程序性记忆分类无法指导检索决策,并主张按六种问题类型构建六种上下文形态。作者基于开源 Graphiti 引擎,以客户历史为例实操演示如何让记忆系统在模型运行前正确组织上下文,避免基于过时信息的自信回答。

技术 › Agent Akshay 2026-09-2919.3 KB 27.4K 171 86

超越事实检索:AI Agent记忆系统中的模式识别与洞察

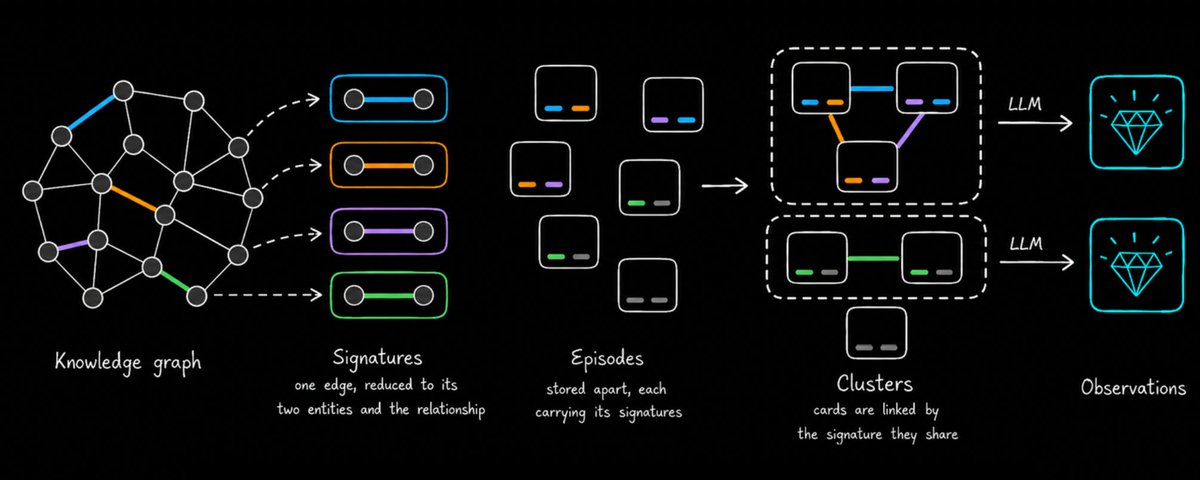
当前AI Agent的记忆系统虽能准确存储与检索单一事实,却无法像人类一样洞察事实间的结构关联。本文以项目管理为例,指出传统的检索优化无法解决这一局限。为此,Zep平台(开源Graphiti)引入了“Observations(观察)”功能,通过构建知识图谱,结合确定性算法聚类与LLM总结,跨实体分析并生成深度的上下文洞察。这种机制不仅能追溯证据,还能帮助Agent从全局视角识别如“核心阻塞点”等复杂问题。

技术 › Agent Akshay 2026-08-1013.7 KB 106.3K 517 81

Pydantic fixed my Agent's Memory

文章探讨了如何解决 AI Agent 记忆系统的多跳推理问题。传统的向量数据库在处理跨块事实连接时失效,而通用知识图谱常因缺乏结构导致查询噪音。作者提出的解决方案是使用 Pydantic 提前定义本体(Schema),明确实体类型、关系和属性。通过 Zep 框架强制执行这些约束,可以显著提升提取的准确性和数据的可查询性,从而实现有效的多跳推理。

技术 › Agent Akshay 2026-05-2612.5 KB 312.9K 567 80

构建永不遗忘的 Agent:从原理到 Graph-Vector 混合架构

文章从第一性原理出发,深入探讨了 Agent 记忆机制的演变。作者指出单纯依赖 Context Window 会遭遇“中间迷失”效应,并借鉴认知科学将记忆分为感觉记忆、工作记忆和长时记忆。文章通过对比 Python 列表、Markdown 文件和向量搜索等不同技术层级的优劣,揭示了传统方案在持久性、语义理解和关联推理上的局限性,最终提出了结合图数据库和向量搜索的 Graph-Vector 混合解决方案。

技术 › Agent Akshay 2026-04-1628.0 KB 631.8K 1.9K 83