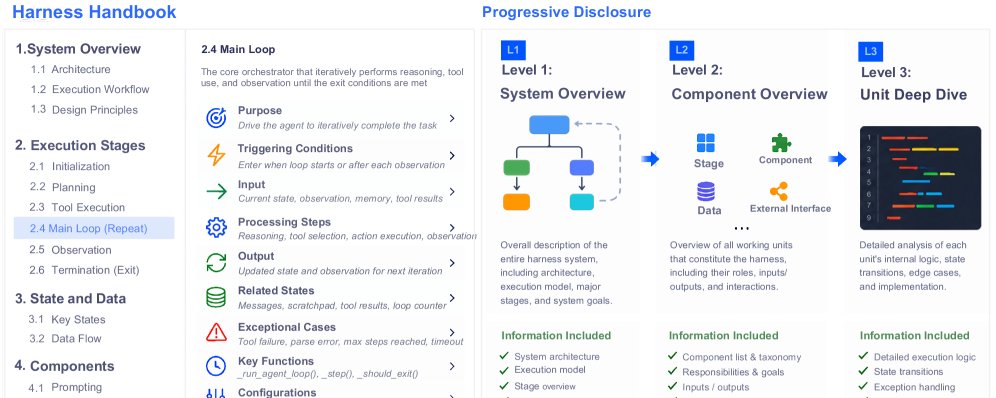
Wiki 知识库

全部文档 / 标签: Memory

42 篇
清除

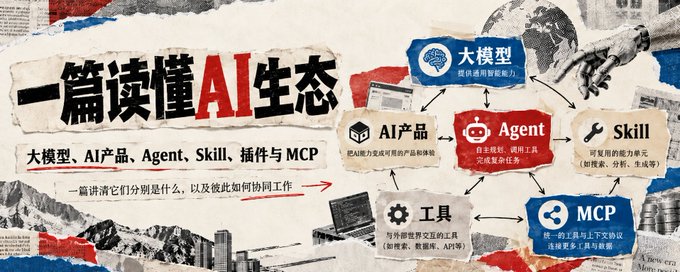
大模型、AI 产品、Agent、Skill、插件和 MCP 到底是什么?

文章系统梳理了 AI 生态中的核心概念及其关系。首先介绍 AI 模型,按处理信息类型分为语言/多模态、图像生成、视频生成、音频语音和专用任务模型,并列举 GPT、Claude、Gemini、FLUX、Veo、Whisper 等代表产品。其次区分 AI 模型与 AI 产品,涵盖综合助手、AI 搜索、创作和办公开发工具。然后解释 Agent 如何从回答问题走向执行任务,分类介绍了编程 Agent(Codex、Claude Code)、跨应用 Agent(Manus、OpenClaw)和长期个人 Agent。最后厘清 Skill(可复用工作方法)、Tool(具体能力)、Plugin(功能集成)、API(软件接口)和 MCP(标准化连接协议)的区别,以及 Workflow、Memory、知识库和执行环境等支撑能力,帮助读者理解整个 AI 生态的组成与协作方式。

技术 › LLM Shlcy 2026-10-1813.9 KB 3.6K 18 76

How We Built Memory For Continually Learning Sales Agents

本文介绍了Monaco团队为持续学习的销售Agent构建记忆系统的实践。作者提出下一代收入平台应从'记录系统'进化为'智能系统',并设计了Monaco Memory:分为组织记忆与用户记忆两层,采用人类与模型都可读的版本化Markdown(S3存储)作为载体,保证可解释性和可编辑性。系统通过基于事件的pub-sub触发器和定期'反思'(reflection)两种机制自动更新记忆,并将记忆作为上下文注入各Agent任务中。文章以账号筛选排除和异议处理两个场景展示了记忆系统如何提升销售工作流的智能化水平。
技术 › Agent Mihail Eric 2026-10-018.6 KB 8K 135 79

Agent Memory Is Not a Search Problem

文章指出 Agent 记忆系统的核心问题不是检索而是上下文组织。跨 15 个模型、20 万模拟对话的研究显示,任务拆分为多轮会使准确率平均下降 39%,而合并为单轮可恢复大部分损失。文章回顾了 Agent 记忆的四个发展阶段(全量历史、滚动摘要、向量检索、知识图谱),批评语义/情景/程序性记忆分类无法指导检索决策,并主张按六种问题类型构建六种上下文形态。作者基于开源 Graphiti 引擎,以客户历史为例实操演示如何让记忆系统在模型运行前正确组织上下文,避免基于过时信息的自信回答。

技术 › Agent Akshay 2026-09-2919.3 KB 27.4K 171 86

Muse 上手保姆级教程:从登录到完成第一个任务

本文是 Meta 个人 AI Agent「Muse」的保姆级上手教程。作者从登录与初始化讲起,介绍如何通过提示词设定合作方式与权限边界,并以「把网页链接整理成资料表」为跟练示例,演示任务下达、成果核对、迭代修改的完整流程。文章还介绍了 Memory、Soul、邮箱连接器、Goals 长期目标、自定义连接器与电脑接入等进阶能力,强调先明确资料范围、完成标准和交付形式,再逐步开放权限,并给出常见问题的排查方法。核心方法论为「任务 + 资料范围 + 完成标准 + 交付形式」。

技术 › Agent 蓝哥AI 2026-09-2514.6 KB 2.1M 2K 80

Open Memory, Own the Intelligence

本文探讨了AI Agent开发中开放Harness与记忆所有权的重要性。作者引用Harrison Chase的观点——'不拥有Harness就不拥有记忆',并区分了Memory(从上下文窗口记录的事实,如用户偏好、仓库知识)和Intelligence(利用这些事实让会话更智能的机制)。文章详细介绍了Mem0的方案:通过custom_instructions和infer=False控制记忆提取,用语义+BM25+实体搜索进行检索,并借助Dream实现记忆合并、替代与综合。作者主张将记忆层置于Harness之外,存储于SQL、向量数据库和实体存储中,从而实现跨Harness的记忆与智能的可移植性,即使前沿实验室的循环保持封闭。

技术 › Agent mem0 2026-09-1517.1 KB 16.1K 157 69

Claude Tag 产品分析

作者从 TO B 产品经理视角深度拆解 Claude Tag 产品,指出市面仿品多为 TO C 出身团队,只仿其型未仿其神。文章系统介绍了 Claude Tag 的三大产品原语:Space(组织/Workspace/Channel)、Capability(Repositories/Domains/Plugin/Credentials)与 Control(Instruction/Memory/规则),以及 Access Bundle 的组合机制。还分析了数据设计、Memory 树形组织、审计功能(Scheduled Work/Memory/Network Event)等细节,并分享了 70 刀开通成本与计费逻辑变化等使用体验。

技术 › Claude Bestony | 白宦成 2026-09-1116.9 KB 17.9K 72 78

Self Evolving Harness With Memory:编码智能体的自进化与记忆机制

文章探讨如何在不训练模型的前提下,让编码智能体在后续任务中持续变好。作者将编码智能体拆解为“冻结模型 + harness 程序”,并以 Pi 和 Hermes 为例说明通用 harness 的循环结构:组装提示、调用工具、追加结果、压缩上下文。核心观点是,真正带来“自进化”的并非内层循环本身,而是引入第二个写入者——在回合结束后或任务进行中,由额外代理将经验写入 MEMORY.md、SKILL.md 或四类存储,使下一个上下文窗口能加载这些持久化知识。Hermes 通过 fork 代理定期写记忆与技能,Prime Agent 则用 /refine 从轨迹中做最小可回滚编辑。两者都保留不可变基础提示,只改变下一窗口内容。

技术 › Agent mem0 2026-09-1022.9 KB 40.5K 438 74

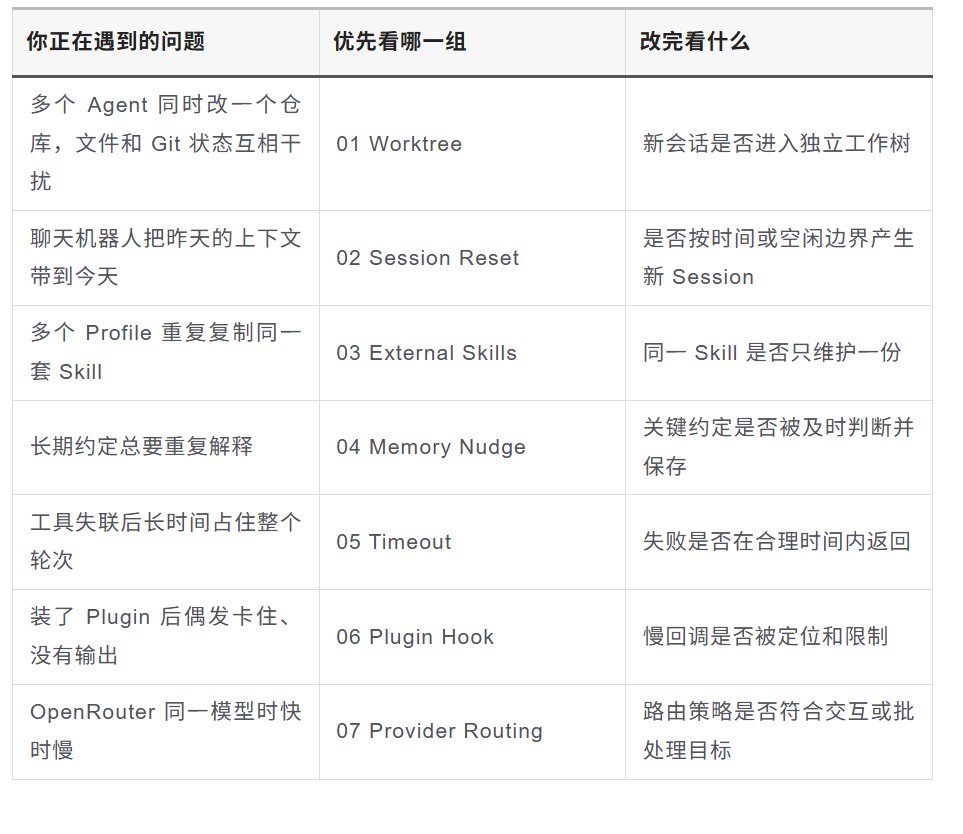
Hermes 深度配置指南:从默认到高效,7组被低估的提效设置

文章分享了7组被低估的 Hermes 提效配置:Worktree 为多 Agent 隔离 Git 工作副本;Session Reset 通过 idle/daily 模式清理跨天会话污染;External Skills 让多个 Profile 共享一份 Skill 母版,避免多副本分叉;Memory Nudge 调节经验沉淀提醒频率,区分长期规则与临时上下文;Timeout 按任务类型分层设置 MCP 与工具超时,让失败尽快暴露;Plugin Hook 先排查回调阻塞再怀疑模型;Provider Routing 针对成本、吞吐或延迟优化 OpenRouter 路由。作者强调先确认症状、一次只改一组配置,并通过实际验收确认生效。

技术 › Hermes 老爸的AI联萌 2026-09-0316.5 KB 1.4K 8 90

读懂 Warp 的 Agent Skill 自进化机制

本文深入解读了 Anthropic 发布的关于 Warp 构建自进化 Agent 的博客。Warp 通过双 Skill 循环(Base Skill 和 Improver Skill)实现 Agent 的自我改进,将人类反馈转化为对 Skill 文件的修改,并通过 Git 工作流进行管理。文章区分了 Skill 与 Memory 的不同,指出 Skill 是程序性知识,而 Memory 是事实记录。同时,文章探讨了 Skill 自进化的边界,对比了 Skill(软约束)与 Harness(硬约束)在 Agent 进化中的不同作用,并提出了 Agent 可进化内容的三层模型:Memory、Skill、Harness。最后,作者总结了 Warp 团队关于编写 Skill 的几条实用经验,并强调了这种轻量级自进化机制的工程价值。

技术 › Agent LanLance 2026-09-017.9 KB 14.2K 122 74

Agent 为什么也需要一套自己的 Git

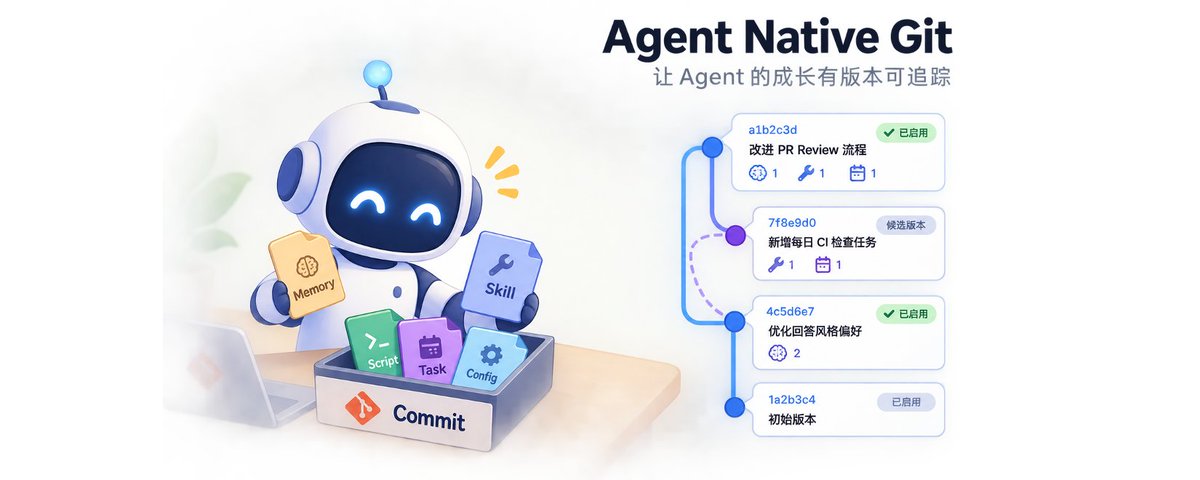
随着 AI Agent 从聊天机器人演变为长期自我改进的系统,其 Memory、Skill、Script、定时任务和权限等状态不断变化且相互依赖,容易陷入不一致的"半升级"状态。文章提出 Agent 需要一套类 Git 的版本管理体系(Agent Native Git),让每次自我修改成为可查看、可审查、可回退的完整"升级包"。文中以 Hermes 的 Memory Tool 和 Skill Ledger 为案例,分析了现有实现的差距,并提出候选版本、变更记录、冲突检测、分层存储等四项关键能力,以及基于 libgit2、gix、Dulwich 等开源实现的技术方案。

技术 › Agent Yinsen 2026-08-3017.2 KB 5.3K 29 80

未来 Skill 的终极形式 → Agent 大脑

文章探讨为什么同一个 Skill 在不同人手中运行效果差异巨大:Skill 如同课本,本身不等于能力,离开适配的环境便难以发挥作用。作者引用 OpenAI 产品负责人 Tibo 的观点和 Karpathy 的 LLM Knowledge Bases 实践,提出未来 Skill 的终极形式是 Agent 大脑——一个持续吸收 Skill、理解本地环境、积累真实运行反馈并自主更新演化的个人知识库。真正拉开 Agent 能力差距的,不是安装了多少 Skill,而是外部知识能否被熔炼进属于自己的系统。

技术 › Skill vink 2026-08-299.2 KB 18.6K 54 67

25个大多数人都完全错过的Claude隐藏功能

文章系统介绍了Claude中25个被大多数用户忽视的隐藏功能,涵盖设置层的自定义指令、记忆、历史搜索、代码执行、思考力度控制与风格预设;Projects作为持久化工作区的作用,包括项目指令、知识文件、RAG模式与独立记忆;以及Artifacts版本管理与分享、Skills可复用工作流、Cowork定时远程会话和并行子代理等自动化能力。作者指出真正的升级在于持久化:记忆、指令、文件和可复用工作流,帮助用户将Claude从聊天框升级为完整的工作系统。

技术 › Claude Kanika 2026-08-1813.1 KB 109.1K 141 75

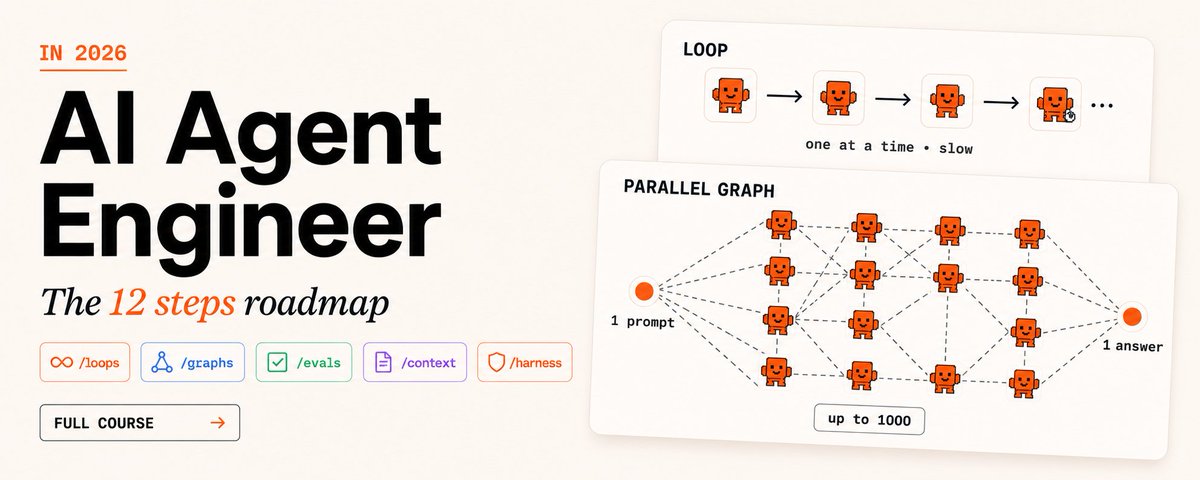
AI Agent Engineer 2026:七大支柱与12步学习路线图

作者提出2026年AI Agent工程师的12步路线图,围绕决定Agent成败的七大支柱展开:上下文、工具、记忆、循环、图、Harness与评估。文章指出Agent失败的核心原因是上下文膨胀、循环不收敛、缺乏评估。前半部分详细讲解上下文工程(如Claude Code启动即加载约7850 token、精简系统提示、CLAUDE.md分层管理)、工具与MCP设计(用类型代替示例、延迟加载)、记忆管理(计划文件、主动压缩)等内容,强调七者是同一技能的不同投影,需按依赖顺序学习。

技术 › Agent Codez 2026-08-1824.8 KB 80.9K 508 83

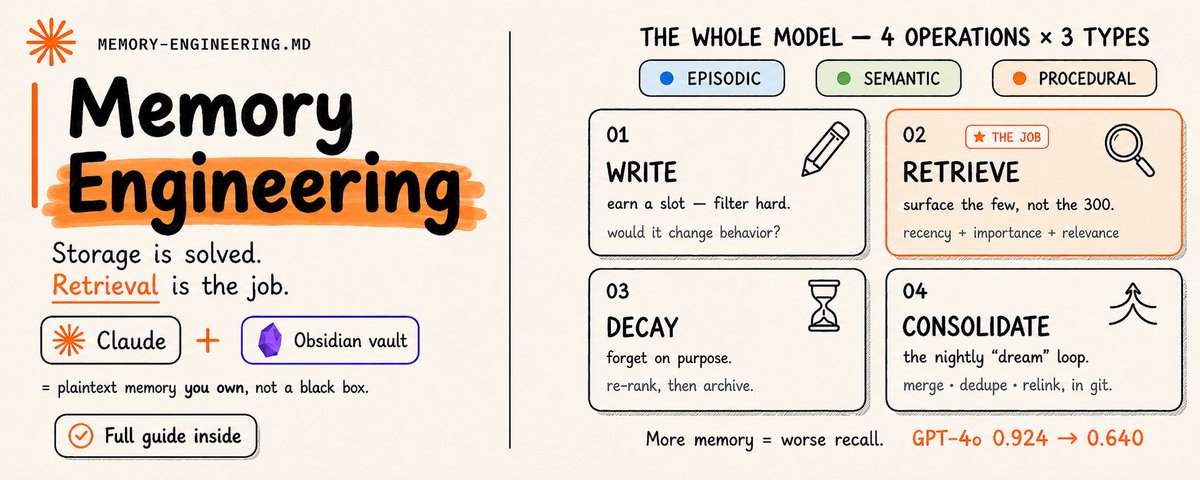
Memory Engineering: retrieval is the job

文章探讨了 AI Agent 记忆工程的核心问题:存储已解决,检索才是关键。指出存储过多信息会导致检索性能大幅下降,并引用 LongMemEval 等研究数据证明“更多记忆,更差召回”。文章介绍了记忆的三种类型(情景、语义、程序)和四种操作(写入、检索、衰减、巩固),强调了“少写、精检”的重要性。

技术 › Agent Roxx 2026-08-0645.4 KB 89.5K 54

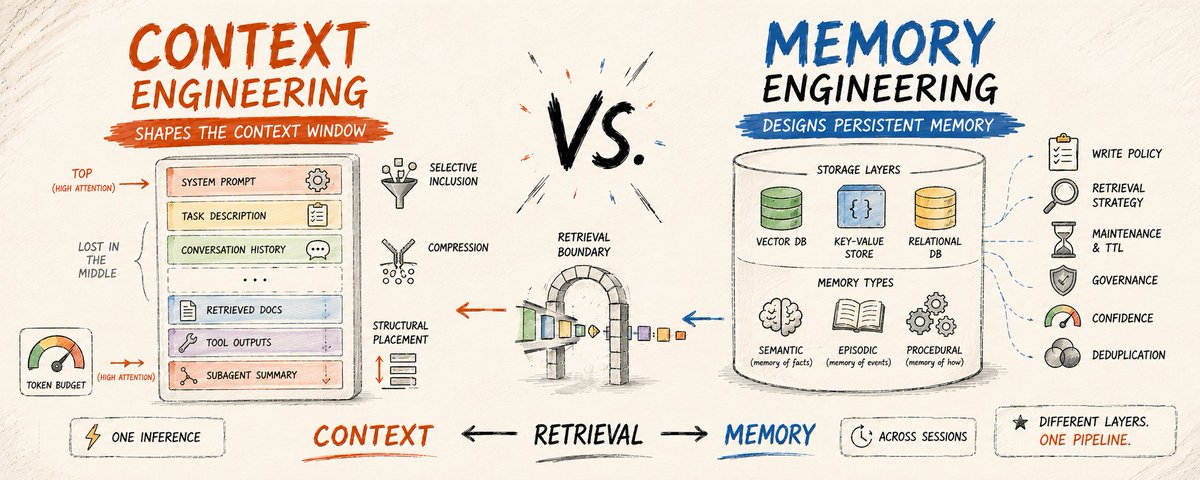
Agent 系统中的上下文与记忆工程

本文探讨了在 Agentic AI 系统中,上下文工程与记忆工程如何解决不同问题。上下文工程专注于单次推理调用的设计,涵盖选择性包含、结构放置、压缩和历史管理;记忆工程则关注跨会话的持久化,涉及写入策略、存储层选择和检索策略。两者在检索边界交汇,共同决定了 Agent 在实际工作负载中的可靠性。

技术 › Agent beamnxw 2026-08-0515.5 KB 527.5K 404

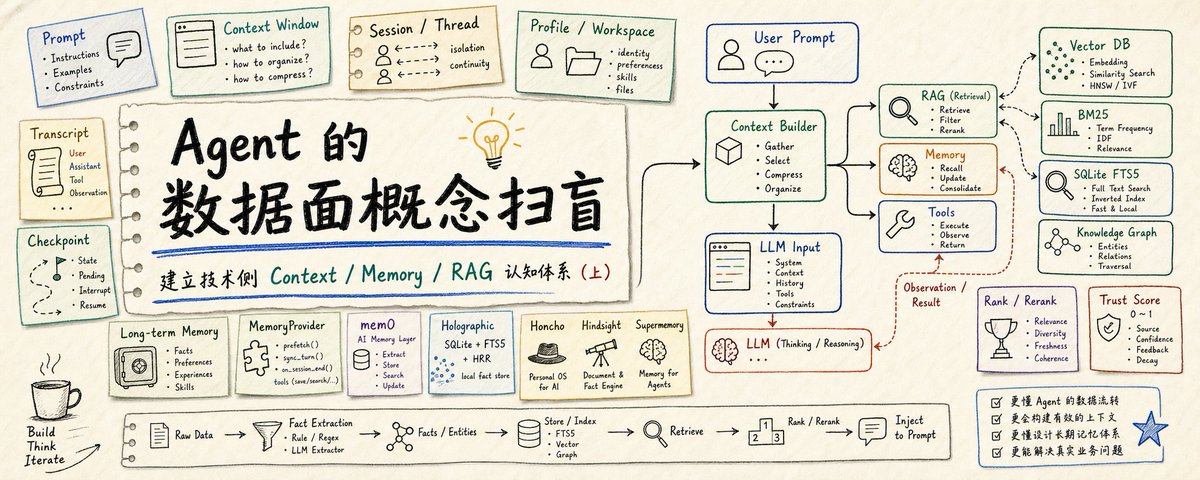
Agent 的数据面概念扫盲-建立技术侧认知体系

本文深入解析了 Agent 数据面的核心概念,将其比作操作系统的内存管理单元。文章详细阐述了 Context Engineering 的演变、Session/Thread/Profile 的架构差异,以及 Session Memory 与 Long-term Memory 的区别。作者还重点介绍了 Hermes 中的 Memory 设计方案、SQLite FTS5 与 BM25 算法原理,以及向量检索与关键词检索在 RAG 中的混合应用,旨在为开发者建立一套完整的 Agent 数据面技术认知体系。

技术 › Agent MateMatt 2026-07-1215.2 KB 13.2K 37

最重要的 AI 创业领域不是 Agent,而是 AI Memory

本文探讨了 AI 领域被忽视的一环:记忆。文章指出,GBrain 正致力于构建持久的认知层,通过自动建立知识图谱和梦境循环维护,让 AI 拥有持久记忆和关系感知。作者认为,未来的 AI 竞争优势将属于那些能积累上下文和理解关系的系统,而不仅仅是智能体本身。

技术 › LLM Nainsi Dwivedi 2026-05-3013.9 KB 11.6K 97 59

The Hermes Agent Memory Guidebook

这是一份关于 Hermes Agent 记忆系统的终极指南。文章深入解析了 Hermes 的三层记忆架构:开箱即用的原生层、可选的插件层以及社区扩展层。作者详细说明了本地数据库与 Markdown 文件的协同工作机制,澄清了关于记忆合并的常见误区,并强调了记忆在 Agent 从无状态聊天机器人转变为具备技能累积和个性化能力的智能体过程中的关键作用。

技术 › Agent Kevin Simback 2026-05-2854.5 KB 85.8K 698 82

AI Agents: 从原理到实战的完整指南

本文是一份关于 AI 智能体的综合指南,涵盖了从基础概念到生产级系统构建的全过程。文章深入解析了 Agent 的核心工作原理,如 ReAct 循环、任务拆解和上下文工程。同时,针对中级开发者,详细介绍了多代理系统的评估体系、记忆与知识管理、安全护栏设计以及四种核心设计模式,旨在帮助读者构建可靠且高效的 AI 应用。

技术 › Agent Rahul 2026-05-2535.1 KB 236.7K 522 84

Agent Memory Framework: Remember, Cite, Forget

本文提出了一个智能体记忆系统的可靠框架,该框架需同时完成三个核心任务:记住该记的、引用可信的、遗忘过期的。文章详细介绍了记忆的六个层级(如会话状态、项目记忆、索引检索等),阐述了如何通过权威排序解决冲突,并强调了通过硬过期、双时序或软衰减等机制让旧记忆失效的重要性。

技术 › Agent Vox 2026-05-2324.3 KB 79.9K 166 85

Agentic Memory: 详解 Agent 记忆系统的架构与实现

文章通过生动的类比,指出缺乏记忆是当前 LLM Agent 的主要短板。作者详细拆解了 Agent 记忆系统的三个核心功能:连续性、上下文和学习。文章重点介绍了四种记忆类型:上下文记忆、外部记忆、情景记忆和参数记忆,并深入探讨了如何通过检索增强(RAG)和反思循环来构建持久的智能。

技术 › Agent Ramakrishna (techwith_ram) 2026-05-1744.2 KB 274.6K 630 81

Codex 5 个实用技巧

文章介绍了提升 Codex 使用效率的五个实用技巧:开启 Memory 功能以记住个人工作习惯;编写 AGENTS.md 固化项目规则;使用 CLI 模式替代 MCP 以节省资源;采用“四段式提示词”先计划再执行;以及任务完成后让 Codex 进行自审。这些方法旨在优化代码生成流程,减少错误并提高团队协作效率。

技术 › Codex 老金 (@freeman1266) 2026-05-062.5 KB 78

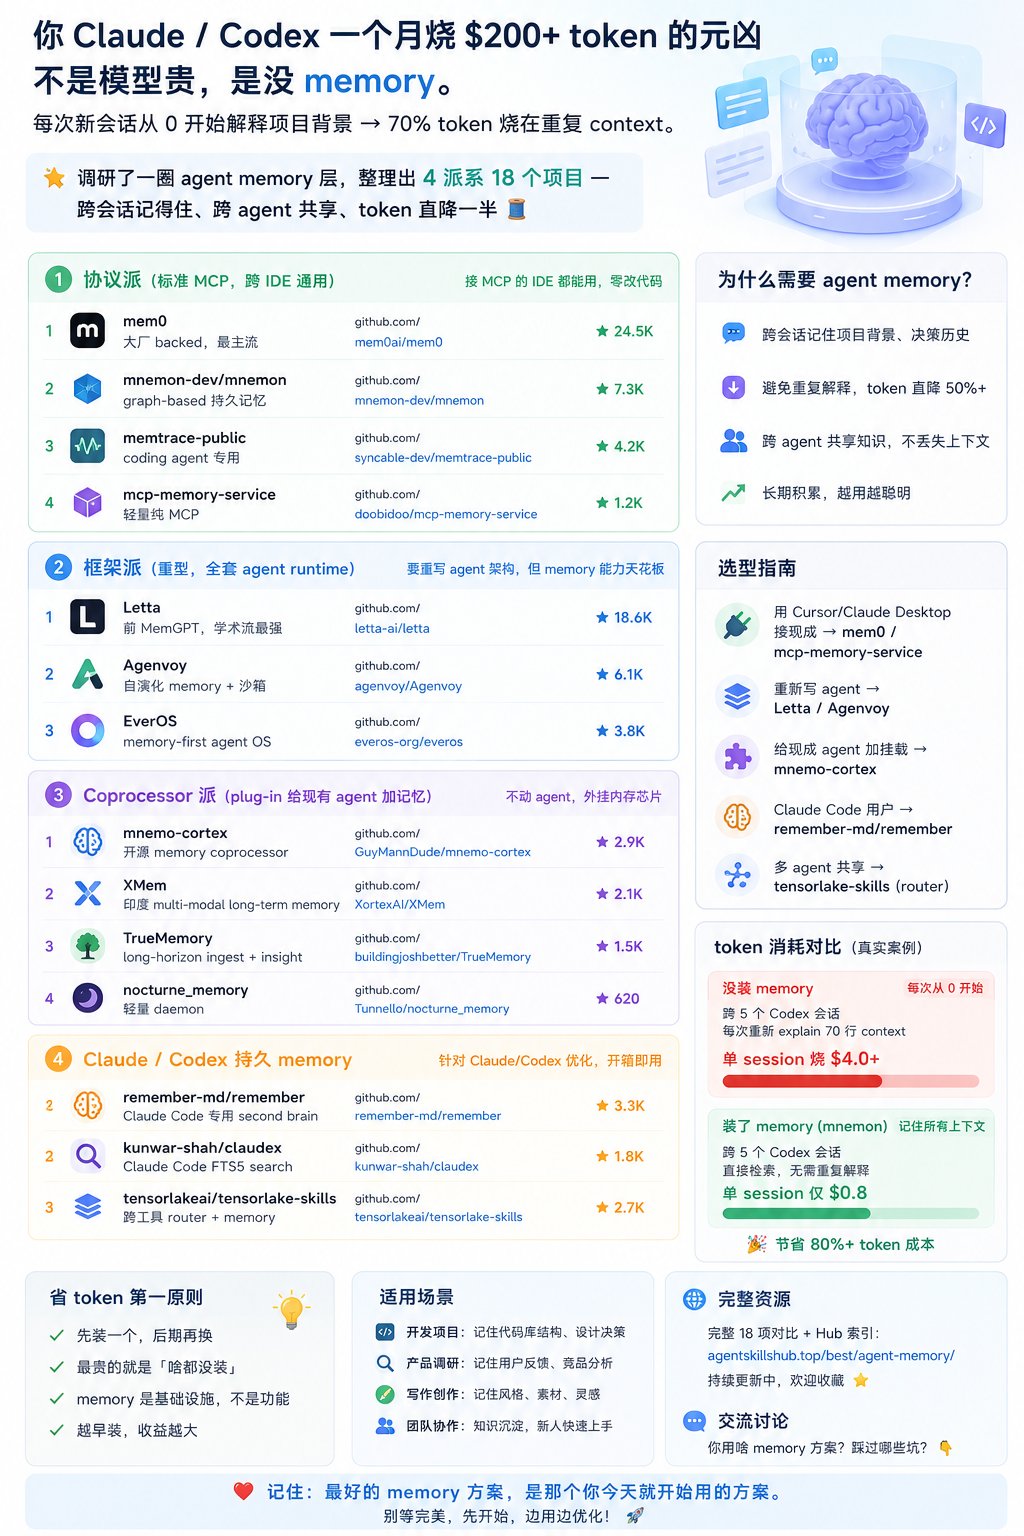
解决 Claude Codex 高 Token 消耗的 Memory 方案调研

文章指出 Claude/Codex 月费高昂的根源在于缺乏持久化记忆,导致大量 Token 浪费在重复上下文上。作者调研了 Agent Memory 层的 4 大派系(协议、框架、协处理器、特定工具),整理了 18 个开源项目,并针对不同使用场景提供了具体的选型建议,旨在通过引入记忆层将 Token 成本降低 50%。

技术 › Agent Jason Zhu 2026-05-064.7 KB 75

Ruflo:将 Claude Code 转变为多 Agent 平台的实践与架构解析

Ruflo 是一个为 Claude Code 构建的“神经系统”和分层运行时,旨在提供 HNSW 向量记忆、100+ 专用 Agent 以及多智能体群集协调。文章详细介绍了其基于 MCP 的工具表面、联邦通信机制和自学习架构。同时,基于项目最新的 ADR 审计报告,分析了 Ruflo 在功能实现上的真实进展,指出了记忆层已可用而部分执行层(如神经网络预测、工作流运行时)仍处于存根状态的现状。

技术 › Agent AlphaSignal AI 2026-05-0614.2 KB 10.4K 153 85

重构数字新皮层:从神经科学到 AGI 路径选择

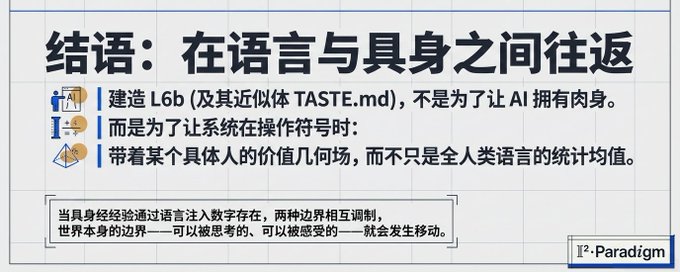
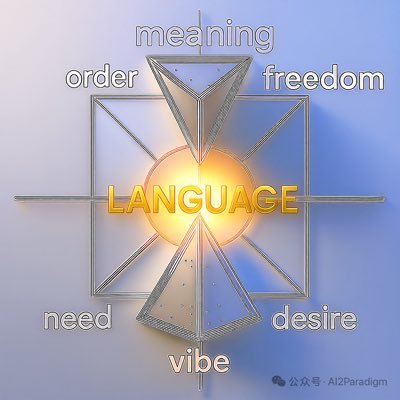
文章续接《Speech Living Beings》,从认知科学视角剖析 AGI 的五条路径。作者将新皮层的六层结构映射到 AI 架构,指出 LLM 对应 L4(语义误差),Representation Bet 对应 L2/3(表征),而 L6b(价值调制层)在当前 AI 中完全缺失。文章引入鲍德里亚的符号学理论,论证 LLM 的语言工业化导致具身价值断裂,并指出当前的 Memory 工程问题本质上是 L6b 层价值选择机制的缺失。

Agent Memory Engineering

文章探讨了 AI Agent 的记忆机制,解释了为何不同 Agent(如 Claude Code 和 Codex)之间无法直接通过复制文件来迁移记忆。作者指出,这是因为模型在后期训练时与特定的记忆层“融合”了。文章对比了 Hermes、Codex CLI 和 Claude Code 三种实现,并得出结论:最聪明的架构(如向量数据库、知识图谱)输给了最简单的方案(LLM + Markdown + Bash 工具)。核心在于 Agent 遵循的读写规范,而非数据结构本身。

技术 › Agent Nicolas Bustamante 2026-05-0299.9 KB 78.1K 381 81

Why Karpathy’s Second Brain Breaks at Agent Scale. How Mercury Solves It.

本文探讨了 Andrej Karpathy 的 LLM Wiki 工作流在人类“第二大脑”场景下的优势,指出其在处理 AI Agent 时的局限性。文章强调,人类记忆优先考虑可读性和反思,而 Agent 记忆系统则需要快速检索、低 Token 成本和冲突解决。Mercury 提出的混合架构方案,主张使用 Markdown 作为人类界面,同时采用结构化内存作为 Agent 的底层设施,以实现上下文的持续累积和可靠运行。

技术 › Agent Zaid 2026-04-297.3 KB 61

2026年AI Agent构建指南:必须掌握的Memory Stack

文章指出AI构建者不应关注模型本身,而应聚焦于底层的可移植Memory Layer。作者通过项目'brain'展示了一种基于Git作为唯一事实来源、SQLite FTS5作为衍生索引的解决方案。这种架构支持跨工具(如Claude Code、Cursor)的通用记忆,实现了数据的类型化、索引、审计和同步。文章详细阐述了Git作为存储的优势、SQLite检索的高效性、秘密扫描及防御机制,强调了类型化事件和可回滚性对于Agent记忆系统的重要性。

技术 › Agent Avid 2026-04-2841.0 KB 544K 361 81