Wiki 知识库

全部文档 / 标签: 向量搜索

12 篇
清除

How I Built pragatiLM?

作者详细介绍了 pragatiLM 的构建过程——一个只基于用户提供的源(PDF、网页、YouTube 视频、字幕文件或粘贴文本)作答并附带可点击引用的 AI 笔记本。文章系统讲解了基础 RAG 的原理及其三大失效点:问题作为搜索键不佳、存储只单向单次搜索、输出缺乏自检。pragatiLM 采用九阶段检索管线:将问题转化为五个搜索变体、并行多通道检索、基于排名一致性融合、重排序、答案 grading,低分时基于缺失诊断再次检索,极低分时拒答。文章还涵盖基础设施、消融实验测试等内容。
技术 › LLM Saurav Jha 2026-09-1340.3 KB 3.7K 34 85

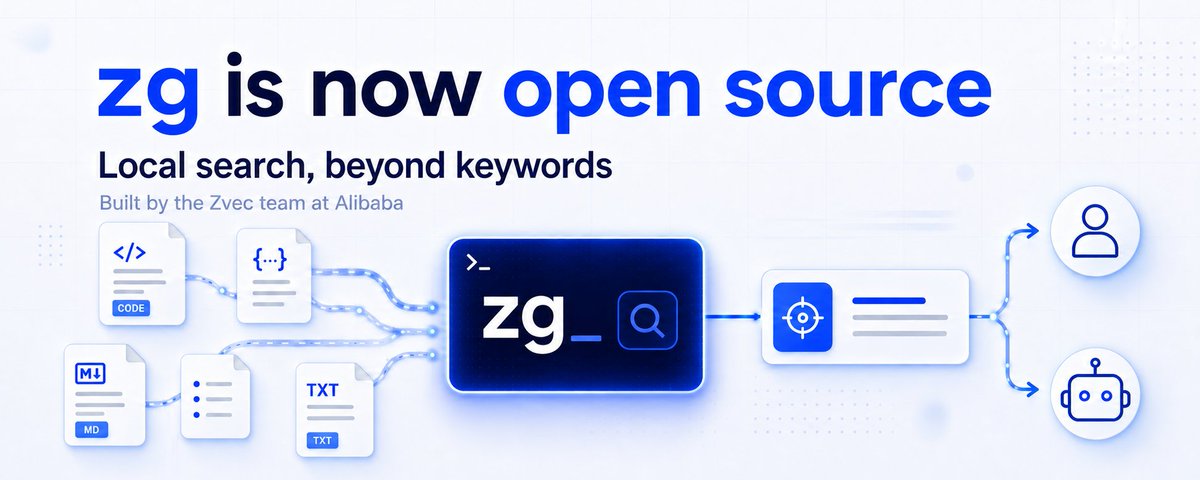
From rg to zg: Local Search Beyond Keywords

阿里Qwen团队开源了zg(zvec-grep),一个面向人类和Agent的本地优先搜索基础设施。zg结合向量搜索、BM25和ripgrep的精确匹配能力,从本地代码和文档中提取、组织并索引内容,将本地检索从关键词匹配扩展到语义发现、相关性排序和精确验证。它支持CLI和MCP接口,可自动发现并配置Codex、Claude Code、Cursor等工具,减少Agent的搜索迭代、工具调用和上下文消耗。所有扫描、索引和嵌入生成默认在本地设备运行,保护数据隐私。

技术 › 工具与效率 Qwen Developers 2026-09-0315.8 KB 250.4K 2.8K 81

百万级文档RAG实战:检索质量由重排和查询改写决定,模型选型反而是小事

本文总结了HN上关于RAG系统实战的讨论,核心结论是检索质量主要由重排和查询改写等流程环节决定,而非模型选型。文章整理了微软Pamela Fox和Usul AI作者Abdellatif等一线工程师的学习清单,涵盖生产级RAG的ROI排序、检索理论、开源模板、模型评测、存储基础设施及产品案例,并指出query generation和reranking是性价比最高的优化点,chunking最耗时。

技术 › LLM yibie 2026-08-136.4 KB 77

Agentic Knowledge Graphs: what actually works in production

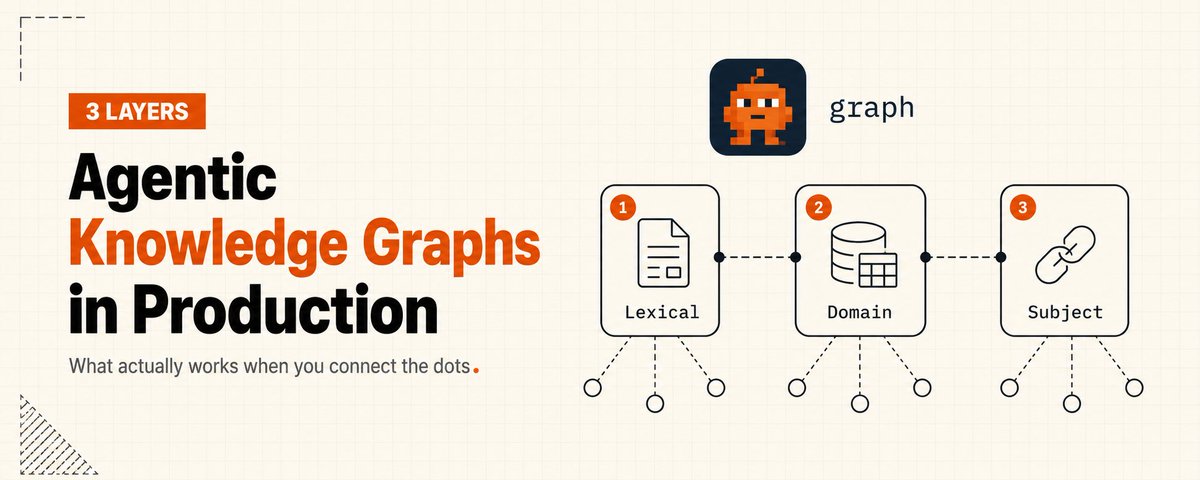
文章探讨了在生产环境中实施智能体知识图谱的实际经验。作者指出,并非所有场景都需要图谱,大部分问题可通过元数据过滤或混合搜索解决。只有当需要多跳连接(如根因分析)时才需引入图谱。建议将图谱分为领域图、词汇图和主题图三层,并从简单的单智能体流程开始构建。

技术 › Agent rewind 2026-08-0649.7 KB 48.5K 66

BestBlogs 早报 · 08-04|从 Qwen 长程能力、生产推理到办公智能体,模型如何进入真实工作

本期早报深入探讨模型进入真实工作的实践路径。精讲内容涵盖 Qwen3.8-Max 的长程自主工作与评测、Baseten 的生产推理工程取舍,以及腾讯、阿里、字节在 AI 办公领域的组织竞争。此外,还速览了 OpenAI GPT-Live、MiniMax H3 开源、Agent 框架及 SQLite 安全等前沿动态。

技术 › LLM ginobefun 2026-08-0424.5 KB 4.1K 2

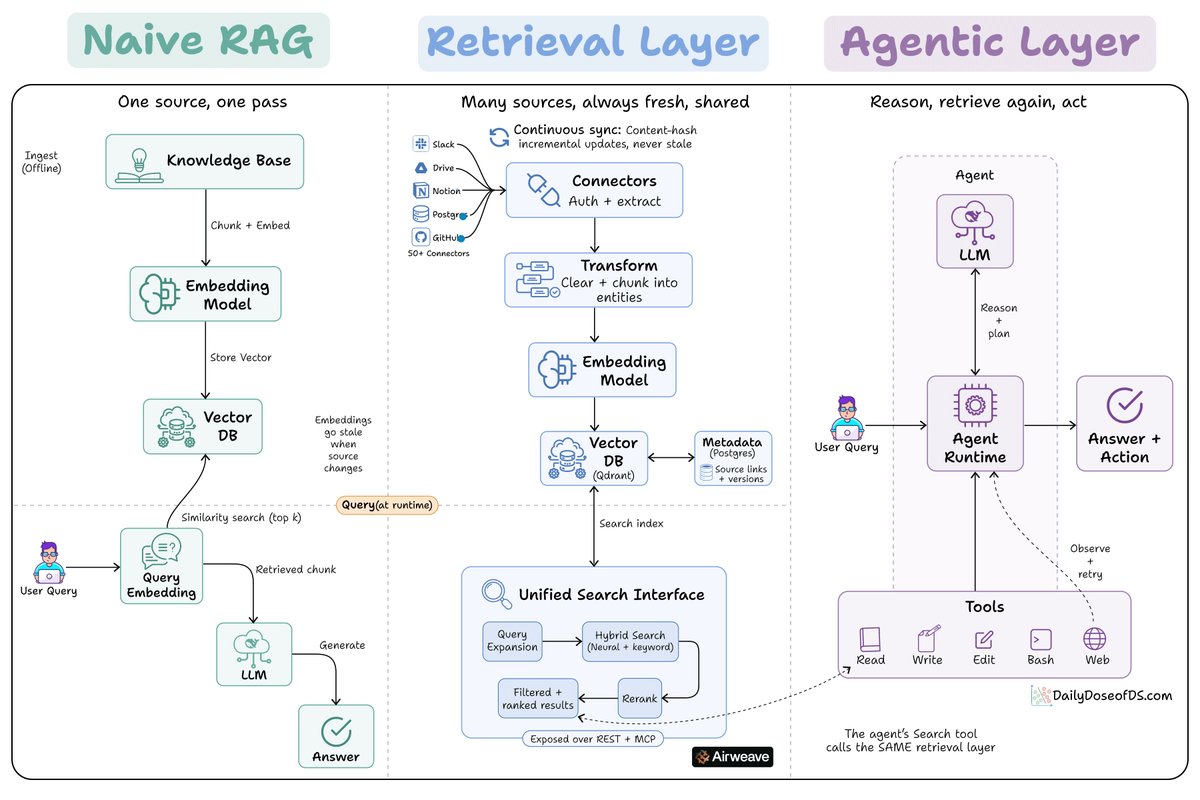
Google和Anthropic对检索的共识:从单一应用到独立服务

文章讨论了Google和Anthropic将检索从单一应用中移出,转变为独立服务的新趋势。这种分离解决了旧RAG设置中的过时嵌入和基础设施耦合问题。通过将摄取与查询分离,并使用结构化单元代替原始文本块,可以显著减少语料库大小并提高向量相关性。

技术 › LLM Akshay 2026-08-022.9 KB

Understanding HNSW: The Engine Behind Fast Vector Search

本文深入解析了HNSW(分层可导航小世界)算法,这是现代向量数据库实现快速近似最近邻搜索的核心技术。文章通过邮政分拣的比喻,阐述了HNSW如何结合NSW图结构和跳表的概念,利用分层结构从粗糙到精细地快速定位目标,并详细说明了向量搜索和插入的具体流程。

技术 › 数据库 achal 2026-07-3012.6 KB 5.3K 67

How we built our knowledge base

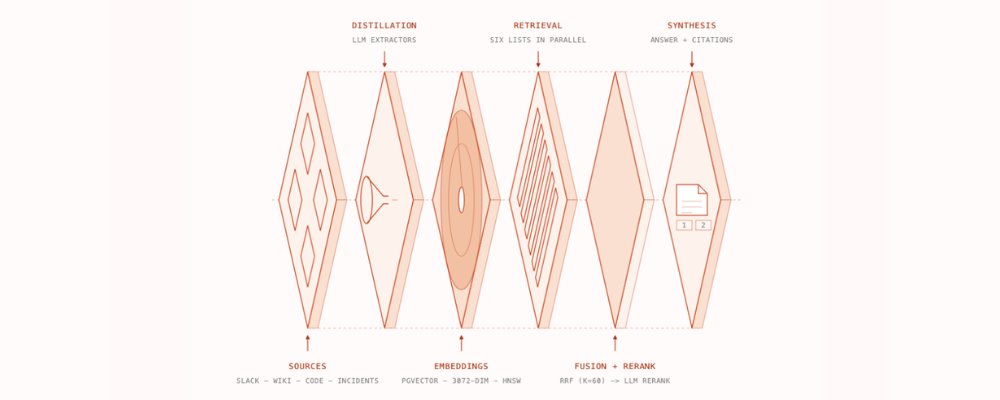
Cerebras 分享了构建其内部知识库的经验。该知识库每天处理超过 15,000 个问题,集成了 Slack、GitHub 等多种数据源。文章详细介绍了如何通过 Postgres 存储 embeddings,并采用混合搜索策略(全文搜索、向量搜索、IDF 加权、时间衰减)来高效检索非结构化对话数据,解决了信息分散和匹配精度的问题。

技术 › DevOps Cerebras 2026-07-18311.2 KB 3.6M 5.6K

构建生产级 AI 系统必须掌握的 6 个核心概念

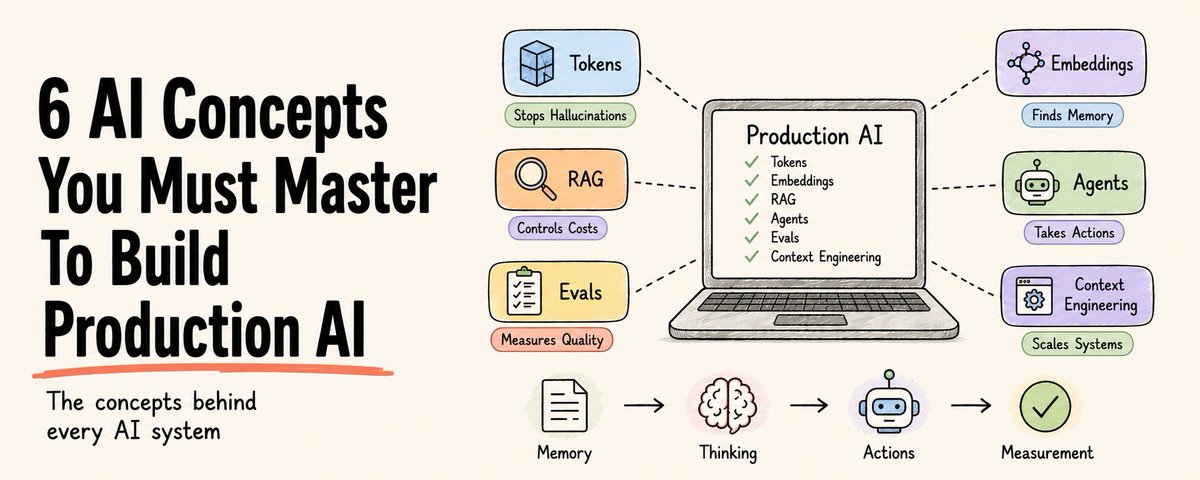
本文由作者因遭遇 AI 智能体失控产生高昂费用的经历引出,旨在阐述构建生产级 AI 系统必须掌握的核心概念。文章提出了 AI 系统的通用公式:记忆(RAG)+ 思考(LLM + Tokens)+ 行动(Agents)+ 测量(Evals)。文中重点解析了 Tokens 与上下文窗口的成本与限制、嵌入向量与语义搜索的原理、RAG 检索增强生成的正确姿势、智能体循环中的工具使用与停止条件等关键技术细节,帮助开发者从“调参侠”进阶为真正的 AI 工程师。

技术 › LLM Rahul 2026-06-1930.7 KB 509.9K 334

构建永不遗忘的 Agent:从原理到 Graph-Vector 混合架构

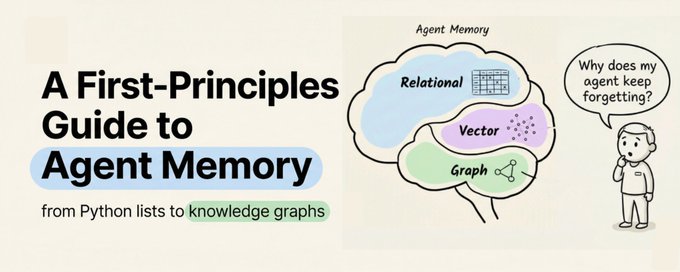
文章从第一性原理出发,深入探讨了 Agent 记忆机制的演变。作者指出单纯依赖 Context Window 会遭遇“中间迷失”效应,并借鉴认知科学将记忆分为感觉记忆、工作记忆和长时记忆。文章通过对比 Python 列表、Markdown 文件和向量搜索等不同技术层级的优劣,揭示了传统方案在持久性、语义理解和关联推理上的局限性,最终提出了结合图数据库和向量搜索的 Graph-Vector 混合解决方案。

技术 › Agent Akshay 2026-04-1628.0 KB 631.8K 1.9K 83

OpenClaw 记忆指南:解决遗忘问题与高级配置

文章深入探讨了 OpenClaw 智能体的三种常见记忆失效模式:未保存、未检索及上下文压缩导致的丢失。作者提供了启用内存刷新、配置上下文修剪、混合搜索及索引历史会话等基础修复方案。此外,还介绍了 QMD、Mem0 和 Cognee 等高级工具,以实现生产级的持久化记忆和知识图谱检索,解决复杂场景下的记忆管理难题。

技术 › Openclaw Kevin Simback 2026-02-2224.0 KB 87