Wiki 知识库

全部文档 / 标签: 知识图谱

51 篇
清除

学习/备考神器!用 AI 十倍速学习任何知识

作者开源了一套用 AI 交互式学习的工具(htd-ai-augmented-education),基于布鲁姆认知分类、苏格拉底式提问等理论,解决传统学习中材料筛选难、教材递归学习、线性阅读低效等问题。工具通过 agent 提炼知识点并构建依赖图,用选择题评估学习者水平,规划主线与支线学习路线;提供交互式讲义、习题反馈、播客音频(支持音色克隆)、可视化学习进度、自动总结笔记本与错题本,以及学习报告等功能,实现个性化、针对考试范围的高效 AI 辅助学习。

技术 › Skill Hytidel聊商业 2026-10-0816.7 KB 73.4K 343 82

Agent Memory Is Not a Search Problem

文章指出 Agent 记忆系统的核心问题不是检索而是上下文组织。跨 15 个模型、20 万模拟对话的研究显示,任务拆分为多轮会使准确率平均下降 39%,而合并为单轮可恢复大部分损失。文章回顾了 Agent 记忆的四个发展阶段(全量历史、滚动摘要、向量检索、知识图谱),批评语义/情景/程序性记忆分类无法指导检索决策,并主张按六种问题类型构建六种上下文形态。作者基于开源 Graphiti 引擎,以客户历史为例实操演示如何让记忆系统在模型运行前正确组织上下文,避免基于过时信息的自信回答。
技术 › Agent Akshay 2026-09-2919.3 KB 27.4K 171 86

10 个带你从基础检索到生产级 AI 系统的 RAG 项目

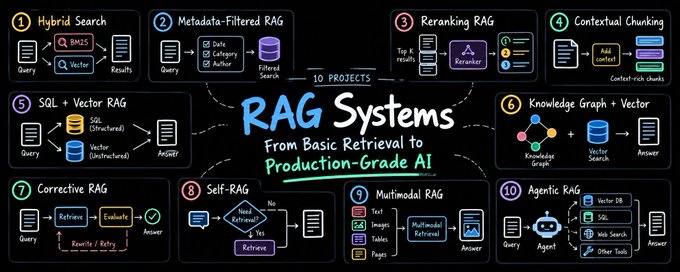
文章指出仅掌握基础的'chat with PDF'式 RAG 流水线(分块、嵌入、向量检索、LLM)不足以构建真实生产系统,并推荐 10 个进阶项目:混合检索(BM25+向量)、元数据过滤、重排序、上下文分块、SQL+向量混合、知识图谱+向量、纠错式 RAG、自感知 RAG、多模态等。每个项目均说明要解决的问题、系统架构、技术栈(Python、pgvector、LangGraph、Neo4j 等)及学习要点,帮助开发者从语义相似度走向关键词匹配、结构化过滤、关系推理与检索质量反馈等生产级能力。

技术 › LLM Jaydeep 2026-09-2912.2 KB 22.5K 314 78

GitHub上这5个神级Skill专治界面丑仓库乱Token贵

文章为内容人和独立开发者推荐了5个GitHub上的高星AI Agent Skill项目,分别解决界面丑、仓库乱、Token贵三大痛点:ui-ux-pro-max-skill提供专业UI/UX决策能力;graphify将代码、文档、SQL等扫描成可查询的知识图谱;caveman通过Skill和代理约束Agent简短回复以节省Token;awesome-claude-skills和awesome-agent-skills则是Claude及多端兼容的Skill精选目录,帮助用户找到靠谱的自动化与工作流资源。

技术 › Skill 生 生于Ai (@LaurentJehanno) 2026-09-171.6 KB 63

Context Infrastructure: Architectural Lessons From the Data Lakehouse

文章提出上下文基础设施正出现一种新模式:尽可能保存原始历史数据(对话、工具调用、事件、Agent 工作记录),之后再按需构建摘要、知识图谱、嵌入等派生视图。这一架构借鉴了数据湖屋(Lakehouse)的经验,如 Databricks 的青铜/白银/黄金分层架构。作者对比了写入时即做压缩决策的内存系统(如 CrewAI),指出其风险在于丢失未来可能重要的信息;并介绍了 CortexDB、Statewave、Supermemory、Zep 等产品的实践:以不可变事件为事实来源,将记忆作为可重建的视图。文章最后提醒需防范上下文沼泽,建议写侧优化保存、读侧优化实用性。

技术 › Agent Josh Rosen 2026-09-1612.2 KB 17.1K 179 79

Ars Umbris:面向类型化知识的可塑 Agent 原生 IDE

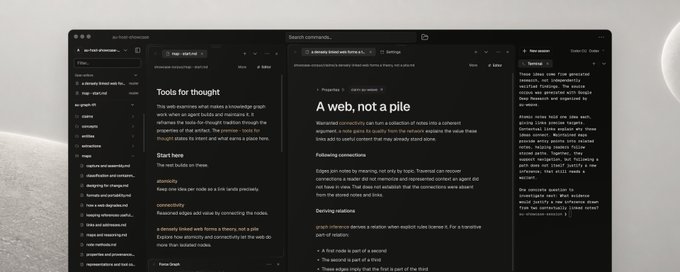
Ars Umbris 是一款可塑的 Agent 原生 IDE,将知识库视为代码库,通过类型引擎为笔记、来源等知识对象定义类型与关系,并像编译器一样对知识结构进行校验。其仓库以本地 Markdown/YAML 文件组织,包含知识、类型、技能、MCP 工具、投影与 Agent 配置,支持跨仓库引用与依赖复用。它通过 MCP 适配器连接 Claude Code、Codex 等 Agent 框架,让多个会话共享同一份持久化状态,形成「元 harness」。项目目前处于早期 Alpha,仅支持 macOS 且需自行编译。

技术 › Agent Heinrich 2026-09-147.3 KB 96.4K 268 66

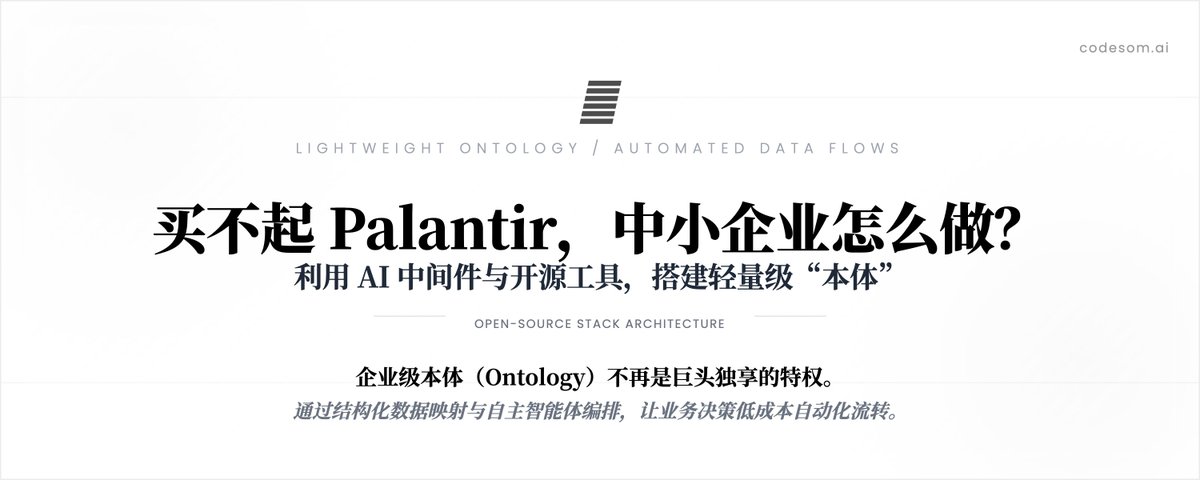
如何利用现有的 AI 中间件和开源工具,搭建出一套轻量级的“本体”并实现自动化流转

文章介绍中小企业如何借鉴 Palantir 的核心理念——统一业务对象、受控执行动作、可审计权限沙箱,用 PostgreSQL、MCP/OpenAPI、AI 中间件和 n8n 等低成本组合搭建轻量级本体系统。作者提出四层技术架构和四步落地路径:建立语义层抽象视图、将写操作封装为强约束 Action Schema、利用中间件编排意图路由与规则门禁、引入人类在环与异步审批。最后给出三个避坑原则:不盲目上知识图谱、业务逻辑放代码而非 Prompt、从小场景建立局部闭环。

技术 › Agent Mens@cc.codesome.ai 2026-09-035.7 KB 1.1K 1 83

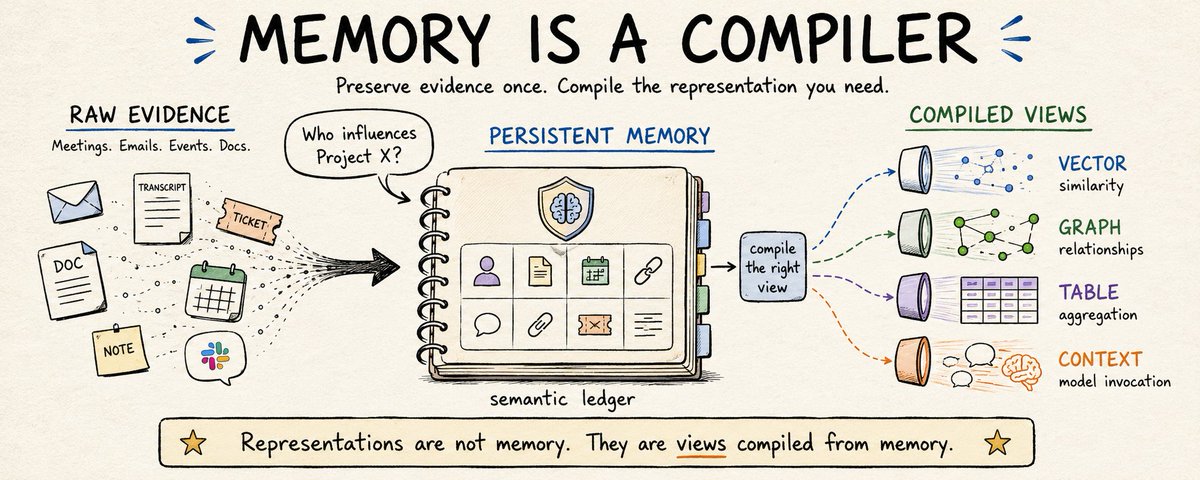
Memory Is a Compiler:记忆是一个编译器

作者通过一次融资会议记忆被重新解读的经历,指出记忆的本质不是固定表示,而是一个持久系统:保留过去的证据,并随新证据不断重新编译其意义。文章批评将向量数据库、知识图谱、上下文窗口等当作记忆的常见误解,认为它们只是从记忆编译出的临时表示。作者提出记忆编译产生三类产物:状态(按序折叠事件得到)、检索(查找相关证据的工具)和上下文(为单次调用组装的有界视图),并类比编译器的中间表示(IR),指出每种表示只适合特定操作,记忆本身应是唯一不可丢弃的持久层。

技术 › LLM Ashwin Gopinath 2026-09-0114.7 KB 9K 109 72

Agent Memory 模块综述:按记忆类型梳理代表性架构与开源项目

本文系统梳理了大模型 Agent 的记忆系统,指出其远不止保存聊天记录,而是包含记忆写入、抽取、冲突处理、检索、重排、遗忘等完整环节。文章将 Agent Memory 分为工作记忆、情景记忆、语义记忆、程序性记忆、时间与关系记忆、共享记忆六类,并逐类介绍代表性开源项目:如 LangGraph、LlamaIndex Memory、Microsoft Agent Framework、Generative Agents、Mem0、LangMem、Letta、A-MEM、Graphiti、Cognee、HippoRAG 等,分析各自设计思想、适用场景与局限性,为构建生产级 Agent 记忆系统提供了实用参考。

技术 › Agent Smartpig 2026-08-2323.7 KB 4.7K 9 80

AI驱动的智能书籍知识图谱工具DeepRead

文章介绍了开源工具DeepRead,它能将书籍转化为智能知识图谱。通过AI自动提取书中的人物、事件、概念和地点,并挖掘深层关联,以可视化立体网络呈现,支持多维度探索和一键跳转。用户可在线体验《三体》《红楼梦》《西游记》等经典示例,也可自建部署,将任何书籍转换为交互式知识库,帮助读者突破线性阅读局限,构建立体知识体系,真正提高阅读效率。

技术 › 工具与效率 Denzii 2026-08-231.9 KB 47

RAG 治不了 Agent 记忆过期:时序上下文的四个机制与开源路线实操

文章剖析了标准 RAG 在处理新旧事实冲突上的结构性缺陷:向量检索没有时间轴、不理解'取代'关系,只能把矛盾甩给模型猜测。作者提出时序上下文的四个核心机制——有效期标记、取代关系、软删除与遗忘、审计日志与证据链,并以 Graphiti 和 OpenContext 两条开源路线为参照讲解落地方式。OpenContext 提供基于时序上下文图的 remember/recall/improve/forget 四动词 API,在数据层解决事实过期问题;Graphiti 则专注作为可插拔的时序知识图谱记忆引擎。文末用律所预算变更案例演示了完整代码流程。

技术 › Agent AYi 2026-08-1822.8 KB 63.8K 159 86

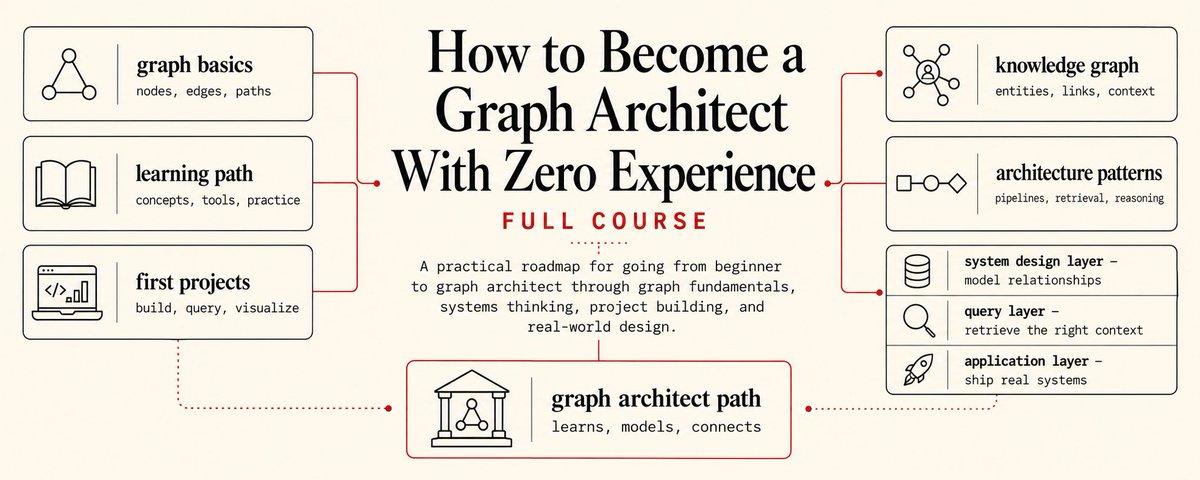
How to Become a Graph Architect With Zero Experience (Full Course)

本文介绍了如何从零开始成为一名图架构师(Graph Architect),这是一个新兴的AI应用领域。文章指出,由于该领域非常新,几乎没有人拥有超过几个月的经验,因此零经验反而是优势。课程分为两个阶段:第一阶段(第1-2周)学习图与检索的区别,并手动进行实体和关系抽取练习;第二阶段(第3-4周)基于Anthropic的官方方法,构建四阶段抽取流水线(提取、解析、组装、查询)。文章强调使用公开免费资源,如Anthropic的cookbook和DeepLearning.AI的课程,并提供了实践提示词。最终目标是掌握知识图谱构建和智能体图设计,使AI系统能够显式地记忆、连接和推理信息。

技术 › LLM CyrilXBT 2026-08-1523.9 KB 753.2K 392 82

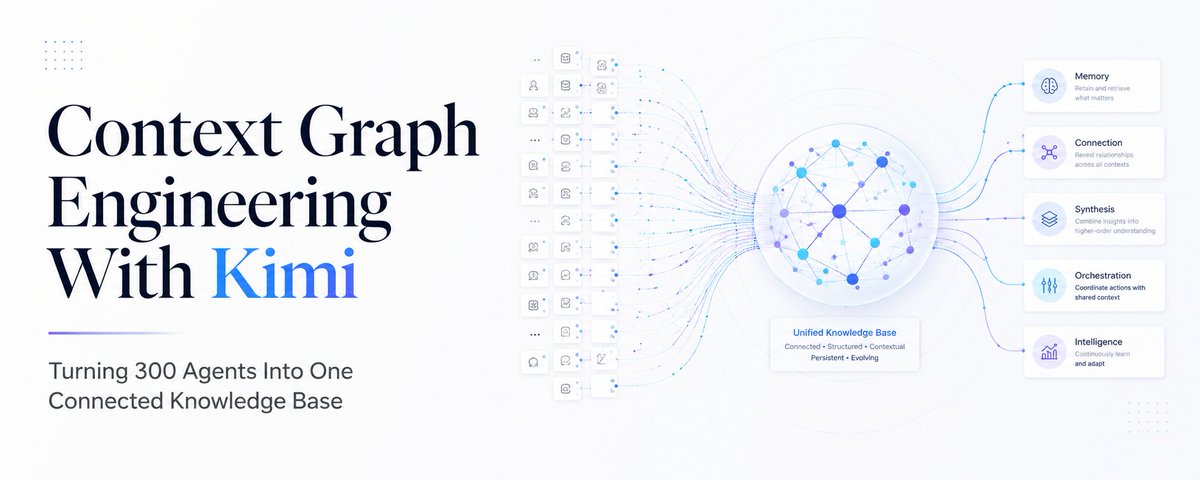
Context Graph Engineering With K3: Turning 300 Agents Into One Connected Knowledge Base

本文介绍了Kimi Agent Swarm如何通过上下文图(Context Graph)将300个并行代理的研究结果整合为单一知识库。文章指出,传统并行代理产生的是分散的答案堆,而Kimi通过将每个实体作为节点、关系作为边,构建可查询、可扩展的图结构,使研究者能发现隐藏联系、提出新问题,并实现知识的持续积累。

技术 › Agent Ricker 2026-08-128.6 KB 838.7K 384 68

Recall:拯救你的文章收藏夹

本文介绍了个人知识管理工具Recall,旨在解决用户收藏大量资料却从不阅读的痛点。Recall支持导入文章、视频和PDF,能自动生成摘要、分类并构建知识图谱。用户可基于资料直接提问,适用于研究、内容创作和复习。作者指出,AI时代的知识管理正从“盲目保存”转向“智能检索”,利用AI在需要时找回正确内容。

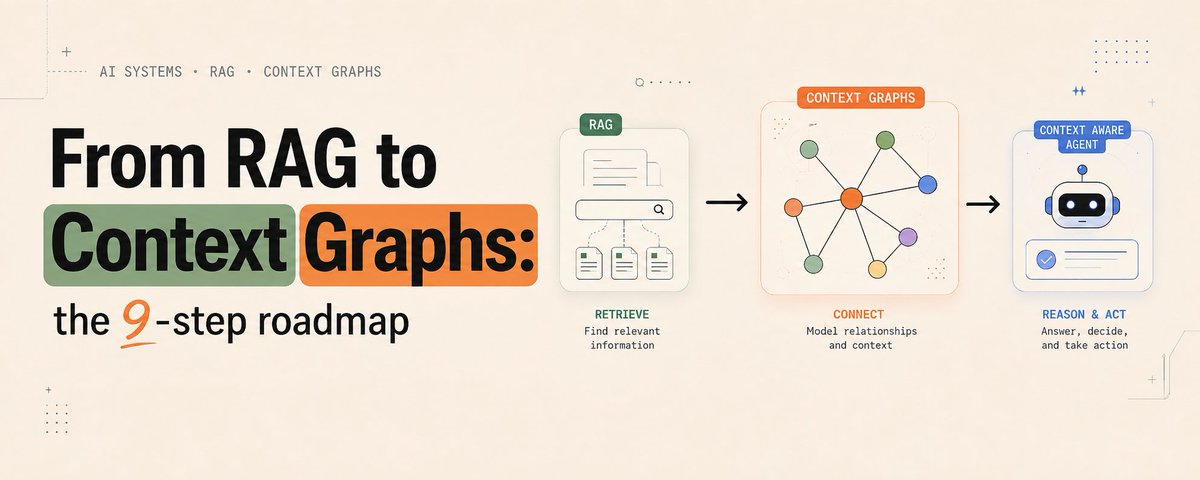
从RAG到上下文图谱:9步路线图

文章探讨了传统RAG在处理多跳推理问题时的局限性,指出检索文本块无法捕捉复杂的实体关系链。为此,作者提出了一种向“上下文图谱”转型的9步实施路线图。该方法通过从文本中提取实体与关系三元组,进行实体规范化以避免图谱割裂,并构建双向边表。图谱通过多源验证分配边权重,并为每条边附加来源以实现精准溯源。最终,检索过程转变为图谱遍历,通过反向可达性分析和路径权重排序,精准定位多跳查询的答案。

技术 › LLM Morlex 2026-08-1011.5 KB 310.6K 465 83

重新理解企业 RAG:从知识工程到 AI 基础设施

本文指出企业级 RAG 绝不仅是简单的文档切块与向量检索,而是一项复杂的知识工程。文章详细拆解了知识入库与用户提问两条流水线,强调了 PDF 结构化解析、混合搜索及权限更新的重要性。在 AI Coding 时代,底层代码可交由 Agent 完成,开发者应更关注 RAG 的架构设计。最终,企业 RAG 的核心价值在于构建一层可被 AI 调用的知识基础设施,从而支撑各类业务 Agent。

技术 › LLM Builder (@UPing123zzz) 2026-08-103.6 KB 71

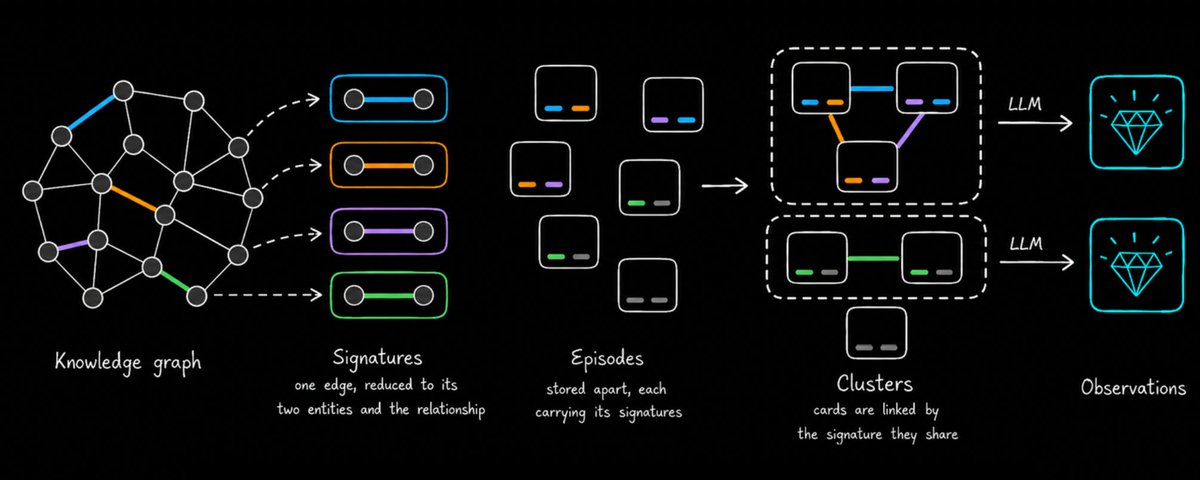
超越事实检索:AI Agent记忆系统中的模式识别与洞察

当前AI Agent的记忆系统虽能准确存储与检索单一事实,却无法像人类一样洞察事实间的结构关联。本文以项目管理为例,指出传统的检索优化无法解决这一局限。为此,Zep平台(开源Graphiti)引入了“Observations(观察)”功能,通过构建知识图谱,结合确定性算法聚类与LLM总结,跨实体分析并生成深度的上下文洞察。这种机制不仅能追溯证据,还能帮助Agent从全局视角识别如“核心阻塞点”等复杂问题。

技术 › Agent Akshay 2026-08-1013.7 KB 106.3K 517 81

Palantir的企业AI部署方法论:FDE与Ontology

随着大模型进入企业级应用,前沿AI能力与实际生产落地之间仍存在巨大的工程鸿沟。本文深入剖析了Palantir的现场部署(FDE)方法,指出将AI接入企业运营的核心在于构建“本体”。Ontology不仅是数据的语义层,还包含动作、逻辑与安全边界。文章结合医院和水处理厂的真实案例,探讨了如何通过定义动词、控制权限,将企业的隐性知识转化为可执行、可审计的系统资产,为AI在企业中的安全落地提供了实践框架。

技术 › Agent Russell 2026-08-0716.3 KB 33K 107 86

图工程:构建全自动化AI开发系统

本文介绍如何摒弃手动单次提示,通过构建AI系统实现开发自动化。以Claude Code为基础,结合上下文规则实现工程化代理;利用循环工程让系统自动发现任务、执行并验证结果;引入图工程作为知识记忆层,通过三元组存储项目逻辑,使模型准确率大幅提升且避免从零开始;最后通过模型路由按任务复杂度自动分配Opus 5或Fable 5,以大幅降低开发成本并成倍提升工作效率。

技术 › Agent Noisy 2026-08-0713.8 KB 292.7K 162 84

如何使用 Opus 5 进行图工程

文章介绍了如何利用 Opus 5 的新特性(如缓存控制和低 effort 模式)低成本构建图记忆。核心在于将提取和遍历分离:提取使用低 effort 和缓存前缀以降低成本,遍历使用高 effort 以保证推理质量。通过优化配置,图工程的成本可降至原本的三分之一,甚至低于向量存储。

技术 › Hermes rody 2026-08-068.7 KB 1.9M 633

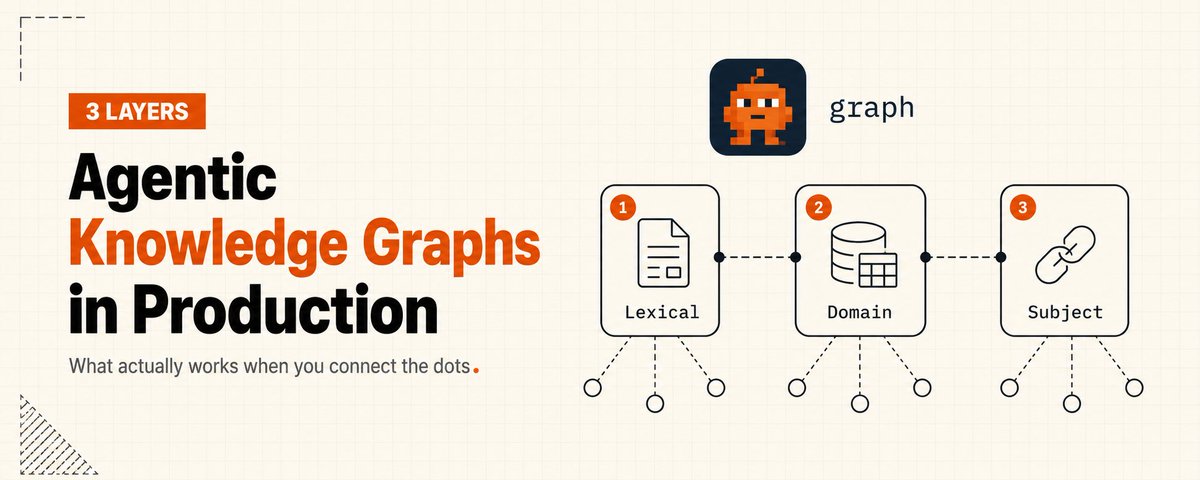
Agentic Knowledge Graphs: what actually works in production

文章探讨了在生产环境中实施智能体知识图谱的实际经验。作者指出,并非所有场景都需要图谱,大部分问题可通过元数据过滤或混合搜索解决。只有当需要多跳连接(如根因分析)时才需引入图谱。建议将图谱分为领域图、词汇图和主题图三层,并从简单的单智能体流程开始构建。

技术 › Agent rewind 2026-08-0649.7 KB 48.5K 66

一名资深AI工程师配合Agent胜过五人团队

文章探讨了AI Agent如何改变工程团队结构,提出了“AI Velocity Pod”模式。该模式由一名资深工程师指挥AI代理,90天内完成了相当于五人团队2-3倍的代码产出。核心在于将瓶颈从编写代码转移到审核判断,通过V.U.E.标准和知识图谱确保质量,大幅降低了协调成本和人力开销。

技术 › Agent Mark Ajzenstadt 2026-08-0611.0 KB 628.9K 153

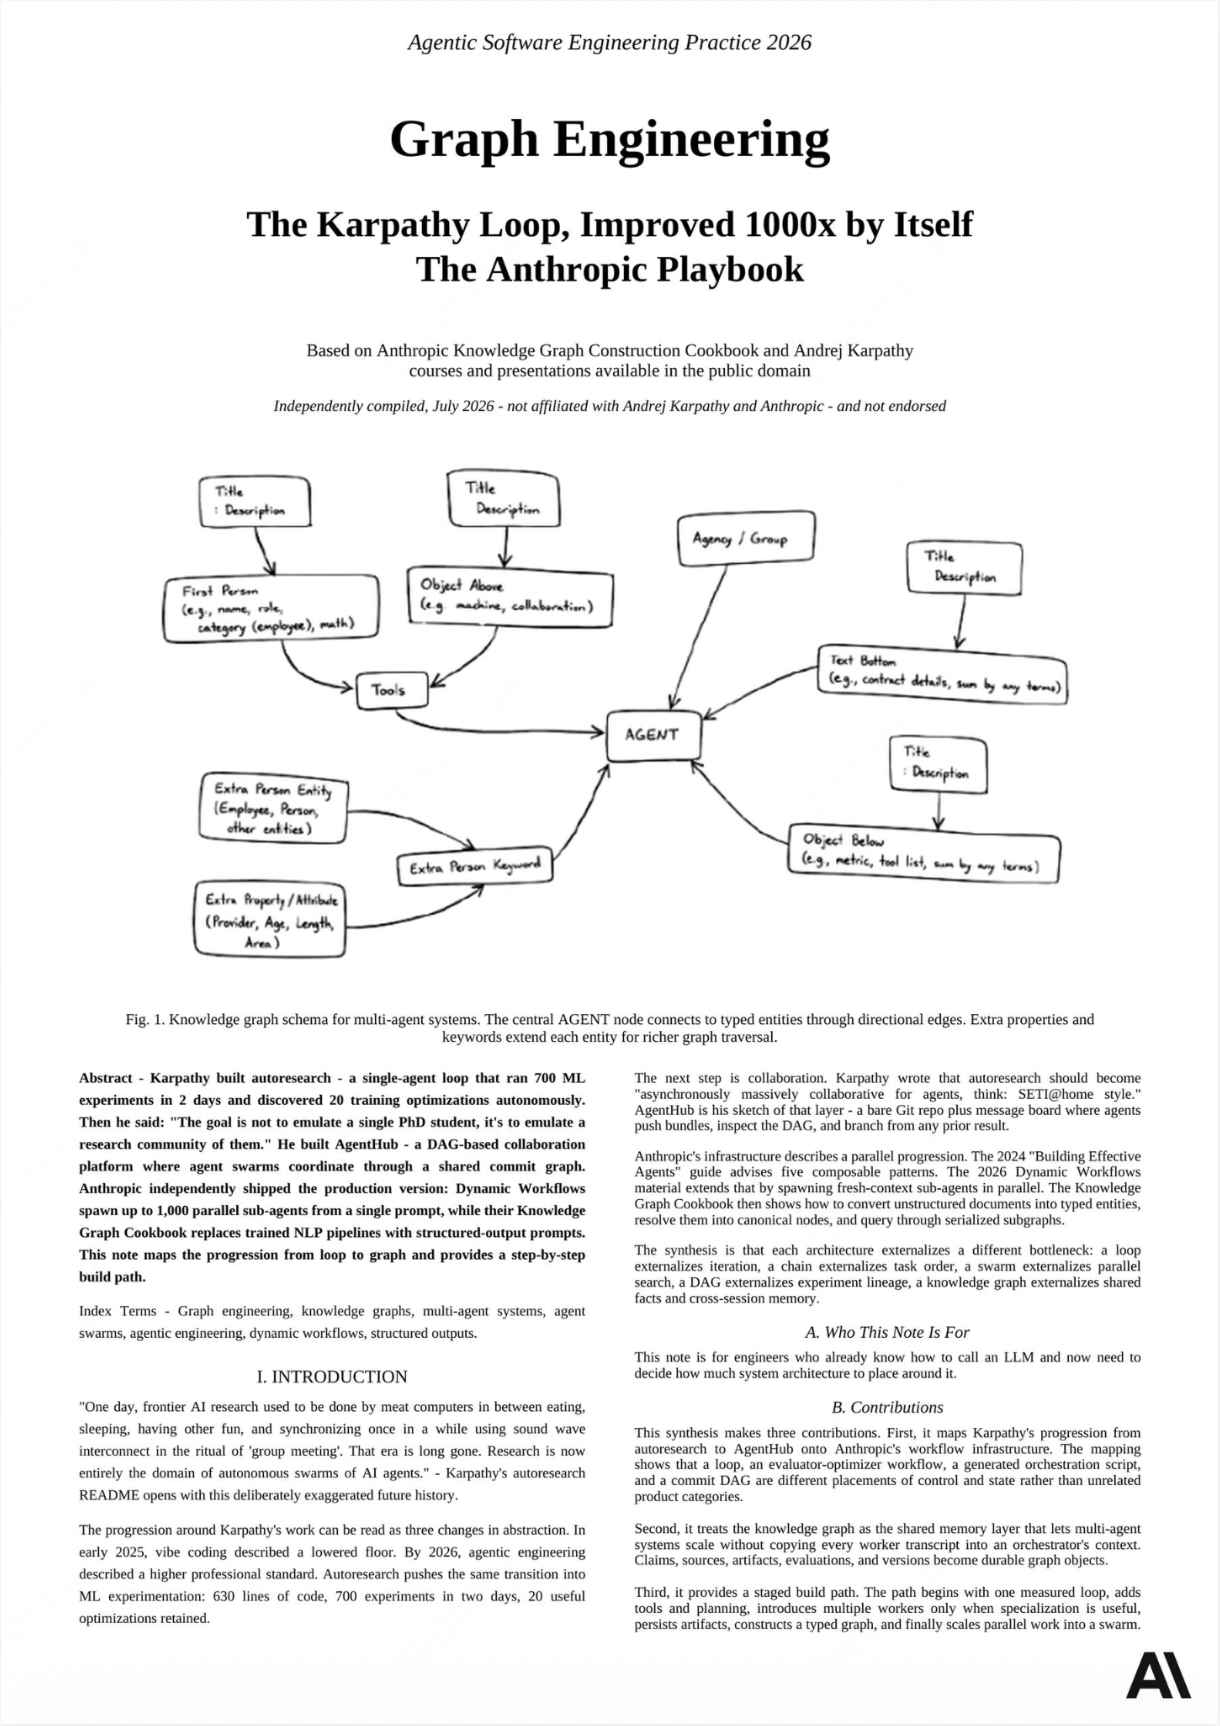
Karpathy 发布 12 页指南:构建自我改进的多代理图

文章解读了 Andrej Karpathy 关于构建自我改进多代理图的 12 页指南。核心内容包括 Loop、Chain、Swarm 等架构模式,以及利用知识图谱作为共享内存的重要性。文中对比了 Karpathy 的工程实践与 Anthropic 的动态工作流,强调了未来 AI 应用的壁垒在于图谱工程和多智能体协作。

技术 › Agent Hux 2026-07-293.1 KB

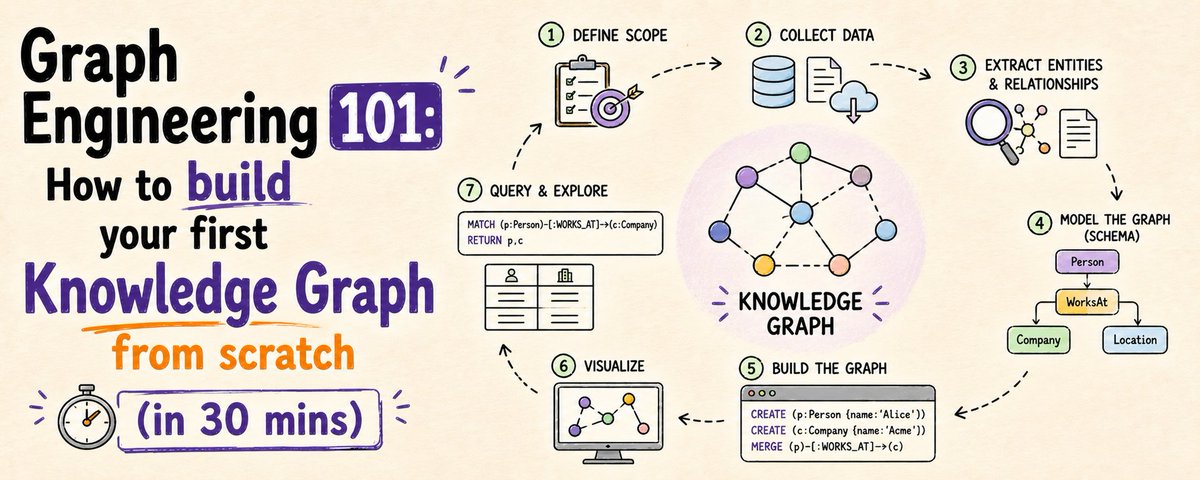
Graph Engineering 101: 30分钟构建个人知识图谱指南

文章介绍了如何在30分钟内从零开始构建一个个人知识图谱。作者认为知识图谱不仅适用于大公司,个人也可以通过简单的工具(如Obsidian)和清晰的结构来实现。文章详细规划了从选择工具、定义实体、创建节点、建立连接到添加查询和习惯的每一步,强调了 intentional connection(有意图的连接)比复杂性更重要。

技术 › 工具与效率 Kanika 2026-07-296.6 KB 24.2K 36

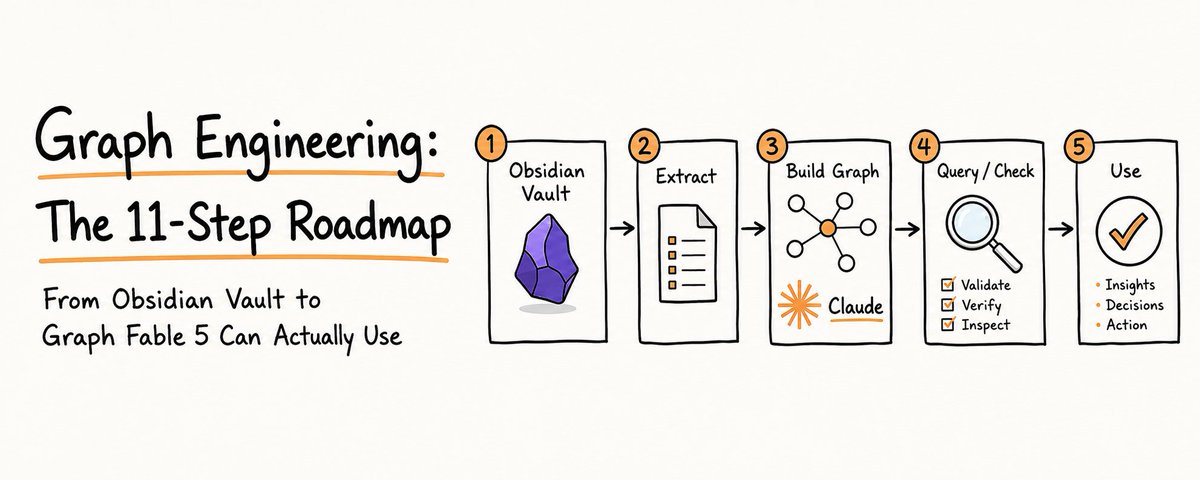
Graph Engineering: The 11-Step Roadmap From Obsidian Vault to Graph

文章指出仅使用 Obsidian 构建笔记库效率低下,AI 读取所有笔记导致成本高昂且速度慢。作者提出了 11 步图谱工程路线图,通过构建路由、索引、节点和边,将“杂乱的文件堆”转化为结构化的知识图谱。这种方法将检索过程从模型调用转变为逻辑匹配,大幅降低 Token 消耗并提升响应速度,实现真正的“第二大脑”。

技术 › 工具与效率 unicode 2026-07-259.8 KB 813.5K 378

Token省35%、工具调用暴降94%!本地知识图谱改变的5个编程习惯

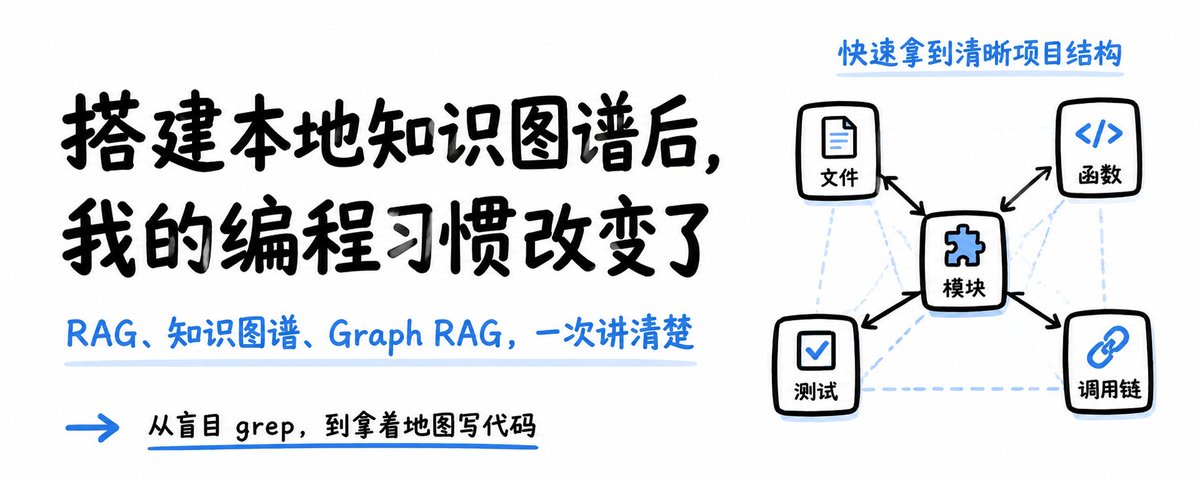
作者分享了使用本地知识图谱重塑编程习惯的经历。文章详细对比了RAG和知识图谱的区别,介绍了Graph RAG的概念,并展示了如何利用开源工具CodeGraph将代码库转化为知识图谱。这一改变使Token消耗降低35%,工具调用减少94%,显著提升了开发效率。

技术 › DevOps 雪踏乌云 2026-06-1710.3 KB 27.9K 166

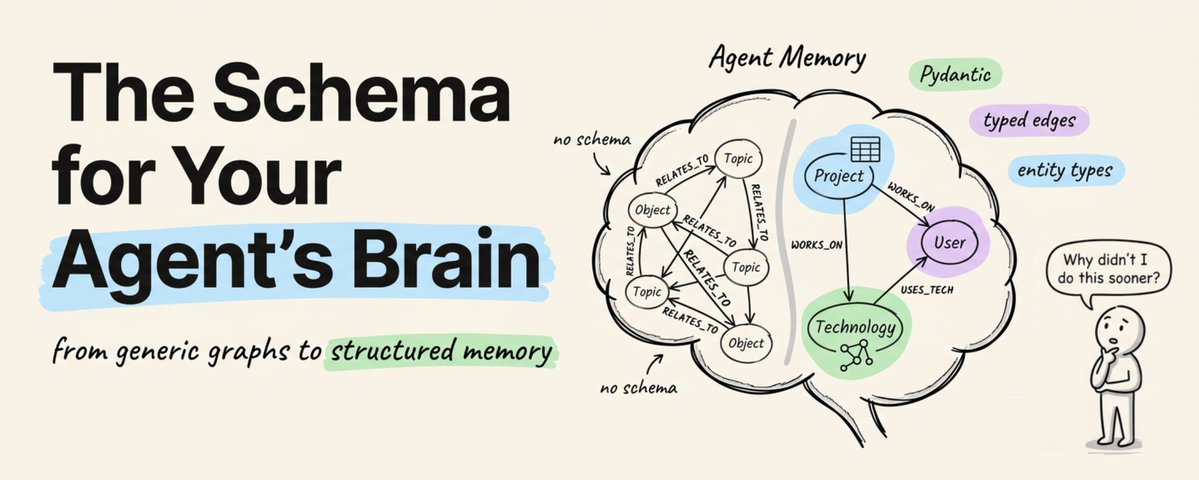
Pydantic fixed my Agent's Memory

文章探讨了如何解决 AI Agent 记忆系统的多跳推理问题。传统的向量数据库在处理跨块事实连接时失效,而通用知识图谱常因缺乏结构导致查询噪音。作者提出的解决方案是使用 Pydantic 提前定义本体(Schema),明确实体类型、关系和属性。通过 Zep 框架强制执行这些约束,可以显著提升提取的准确性和数据的可查询性,从而实现有效的多跳推理。

技术 › Agent Akshay 2026-05-2612.5 KB 312.9K 567 80

GBrain 深度解读:YC 掌门人打造的 AI 知识引擎

GBrain 是 Y Combinator CEO Garry Tan 开源的个人知识管理系统。它突破了传统笔记工具的存取模式,通过集成知识图谱、混合搜索与 LLM 合成能力,实现跨文档的关联理解与自动回答。系统采用 Markdown+Git 存储数据,支持 MCP 集成及 43 种预置技能,目前已在 14 万页规模的生产环境中得到验证。

技术 › 工具与效率 Mr Panda 2026-05-258.5 KB 5.8K 33 83