Wiki 知识库

全部文档 / 作者: Philip Van

16 篇
清除

从零用 AI 做 3D 模型:思路与工具使用流程

文章介绍了一套用 AI 从零制作 3D 模型的完整流程:先用 GPT Image 生成物体的前、后、左、右四视图(人物统一 T 姿势),再上传 TripoAI 通过多视图生成 3D 模型。作者详细讲解了模型精度与面型选择、整体与分件模型的取舍、贴图(全局贴图、Magic Brush 局部修补、PBR 材质、去光照开关)、重新拓扑降面、自动绑骨骼(人形与非人形)以及按用途导出 GLB/FBX/STL/USDZ 等格式。最后用 GPT 生成基于 model-viewer 的单文件 HTML 预览页,实现拖拽旋转、动画切换与截图功能,让模型可直接用于网站或工作中。

技术 › 工具与效率 阿哲Phil 2026-10-029.9 KB 262.8K 542 80

Remotion小白裁缝秘诀Ⅰ:组件和案例演示

本文是Remotion入门系列的第一篇,介绍基于React的视频制作工具Remotion及其常用组件。作者整理了十个官方动态案例,包括旋转文字轮、文字高亮、画中画转场、柱状图、地图飞行、胶囊字幕、示波器、屏幕消息、旋转卡片和液态轮廓,说明各自适用场景。文章还推荐了Remotion Elements、RenderComp Free、RemotionUI、Remocn、snapcn等资源站点,帮助读者通过代码控制视频效果,更顺畅地与AI协作制作产品演示和口播动画。

技术 › 前端 阿哲Phil 2026-09-1621.7 KB 72

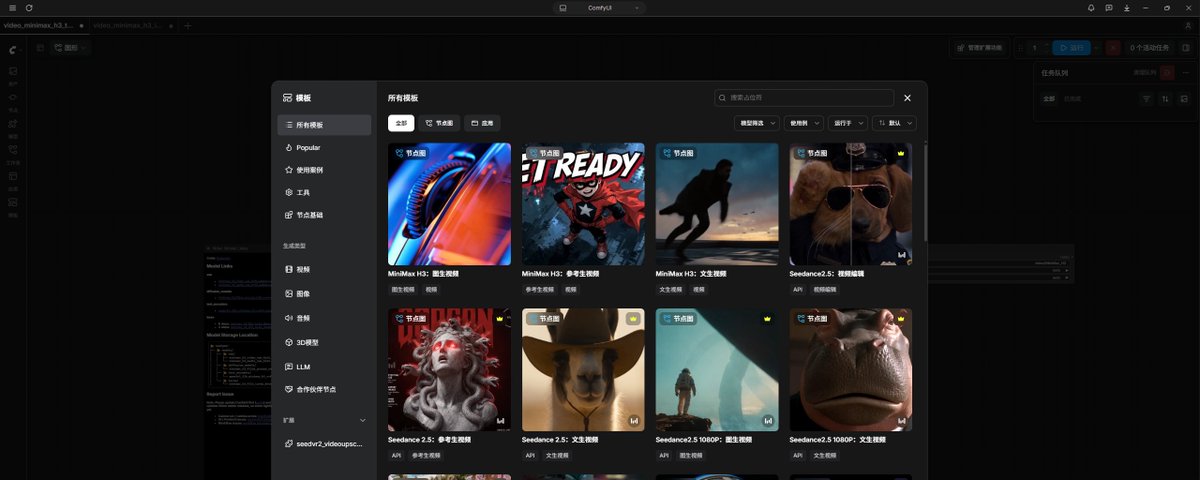
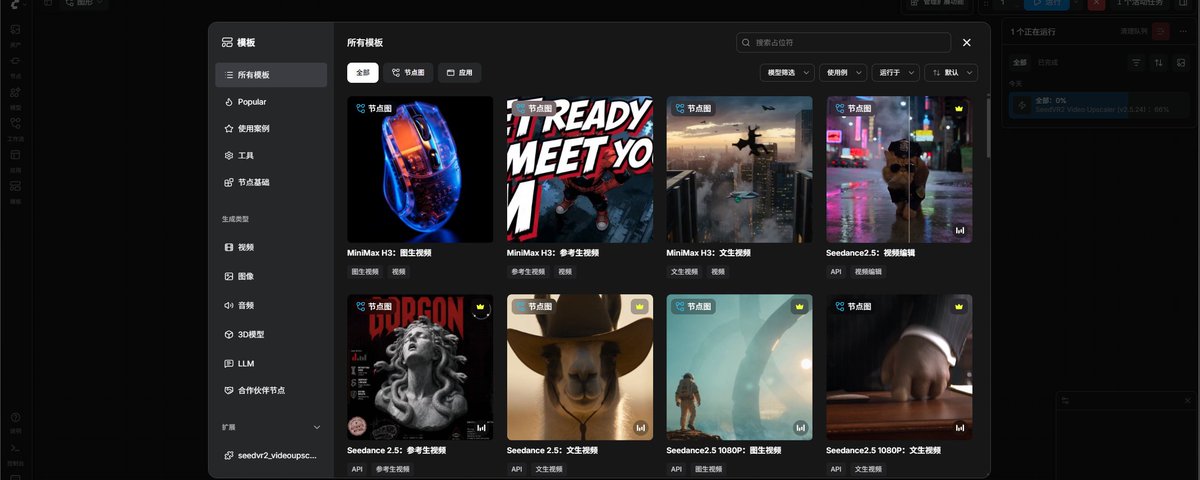
从零开始用 ComfyUI 跑 MiniMax H3(2):官方skill分析与简易示例

本文是 MiniMax H3 视频生成系列第二篇,作者在 4080 12G 显存笔电上用 ComfyUI 本地运行 H3。文章首先分析官方公开的九套 Skills,涵盖产品广告、品牌宣传、纸拼贴、纸艺定格、歌词贴字 MV、3D 动画、手绘实拍融合和双人游戏开场,并附自制案例视频。随后详解 H3 提示词写作规范:先确定任务模式(T2VA/I2VA/FL2VA/L2VA/Ref2VA),为参考素材分工,定义视觉系统,单独列出屏幕文字的进入、可读与退出状态,按时间线写主体动作与运镜,将声音分为剧情内音景与非剧情配乐,规定转场继承方式,并明确结尾定格,最后给出一份可直接复用的 Prompt Spec 模板。

技术 › Skill 阿哲Phil 2026-08-3018.0 KB 33.8K 77 85

从零开始用 ComfyUI 跑 MiniMax H3:本地安装、云端和视频工作流

本文面向新手介绍如何在 ComfyUI 中使用开源视频大模型 MiniMax H3 生成带同步声音的视频。内容包括:检查本地电脑显卡、显存与磁盘空间(建议预留70-100GB);Windows 安装 ComfyUI Desktop 的步骤;不适合本地时使用 Comfy Cloud 云端方案;使用官方 T2V/I2V/R2V 模板生成第一条5秒视频的参数与提示词写法;以及高清修复、多参考素材、首尾帧控制、长视频续拍、局部重绘等进阶工作流,最后给出常见问题排查和最稳学习路线。

技术 › AI视频 阿哲Phil 2026-08-2614.0 KB 309.7K 840 88

20个Agent友好的灵感&设计参考网站合集分享,远离AI-Slop

本文分享了20个对Agent友好的设计灵感与参考网站,旨在帮助设计师和开发者避免AI-Slop(千篇一律的AI生成设计)。文章按实际工作顺序将网站分为三类:先确定视觉方向(如Pinterest、Behance、Awwwards等),再研究真实页面与产品流程(如A1 Gallery、Mobbin、Refero等),最后将参考交给Agent进入设计和代码(如Lucide、shadcn/ui等)。文中还提供了一条避免AI-Slop的工作流,并附有可直接使用的提示词模板,指导如何将设计参考转化为Agent可执行的设计规则。

技术 › 工具与效率 阿哲Phil 2026-08-1519.9 KB 18.8K 58 84

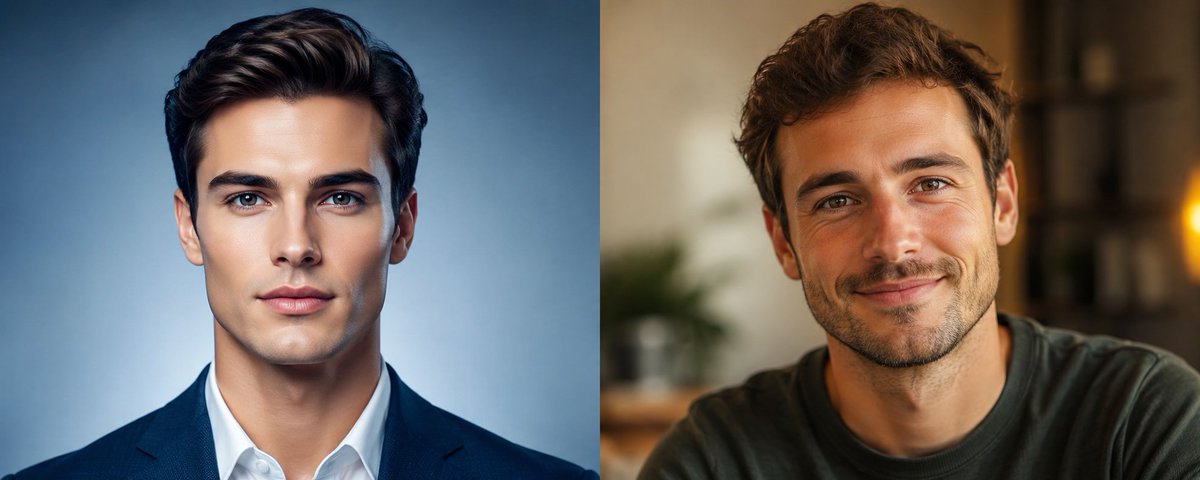
AI人物太假?如何提高数字人的真实感?经验分享

本文针对AI生成人物视频中常见的“一眼假”问题,从皮肤细节、场景匹配、产品适配、角色设定、视频状态、声音同步、制作工具和内容逻辑等多个维度,系统分析了数字人真实感不足的根源,并提出了一套以“先定内容,再出人物”为核心的创作流程。作者强调,真实感并非单纯依赖皮肤纹理等细节,而是人物、场景、动作与产品之间的逻辑自洽。文章还提供了可直接使用的增强真实感的提示词模板,以及关于声音克隆和数字人制作工具(如MiniMax、HeyGen)的实用建议。

技术 › AI 阿哲Phil 2026-08-1113.9 KB 22.8K 64 82

还在用原始对话框?教你用 Obsidian Canvas 与 Agent 协作

本文探讨了传统线性对话框在处理复杂 AI 任务时的局限性,提出了基于 Obsidian Canvas 的非线性协作模式。文章结合学术研究(如 Sensecape、CanvasConvo)和商业产品(如 Copilot Pages、Cursor),展示了如何利用 Canvas 画布作为持久化工作台,让 Agent 理解项目结构而非仅保存聊天记录。作者还介绍了 Obsidian 社区中的 Canvas LLM 和 Cannoli 插件,并总结了如何通过定义颜色、空间和连线规则,实现人与 Agent 在知识库层面的高效协同。

技术 › Agent 阿哲Phil 2026-07-1323.7 KB 55.1K 90

Codex + Image-2 视频产出工作流分享

本文介绍了一种利用代码生成产品视频的高效工作流。通过先使用 GPT-Image-2 生成分镜预览图,确立视觉基准,再将图片交给 Codex 复刻成代码动画。该方法将视觉设计与工程实现拆分,避免了直接编写代码时的不确定性,无需剪辑软件即可产出高质量的产品演示视频。

技术 › Codex Philip Van 2026-05-057.2 KB 747.3K 1.9K 91

不增长就等死:关于消耗型与积累型增长的本质思考

文章指出增长是系统抵抗熵增、保持生命力的基本方式。区分了“消耗型增长”与“积累型增长”,以前者透支未来,后者通过迭代让未来变轻。结合瑞幸与ofo的案例,以及在AI浪潮下个人价值被重新定价的挑战,强调增长的目的在于保留选择权和韧性,而非单纯追求数字。

读书 › 方法论 Philip Van 2026-05-046.8 KB 5.1K 16 76

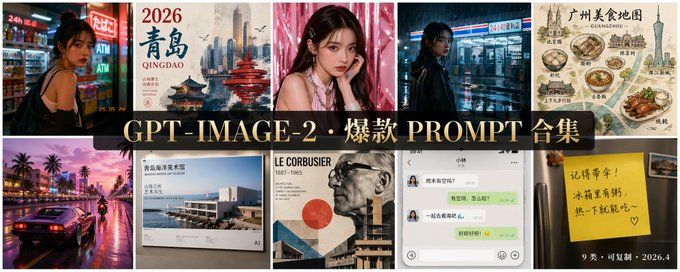
GPT-Image-2 爆款案例合集与提示词分享

文章汇总了 GPT-Image-2 上线后的八大高赞应用案例,涵盖霓虹人像、3x3偶像写真、城市美食地图、短剧分镜、建筑展板及逼真截图伪造等场景。作者提供了可直接复制的完整 Prompt,并分享了利用该工具快速接单变现的实战经验,探讨了 AI 图像生成对视觉设计和信息真实性的冲击。

技术 › OpenAI Philip Van 2026-04-2311.3 KB 657.2K 2.5K 89

Openclaw 热潮过去,才发现Claude Code 有多好!90%的人装完CC第一步就错了

文章指出很多用户安装 Claude Code 后未进行有效配置,导致生产力未被释放。作者提出了两个关键步骤:首先通过初始化引导建立 CC 对用户的记忆(MEMORY.md),使其了解用户身份和工作偏好;其次配置专属工作流(Skill),将重复任务标准化。文中提供了初始化提示词模板及 GitHub 上的 cc-starter-kit 仓库,帮助用户快速搭建个性化的 AI 辅助系统。

技术 › Claude Code Philip Van 2026-04-034.8 KB 37.7K 269 77

NotebookLM 快速上手教程:全能型 AI 研究与笔记工具

本文详细介绍了 Google 推出的 AI 笔记与研究工具 NotebookLM。文章指出其核心优势在于基于用户上传资料进行“零幻觉”的问答与生成,并提供了一份包含11项重磅功能的深度评测,涵盖PPT生成、音频概览、视频讲解、思维导图及闪卡测验等,展示了其在学习、研究及办公场景中的强大应用潜力。

技术 › 工具与效率 Philip Van 2026-03-189.7 KB 523.7K 1.4K 78