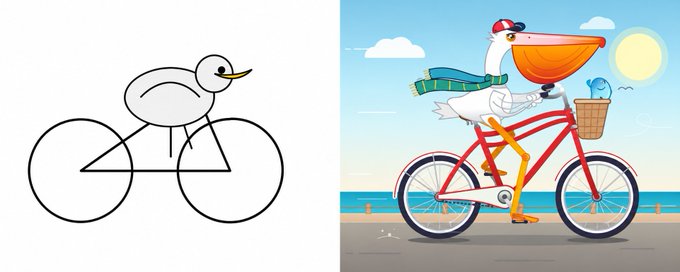
新模型发布,为啥总要画鹈鹕?
文章讲述了“生成骑自行车的鹈鹕SVG”这一AI测试题的来龙去脉。该题源自英国程序员Simon Willison,因同时考验模型的空间几何理解与代码生成能力而成为测试大模型的经典题目。随着模型进步,该测试已趋于饱和,连小体量开源模型Qwen3.6都能击败Claude Opus 4.7,引发其是否沦为“应试科目”的讨论。作者分析了鹈鹕测试依然流行的原因:直观易懂、已成为开发者社区的“开机仪式”,透过这只越来越像样的鹈鹕,能直观感受AI时代的快速发展。
文章讲述了“生成骑自行车的鹈鹕SVG”这一AI测试题的来龙去脉。该题源自英国程序员Simon Willison,因同时考验模型的空间几何理解与代码生成能力而成为测试大模型的经典题目。随着模型进步,该测试已趋于饱和,连小体量开源模型Qwen3.6都能击败Claude Opus 4.7,引发其是否沦为“应试科目”的讨论。作者分析了鹈鹕测试依然流行的原因:直观易懂、已成为开发者社区的“开机仪式”,透过这只越来越像样的鹈鹕,能直观感受AI时代的快速发展。
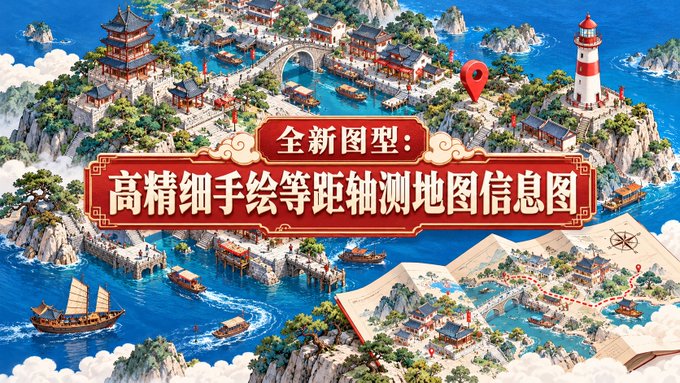
作者为手绘 Skill 库新增图型 IG-037——高精细手绘等距轴测地图信息图,采用 45 度鸟瞰等距轴测微缩视角,包含核心地标建筑、彩色游览动线、独立 Legend 图例与编号索引,适用于景区导览、历史街区漫游、枢纽导视与文创园区等场景。文章展示了五个实测案例:黄山风景区登山导览图、成都宽窄巷子美食寻味地图、北京大兴国际机场无障碍导航图、上海武康路购物漫游地图、成都大熊猫基地亲子探索地图,各案例搭配不同画风与配色,并提供了拿来即用的提示词模板与安装更新方法。
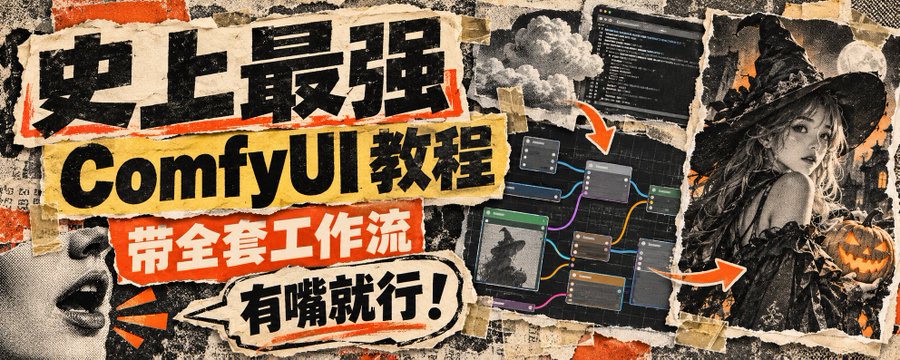
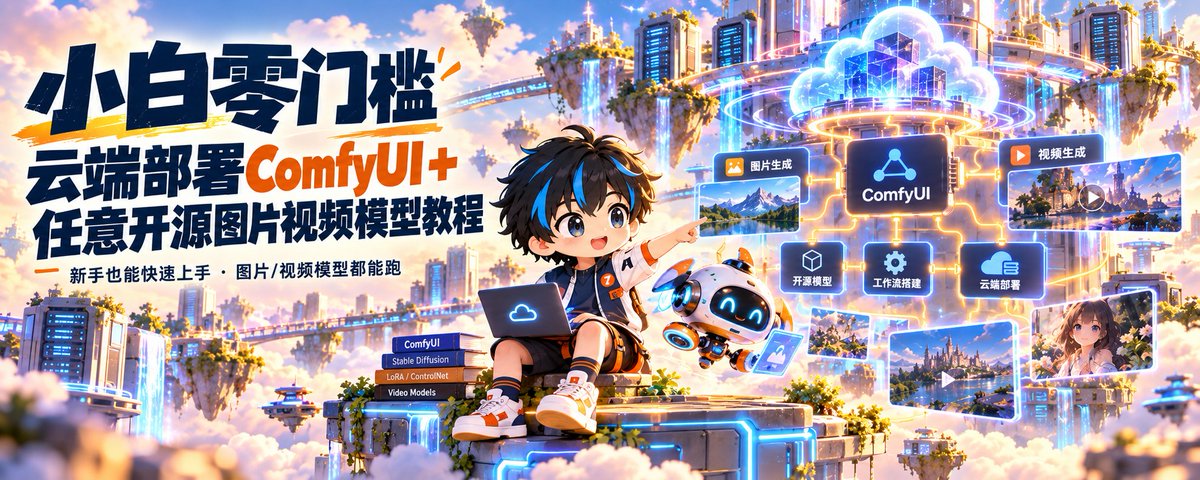
作者分享了零基础也能上手的 ComfyUI 部署教程:租用云 GPU(RTX 4090 48G),把部署工作交给 AI(Codex),一句话完成环境配置,并提示优先使用平台公共模型库避免长时间下载。随后导入现成工作流,通过修改提示词中的中文引号内容生成带文字的海报图。文章还实测对比了 MOSS-Image 与 FLUX 3 Klein 两个 5B 级开源文生图模型,进行八组同题生成和 30 次连续造型编辑实验,给出构图控制适配器的解决方案,并附完整工作流与提示词下载链接。
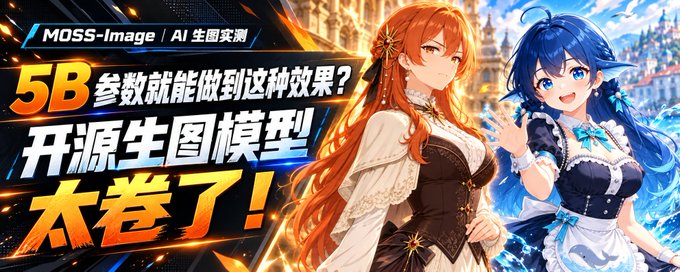
作者使用模思智能开源的 5B 参数图像生成模型 MOSS-Image,为 Claude 和 DeepSeek 设计拟人化角色形象。文章分享了角色设计思路:Claude 采用橙棕奶油配色体现温暖复古气质,DeepSeek 延伸蓝色海洋主题。作者重点介绍了 MOSS-Image 的优势:生成速度快于 Stable Diffusion 和 ComfyUI,支持准确的中英文文字渲染、JSON Layout 布局控制、最长 4K tokens 提示词,并提供 Prompt Enhance 提示词增强功能。模型基于国产 PPU 算力平台训练,已开放 Base 和 SFT 版本权重,支持动漫、写实等多种风格,目前可免费体验。
作者ALEX分享用AI提示词捏出好看且具辨识度的人像方法。文章先提供九种面部搭配的短提示词作为起点,再以实例讲解五官搭配原则:先选定一个突出点(如杏眼),再选择两个配合点(鼻唇、脸廓)进行调整,最后精修整体比例,即三庭分段与横向间距。文中分步演示减薄嘴唇、放柔脸廓、上移鼻底等调整,并强调保留人物特点、区分唇厚与嘴宽等常见误区。核心方法论是'一个突出点、两个配合点、整体比例精修',让人物特点一路延续。
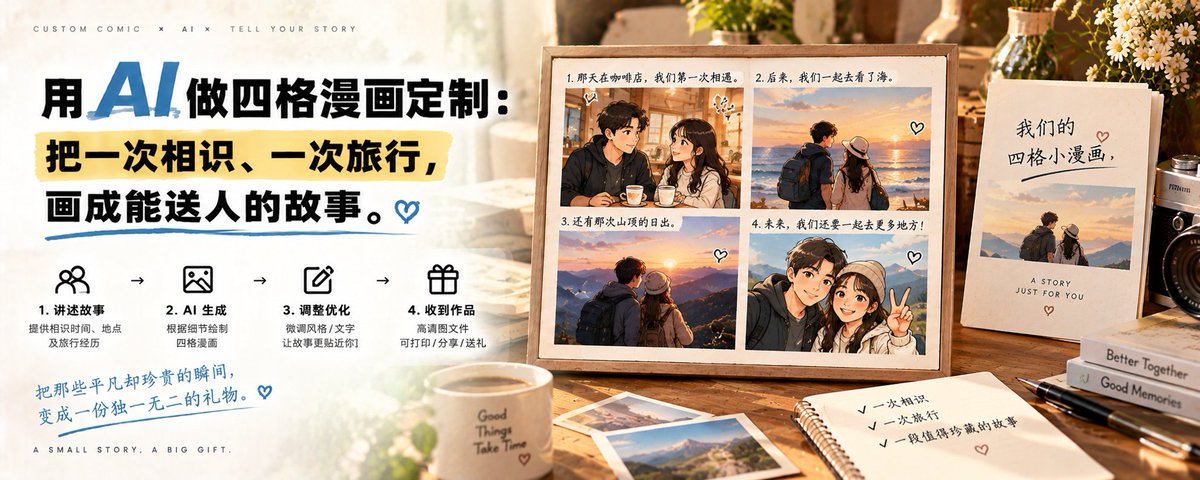
文章介绍了如何用 AI 工具(豆包、即梦、可画)制作个性化四格漫画,将真实经历转化为可赠送的纪念作品。作者详细讲解了从脚本编写、角色设定、分格生成到排版交付的完整流程,强调人物形象一致性、手机端可读性验证,并给出了 49 元的试价策略与成本核算方法,是一份面向新手的 AI 漫画定制实战指南。
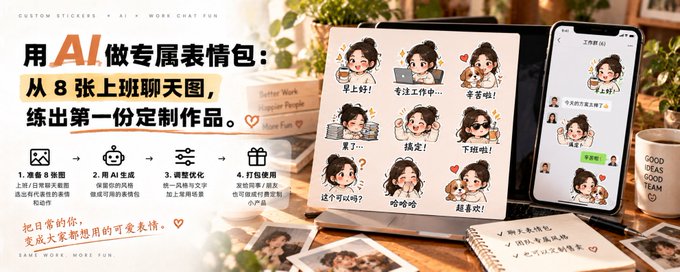
文章介绍如何用 AI 工具制作专属聊天表情包并开展小额定制定价。作者建议新手聚焦一个角色、八句常用语、八张静态图,先做四张投入真实聊天验证使用率。流程包括:用豆包整理动作清单,即梦生成角色与动作(附提示词模板),可画进行 512×512 排字和导出 PNG;验收时需缩小图片检查文字可读性。定价方面以 29.9 元测试需求,并算清工具成本与时间成本,避免越做越亏。最后通过示范对话展示、收集朋友反馈、替换无人使用的句子来迭代作品。
文章介绍了一位 19 岁男生用 AI 生成虚拟女孩在 TikTok 发舞蹈视频变现的完整案例:5 天涨粉 5 万,562 人每月付 9.99 美元订阅,两周收入约 3.6 万元。作者提供了从人设设计、生成定妆照、用可灵动作控制做舞蹈视频、排 30 天更新表、写引流文案、定订阅分层定价到 AI 回复粉丝互动的 7 段可复制提示词,并总结了三大合规要点:必须标注 AI 生成、不得使用真实人脸、避免未成年感内容,是一套 AI 内容创业的实操指南。
文章介绍了 HuggingFace 上 AtomicChat 发布的 Qwen-Image-2.1-Turbo GGUF 量化版及去审查文本编码器。作者澄清该编码器仅移除拒绝倾向,对画图内容几乎无影响,其真正价值在于提供低显存无损量化方案。文章详细记录在 RTX 5060(8G 显存)真机上使用 ComfyUI 部署的完整流程:4 个模型文件的下载与存放、11 节点工作流配置,以及 5 个实测踩坑与解法(工作流 JSON 参数顺序、去噪器/编码器混淆、GGUF 架构识别错误、mmproj 缺失、latent 连接问题)。实测首次出图约 2 分钟,之后每次约 1 分钟,并附 4 组提示词与量化选型表。
作者分享了一个用于生成女性人像的 Claude Skill(beauty-image-defaults),通过 SKILL.md 文件保存人物默认设定和人像美术要求,实际出图由图像生成工具完成。Skill 支持三种模式:无参考时补充默认画像(30 岁左右亚洲轻熟女性,黑发戴眼镜)、有参考图时保留人物特征、以及仅生成提示词。文章详细介绍了默认人物描述、提示词合并方式、皮肤眼神手部衣料光影构图等美术指导、减少稀碎感与塑料感的规则、成图检查流程和冲突处理原则,强调用户要求与参考人物优先于默认设定,并声明不包含任何成人色情内容。
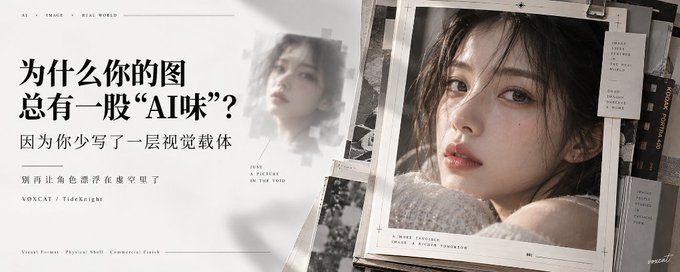
文章探讨了AI生图常带“AI味”的根本原因:角色漂浮在数字虚空中,缺乏“视觉载体”(Visual Format)。作者剖析三大病灶:无边界感、无功能动机、信息层次塌陷,并区分风格、载体与输出规格三个概念,提出“商业完成度=主体×风格锚点×视觉载体”的公式。视觉载体通过语境世界观、触觉通感和强制留白来消解塑料感。最后给出三条工程心法:载体前置、描述物理结构、留白策略,帮助创作者从“画画的人”转变为“视觉导演”。
作者分享了一份云端 GPU 部署教程,用每小时仅两块钱的租用显卡(实测 RTX 4090),在破旧笔记本上跑通蚂蚁百灵刚开源的生图模型 Ming-Image-0.1-Design。文章从选择云平台与机器配置(显存、系统内存、数据盘)、镜像选择、SSH 连接、ComfyUI 启动,到运行官方工作流出图,手把手演示全流程。实测显示模型在商业海报的文字渲染上表现优秀,且 Design-Layer 模型可将设计图智能拆解为多个带透明通道的可编辑图层并自动补全背景。最后提醒下载成果、导出工作流并及时关机以节省费用。
作者分享了一套 GPT Image 2.5 出图的结构化提示词方法论,将画面拆解为身份、物理、摄影、视觉风格四大系统加负面词控制系统,共 17 个层级,并提供 5 层、8 层、15 层三个版本。通过“雨夜便利店”同场景实测对比,展示信息量对出图质量的影响。作者还用蚂蚁百灵 Ling-3.1-flash 模型将 5000 字方法论文档在 24 秒内一次性生成单文件 HTML 提示词拼装工具,支持逐层填写、实时拼接、一键复制,并介绍了将该模型接入本地 Claude Code 的环境变量配置方法与使用体验。
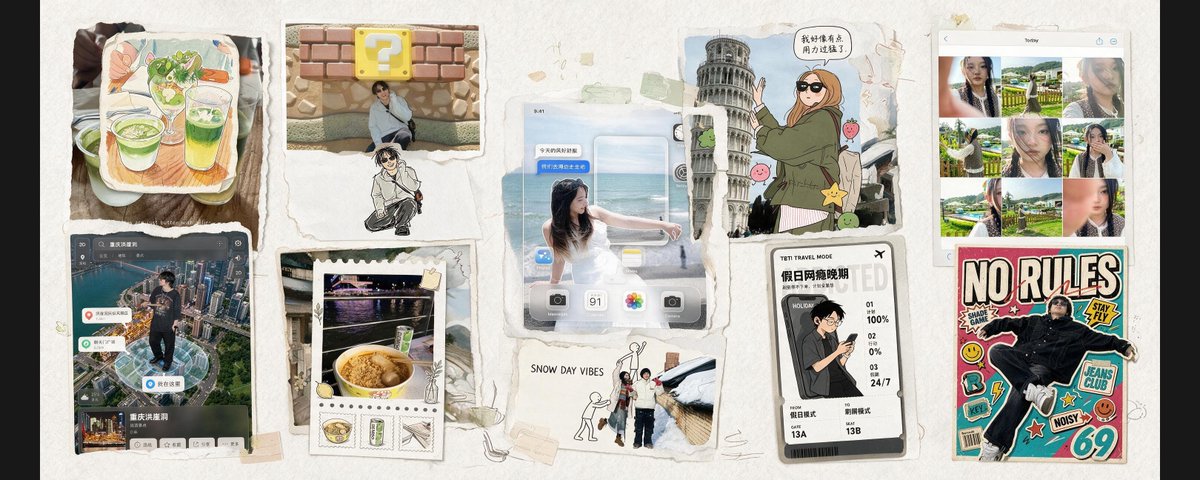
作者整理了 25 种 AI 修图创意玩法,帮助大家拯救旅行中拍废的照片,让朋友圈更好出片。核心工具是元宝内置的 Hy Image3.5 Preview 模型,免费且自带大量模板。文章按旅行照片的三类——人像照、风景照、美食照展开,展示了多种玩法及完整提示词:黑白颗粒感杂志拼贴封面、MBTI 漫画登机牌、美式复古潮流海报、JRPG 游戏任务界面、3D 城市地图定位、真人+手绘漫画结合、抽象涂鸦上下拼接等。每种玩法都附详细 prompt,强调保留原图真实质感的同时进行创意二次处理,适合国庆旅行拍照发布朋友圈使用。
作者分享了一套制作AI趣味短片的高效流程:只需一张角色参考图,借助全能参考模式(Seedance 2.0/2.5、Minimax H3等主流模型)即可生成视频。具体四步为:制作角色图、借助AI改写提示词、选择主流视频模型生成、后期剪辑(配乐、调色、变速裁剪)。文章还介绍了账号运营策略,如打造系列内容或提示词账号,以及变现方式,包括平台播放收益、创作者活动、教程商单和广告植入等。
本文是一篇云端部署阿里 Qwen-Image-2.1 文生图模型的保姆级教程。作者对比了本地部署与云端部署的优劣,横向评测了 AutoDL、恒源云、阿里 PAI、RunPod 等主流 GPU 算力平台,推荐性价比更高的 vGPU-32GB(RTX 4080 SUPER 32G)显卡,时租仅 1.58 元。随后以 AutoDL 为例,详细讲解了从选机、环境初始化、安装 Diffusers 依赖、解决系统盘存储不足的避坑技巧,到通过 ModelScope 通道拉取 30G 满血权重并用 Diffusers 出图的全流程,最后用 Gradio 十行代码搭建 WebUI 面板,实现单张 1024×1024 图片 31 秒生成,并支持原生 RGBA 透明通道输出。
文章介绍了源自游戏美术与场景设计的631原理(60%空间基底、30%叙事陈设、10%视觉锚点),并将其迁移到AI图像与视频生成中。作者通过车站、霓虹街区等多个AI生成对照案例,讲解如何在配色、光照、细节密度上建立视觉主次关系,避免画面杂乱无焦点。文章还结合《布达佩斯大饭店》《沙丘》《寄生虫》等电影场景,拆解空间底盘、人物生活、剧情重点三个功能层次,最后给出可直接复用的场景提示词结构模板,帮助读者写出有主次、易调整的文生图提示词。
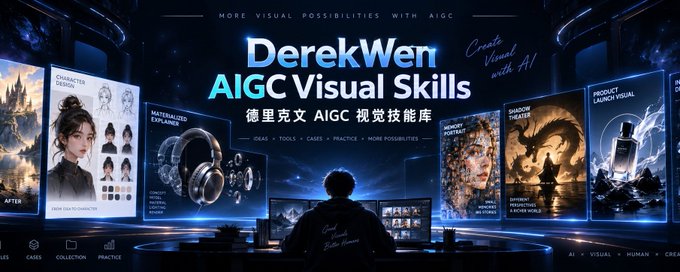
作者将平时积累的AI视觉创作经验整理为开源项目Derekwen AIGC Visual Skills,包含30条案例记录、10个可复用Agent Skills和16个公开视觉图例。项目把提示词、参考条件、关键控制点整理成统一数据结构,并配Gallery示例图方便按效果查找。涵盖角色设定板、多参考图融合、品牌视觉、社媒配图等场景,解决角色一致性、素材组合等常见问题。支持直接用生图工具改提示词,或通过Agent接入Skill两种使用方式,采用MIT许可。
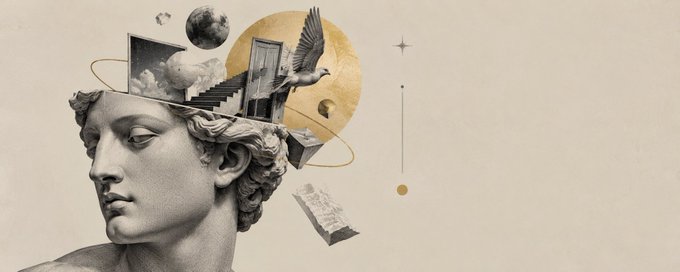
作者分享了一套可复用的 AI 封面生成提示词,融合古典雕刻与现代编辑设计两种视觉语言:背景使用低饱和莫兰迪色,主体为黑白雕塑、人体局部与复古物件,辅以铜版画、蚀刻、钢笔画般的细密线条。文中给出完整提示词模板,涵盖风格、背景、主体、配色、构图、隐喻、氛围与禁止项等规则,强调先提炼主题核心关系,再转化为简洁有力的视觉隐喻,生成高级、极简、有编辑感的概念封面图。
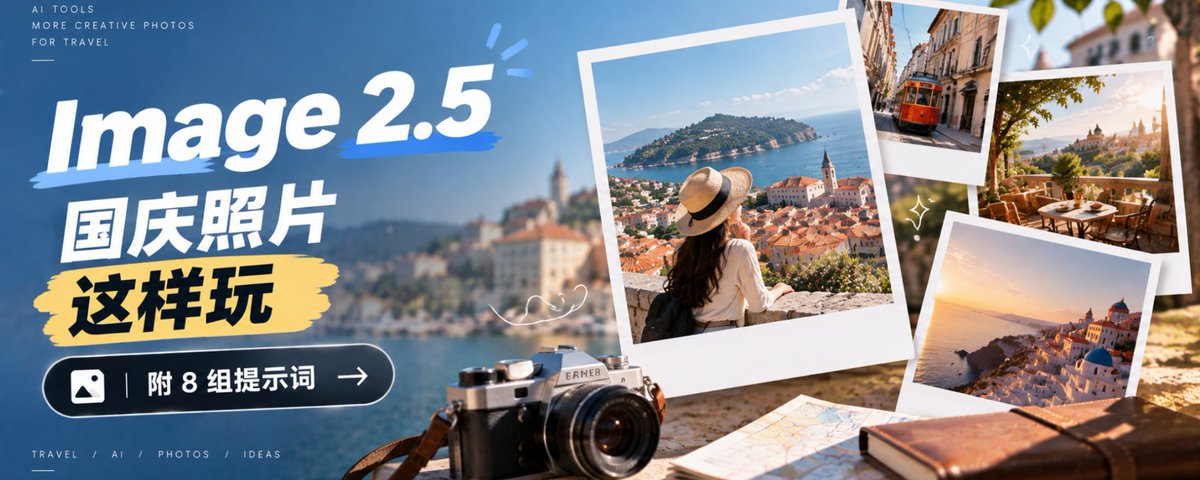
文章介绍了用 ChatGPT Images 2.5 玩转国庆照片的 8 组实用提示词玩法,包括给吃喝照片加手绘日记装饰、让宠物担任旅行团团长、把家庭合照做成电影海报、将孩子的画作变成毛绒玩具效果图、生成 90 年代风格年代照、制作假期专属表情包、把旅行照做成双层明信片以及将旅途囧事画成四格漫画。文中详细说明了每组的照片选择、提示词内容和修正技巧,免费账号即可使用,也提供了即梦等替代工具。
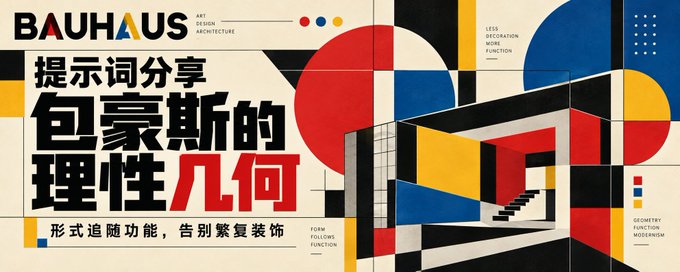
作者分享了一套包豪斯风格的AI绘画提示词,突破以往极简风格,追求复杂但有秩序的视觉构成。提示词详细定义了主题几何转译、包豪斯设计逻辑、信息密度、构图系统、几何层级、色彩系统、字体构成、平面感优先、现代化表达、应用场景适配与避错方向等规则,可将人物、星座、MBTI、运动等主题转译为几何构成作品。文章附有多幅示例图与完整可复用的提示词模板。
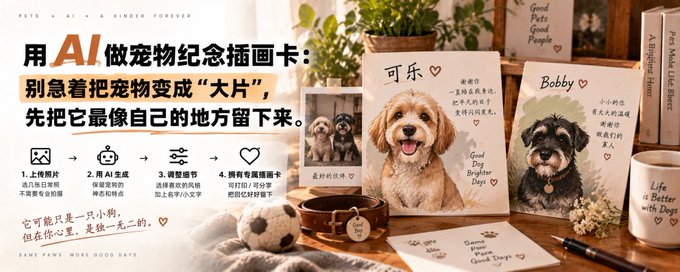
文章介绍如何用 AI 制作宠物纪念插画卡这一小型数字交付服务。作者强调不要急于把宠物照片变成“大片”,而应保留歪耳朵、斑点等最易识别的特征。建议新手从单只宠物、单一画风的基础款做起,定价 19.9 元测试市场。核心流程包括:先写特征卡再让 AI 绘图、一次出 4 张预览择优、人工核对眼睛耳朵等细节、用 Canva 完成排版并手动输入文字、分四步交付(低清确认、限制修改、导出多版本文件、交付说明)。最后建议先用自己的宠物做样品,通过前 5 单记录数据沉淀为固定流程,实现稳定交付。
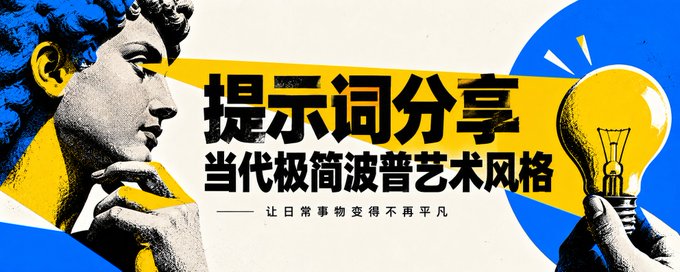
作者分享了一套用于生成「当代极简波普艺术」图像的提示词。该风格继承了波普艺术对大众文化符号的重新编码(放大、重复、裁切、错位),同时用极简主义做减法:一个概念、一个主体、少量颜色、大胆留白。提示词详细规定了视觉隐喻的构建、非对称构图、2-4色色板、文字作为视觉元素参与版式、材质控制,以及针对小红书封面、公众号、推特、海报、专辑封面等不同场景的适配策略,并附有生成前自检清单与最终设计原则。
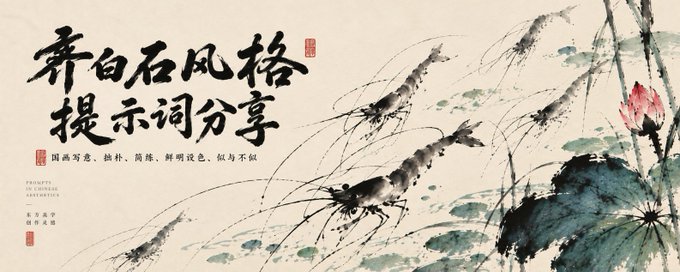
作者以国画大写意学习背景为基础,用 GPT-Image2.5 复刻齐白石笔法,并公开了一套完整的图像生成提示词。该提示词总结了齐白石风格三大特点(大笔挥洒、见笔见墨、笔笔可数),通过主题、主色、核心物象、视觉动势、应用场景与画幅等填空式输入,生成融合大写意精神与当代中式极简设计的艺术海报。文中详细规定了笔墨语言、似与不似原则、色彩体系、构图留白、题跋印章等视觉标准,并提供小红书封面、手机壁纸、艺术海报等多场景适配方案。
文章介绍了手绘skill中251号风格——儿童蜡笔手绘绘本风,这种画风自带高亲和力、元气感与治愈属性,适合制作四大类内容:一是亲子育儿与幼儿启蒙内容,如果蔬食育科普、好习惯打卡卡片、认知闪卡;二是治愈系打工人与情绪生活文案,借助低幼风格的反差感实现解压效果;三是农品、烘焙与健康消费品牌视觉,如包装贴纸、礼盒插画、宣传海报;四是社交周边,包括表情包、壁纸、手帐素材。文章还引用了作者整理的200多种画风的手绘风仓库,可通过选择编号直接出图。
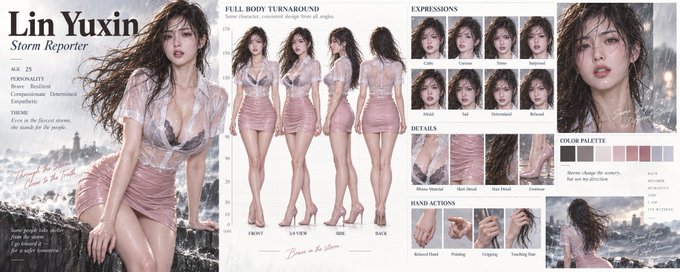
文章介绍了如何制作 AI 角色设定板(Character Sheet)以实现人物一致性控制,这是打造 IP 和提升作品留存率的关键技能。作者将角色卡视为一张角色视觉定义图,分四个步骤讲解:一是通过正面、侧面、背面多视角固定角色的脸部特征与整体造型;二是通过表情、微表情、姿态和手部动作增强角色表现力;三是补充发型、服装材质等细节说明以提升质感;四是结合图像生成工具与完整提示词模板进行实操。核心原则是所有小图都服务于中心主形象图,为 AI 提供一份'角色说明书'。
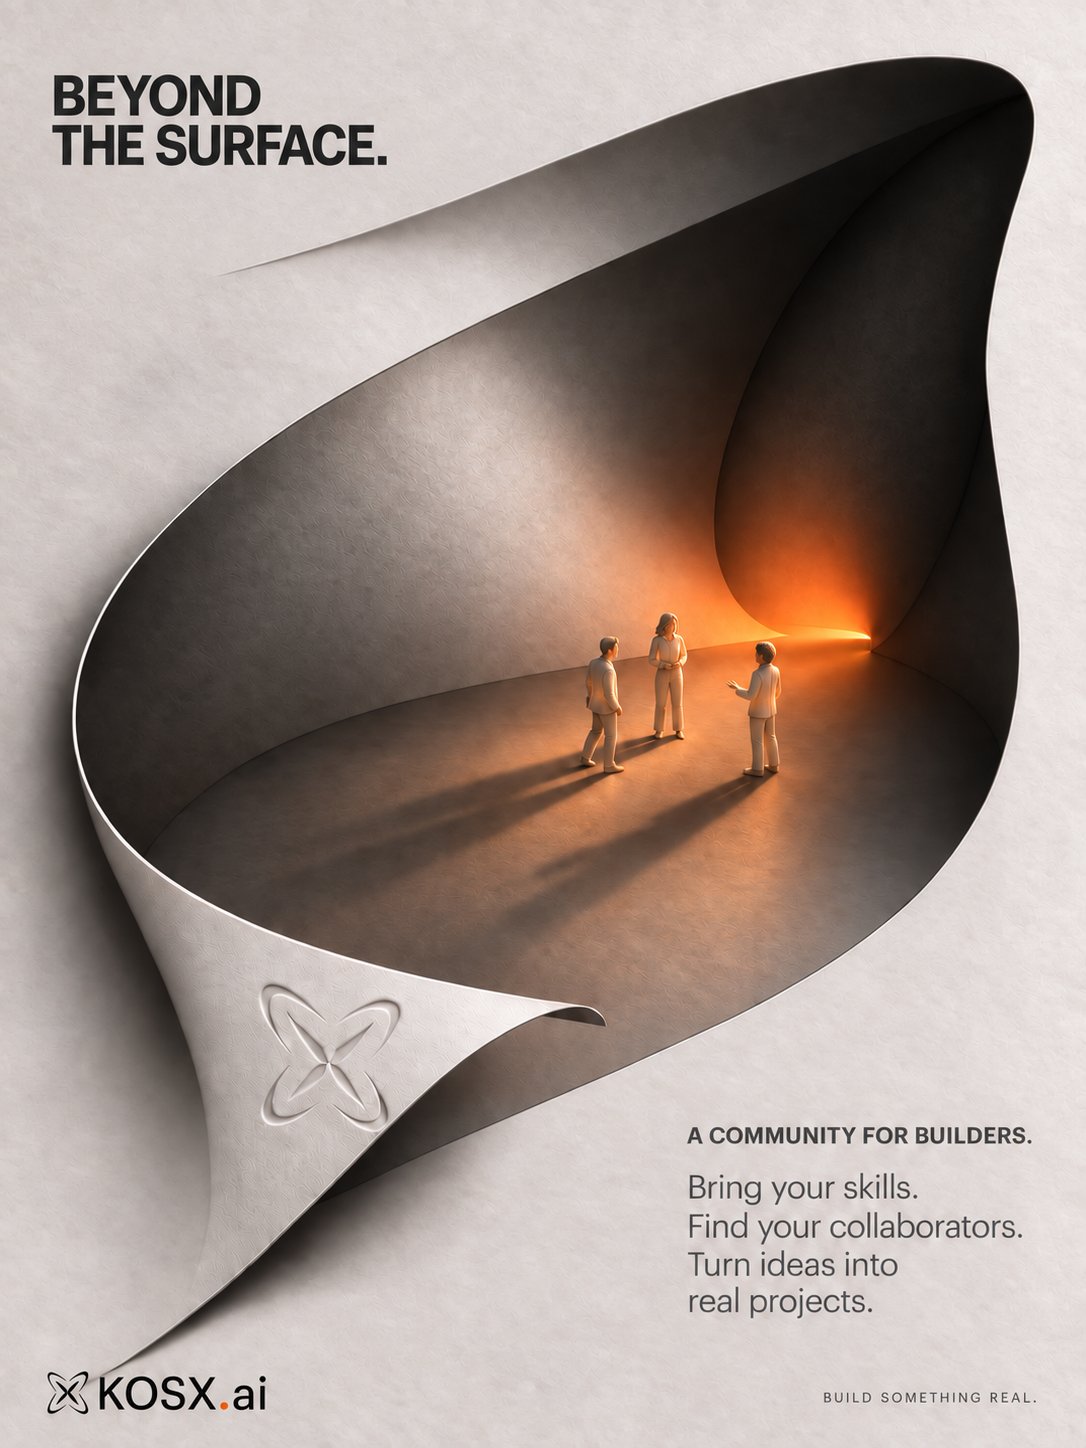
作者以KOSX社群实习生的身份,分享对该社群的看法与感谢。作者因一条评论被刘哥邀请加入KOSX,并受益于其青年实习计划——在注重实习经验的求职环境中,社群愿意给年轻人机会。作者还讲述了参与社群视觉挑战的作品创作思路:用一张薄纸打开后藏着更大空间的意象,表达"被看见,是开始"和"不要只看表面"的理念,画面中人物自带微光,象征能力在被认可前就已存在。作品通过Codex协作构思并生成,最终表达KOSX开放包容、促成协作的社群精神。
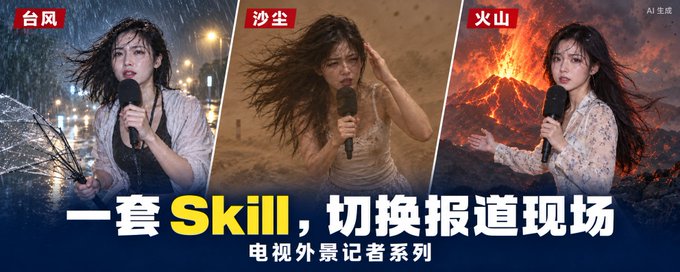
作者分享了一个用于生成电视外景记者现场图的完整 Skill。用户只需将文章和人物照片发给具备生图能力的 Agent,即可生成台风、火山、沙尘暴、农村山区、音乐节、公园街访等场景的记者报道图,人物、服装和字幕均可自定义。默认输出横版 16:9、简体中文字幕,含 LIVE 角标、话筒和新闻标题。文章详细说明了使用方法、参考图用途区分、各场景提示词模板,以及 Skill 的完整规则,涵盖构图版式、环境光照设计、成像风格、中文字体、生成与修正流程,并默认添加「AI 生成·情景演绎」标识以防止滥用。
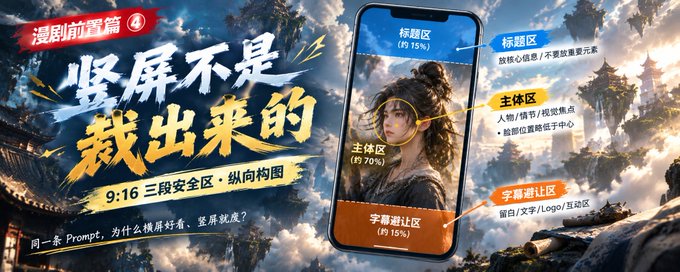
文章讲解 AI 生图中画幅对构图的决定性作用,重点介绍 9:16 竖屏的写法。作者提出横屏讲左右关系、竖屏讲上下关系的核心原则,给出基于 1080×1920 分辨率的三段安全区(标题区、主体区、字幕避让区),并总结竖屏必写 Prompt 词、三种景别的处理方法,以及漫剧制作中的限制:双人不能左右并排、运动方向应纵向、画幅全剧一致。还简要介绍 1:1 头像、3:4 小说封面、16:9 横版的构图要点,并提供六步画幅适配流程。
本文整理了 OpenAI 发布的 GPT Image 2.5 图像模型的使用指南。新模型在保留参考照片中人物与物体特征、局部修改集中性、多轮编辑稳定性方面显著提升,生成延迟最高降低约 50%。文章介绍了 ChatGPT 中新增的草图、模板、图片批注功能,以及 API 中的 Flare 和 Sunburst 两个模型定位差异。核心内容是官方提示词指南的 8 条基本建议,并配以 21 段官方示例,涵盖照片生成、信息图、广告、标志设计、界面预览、图片编辑、透明背景提取、草图转化、物体移除及多轮修改与角色延续等常见任务,可作为实用参考手册。