如何在单GPU上部署5个模型
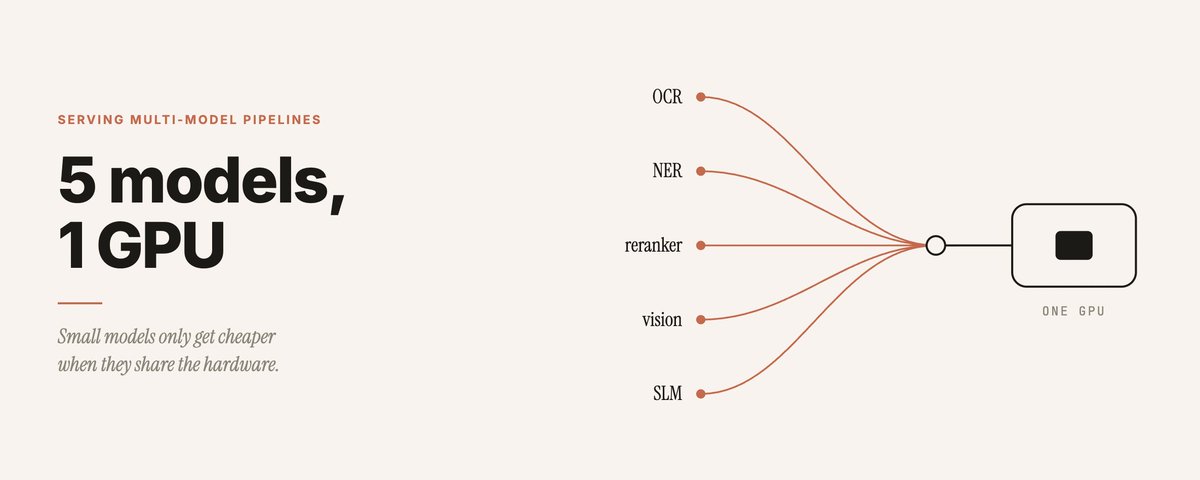
本文探讨了如何在一个GPU上通过服务层高效部署多个专用模型(SLM、OCR、NER、Reranker和物体检测)。文章分析了多模型流水线面临的资源碎片化和GPU闲置成本问题,提出了通过共享GPU、动态加载和内存优化来降低成本和提升利用率的技术方案。
本文探讨了如何在一个GPU上通过服务层高效部署多个专用模型(SLM、OCR、NER、Reranker和物体检测)。文章分析了多模型流水线面临的资源碎片化和GPU闲置成本问题,提出了通过共享GPU、动态加载和内存优化来降低成本和提升利用率的技术方案。
