Wiki 知识库

全部文档 / 标签: 大模型部署

3 篇
清除

从单机到双机:小白靠 AI 助手跑通 124B 大模型的完整记录

本文记录了一位非计算机出身的普通用户,借助 AI 助手,成功在双节点 NVIDIA DGX Spark 上部署蚂蚁百灵 124B 参数的 Ling-3.0-flash 模型,并完成单机 FP4 与双机 FP8 的对比评测。文章详细介绍了从模型下载、SGLang 编译、单机部署到双机配置、公网 API 开放的全过程,并提供了性能数据、踩坑清单和 AI 协作方法论。核心结论是:双机在长输入预填充上优势明显(2.2倍),但解码速度提升有限;上下文长度是硬约束,单机 FP4 适合日常任务,双机 FP8 适合长文档处理。
技术 › LLM Xiangyu 香鱼 2026-08-1916.2 KB 172.2K 163 86

Palantir的企业AI部署方法论:FDE与Ontology

随着大模型进入企业级应用,前沿AI能力与实际生产落地之间仍存在巨大的工程鸿沟。本文深入剖析了Palantir的现场部署(FDE)方法,指出将AI接入企业运营的核心在于构建“本体”。Ontology不仅是数据的语义层,还包含动作、逻辑与安全边界。文章结合医院和水处理厂的真实案例,探讨了如何通过定义动词、控制权限,将企业的隐性知识转化为可执行、可审计的系统资产,为AI在企业中的安全落地提供了实践框架。

技术 › Agent Russell 2026-08-0716.3 KB 33K 107 86

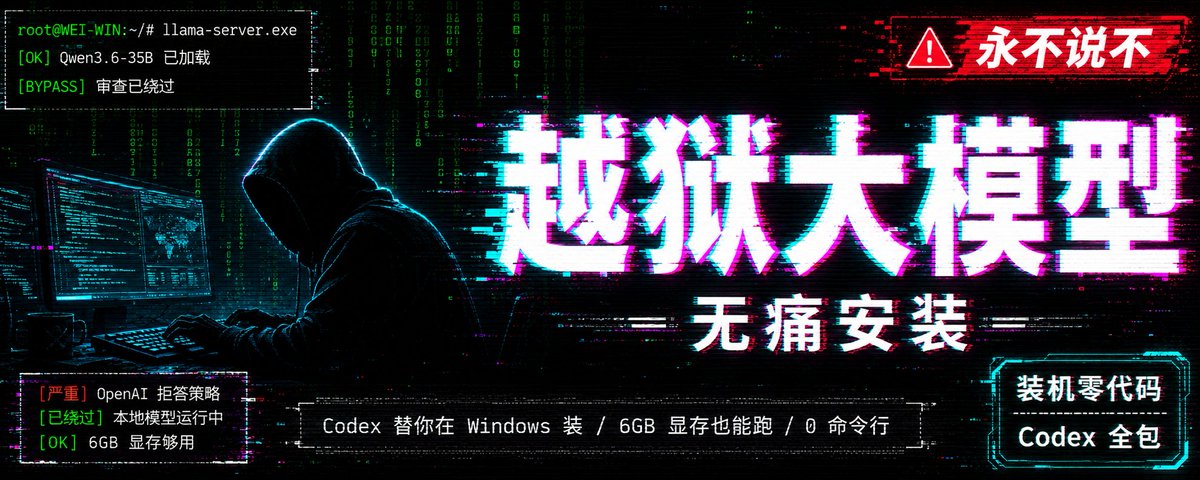
35B 越狱版大模型:Codex 替你装,6GB 老卡也能跑

本文介绍了一种利用 Codex 桌面应用在 Windows 上本地部署 35B 无审查大模型的方法。通过 llama.cpp 和 MoE 架构的量化模型,即使用户只有 6GB 显存的显卡(如 GTX 1660)也能以 30 t/s 的速度流畅运行。文章详细讲解了无需命令行知识、利用 Codex 自动完成环境配置、模型下载及脚本编写的全流程,实现了零门槛的本地高隐私 AI 体验。

技术 › Codex Wei 2026-05-2823.3 KB 129.4K 232 92