Wiki 知识库

全部文档 / 标签: 张量并行

3 篇
清除

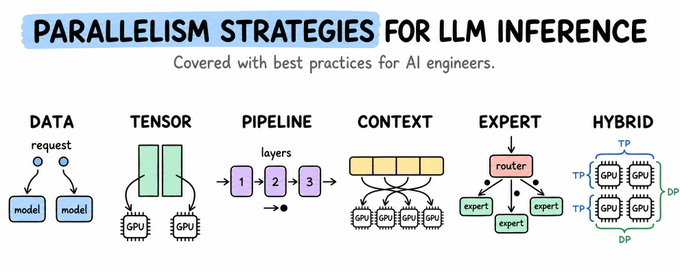
Parallelism strategies for LLM inference, clearly explained

本文系统讲解了 LLM 推理的多 GPU 并行策略。首先介绍推理的两个阶段(Prefill 影响 TTFT,Decode 影响 TPOT)以及部署中的四大资源限制(参数内存、KV-cache、计算、通信),然后通过五个关键问题框架分析各类并行策略:数据并行(复制完整模型、分区请求)、张量并行、流水线并行、上下文并行和专家并行。文章强调选择布局需权衡内存容量、请求延迟和吞吐量,避免通信开销超过硬件承受能力,并给出部署检查规则,帮助读者根据模型、硬件拓扑和工作负载选出合适的布局。

技术 › LLM Avi Chawla 2026-10-0629.4 KB 29.4K 178 82

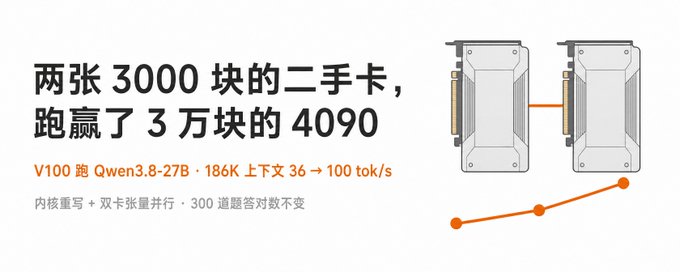
万字爆肝长文丨两张 3000 块老卡跑赢 3 万块 4090 48G:一次讲透怎么老显卡把 Qwen3.8-27B /NInfer跑到极致

作者详细记录了用两张二手 V100(各 3000 元)运行 Qwen3.8-27B 大模型的完整优化过程。V100 是 2017 年的数据中心显卡,HBM 显存带宽实测达 1004GB/s,甚至高于 4090。文章先建立测试口径与性能分析框架(读权重与读 KV 缓存两笔账),逐步排查瓶颈:验证带宽不是问题、测试双卡张量并行、分析 PCIe 延迟与 NCCL 版本坑,最终通过重写推理引擎内核、添加双卡支持,将长上下文生成速度从 36 tok/s 提升到 100 tok/s 以上,代码生成速度超过 3 万元的 4090 48G,并成功上线生产环境。文中深入浅出讲解了推测解码、CUDA Graph、内核优化等技术细节。

技术 › LLM huangserva 2026-10-0489.4 KB 141.5K 319 89

从单机到双机:小白靠 AI 助手跑通 124B 大模型的完整记录

本文记录了一位非计算机出身的普通用户,借助 AI 助手,成功在双节点 NVIDIA DGX Spark 上部署蚂蚁百灵 124B 参数的 Ling-3.0-flash 模型,并完成单机 FP4 与双机 FP8 的对比评测。文章详细介绍了从模型下载、SGLang 编译、单机部署到双机配置、公网 API 开放的全过程,并提供了性能数据、踩坑清单和 AI 协作方法论。核心结论是:双机在长输入预填充上优势明显(2.2倍),但解码速度提升有限;上下文长度是硬约束,单机 FP4 适合日常任务,双机 FP8 适合长文档处理。

技术 › LLM Xiangyu 香鱼 2026-08-1916.2 KB 172.2K 163 86