全部文档 / 标签: 显存
3 篇

本地大模型当导演,从此看片不求人
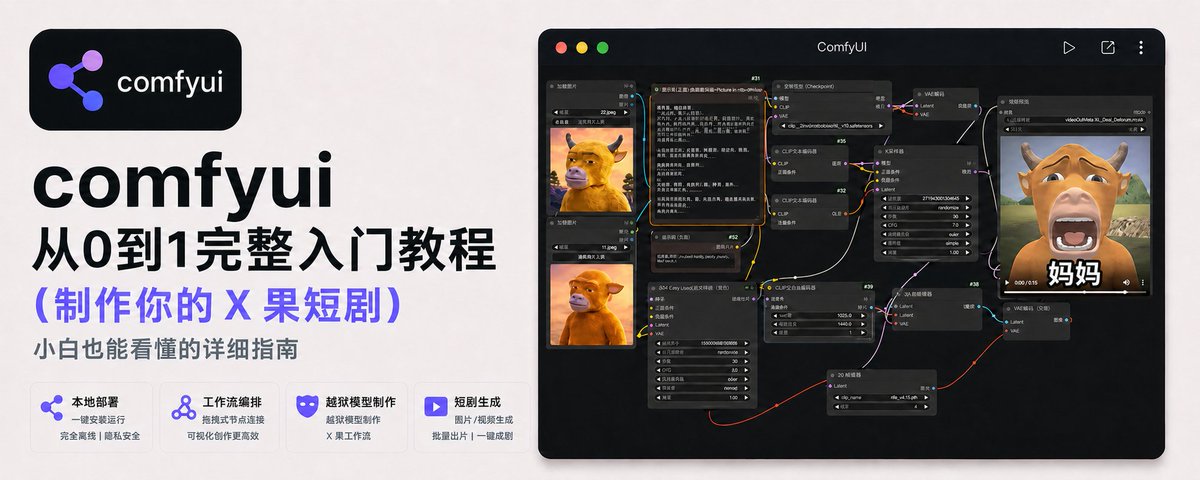
这是一篇面向小白的 ComfyUI 本地 AI 出图与生视频完整教程。文章介绍了 ComfyUI 的节点连线原理与硬件要求(显存 8GB 起步),详解安装方法(推荐秋叶整合包)、模型文件的正确存放目录、跑通第一张文生图流程;随后推荐了可商用的 Z-Image Turbo 模型并给出完整配置,再讲解用 Wan 2.2 做文生视频、图生视频和首尾帧过渡的玩法,提示词要描述动作与镜头运动。最后介绍如何使用官方模板库和社区工作流,以及通过替换越狱编码器实现未审查模型生成短剧视频的方法。

一次性讲清楚 Qwen3.8 27B 的本地部署
本文详细介绍如何在本地部署阿里开源的 Qwen3.8 27B 模型,覆盖 Mac 和 N 卡两条路线,并附 4090 实测数据。作者通过四轮质量测试发现 9.83GB 压缩版在短任务上与 30GB 版本打平,指出 12GB 游戏卡即可运行。文章系统讲解硬件选型、量化版本选择、KV Cache 显存计算、MTP 加速配置及常见踩坑,强调窗口大小只占显存不影响速度这一关键认知,是一篇面向零基础用户的完整部署指南。
