Wiki 知识库

全部文档 / 标签: 吞吐量

3 篇
清除

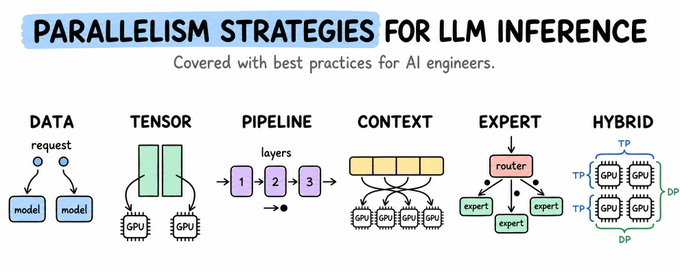
Parallelism strategies for LLM inference, clearly explained

本文系统讲解了 LLM 推理的多 GPU 并行策略。首先介绍推理的两个阶段(Prefill 影响 TTFT,Decode 影响 TPOT)以及部署中的四大资源限制(参数内存、KV-cache、计算、通信),然后通过五个关键问题框架分析各类并行策略:数据并行(复制完整模型、分区请求)、张量并行、流水线并行、上下文并行和专家并行。文章强调选择布局需权衡内存容量、请求延迟和吞吐量,避免通信开销超过硬件承受能力,并给出部署检查规则,帮助读者根据模型、硬件拓扑和工作负载选出合适的布局。

技术 › LLM Avi Chawla 2026-10-0629.4 KB 29.4K 178 82

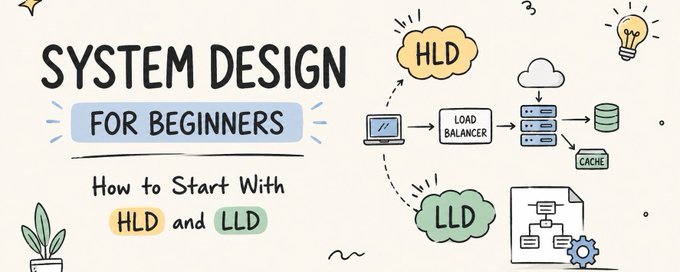
System Design for Beginners: How to Start With HLD and LLD

本文面向系统设计初学者,清晰区分高层设计(HLD)与低层设计(LLD)。HLD关注系统整体架构,如组件交互、数据存储与扩展性;LLD关注代码级细节,如类、对象与设计模式。文章强调两者缺一不可,并深入讲解请求流程、延迟与吞吐量、垂直与水平扩展等核心概念,为初学者提供了一条清晰的学习路径。

技术 › 后端 Harshit Khosla 2026-09-1475.9 KB 61.3K 1.1K 61

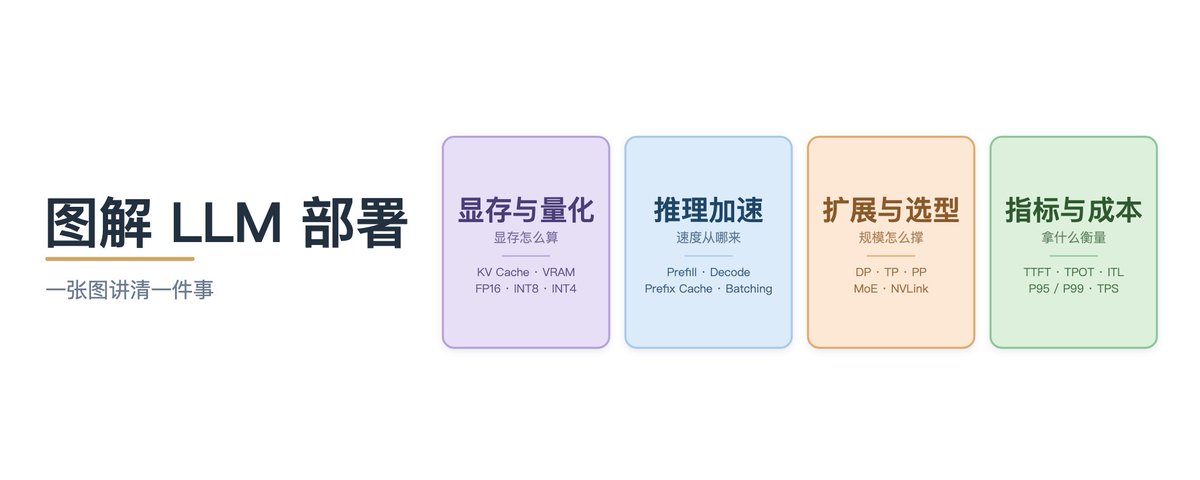
图解大语言模型部署

本文系统讲解大语言模型自部署的核心指标与实践要点,覆盖延迟类指标(TTFT、TPOT/ITL、P95/P99)、吞吐类指标(TPS、QPS、连续批处理)、资源类指标(显存与KV cache计算、量化精度)、服务质量(错误率、探针、可用性)以及成本核算(cost per token、TCO)。作者以 Ling-3.0-Flash MoE 模型在 DGX Spark 上的真实实测为例,将抽象指标落地为具体数字,帮助读者选对硬件配置、排查吞吐瓶颈与OOM问题、评估自建与API的划算临界点。

技术 › LLM WquGuru 2026-08-2927.1 KB 56.2K 199 89