Wiki 知识库

全部文档 / 标签: 智能体评测

3 篇
清除

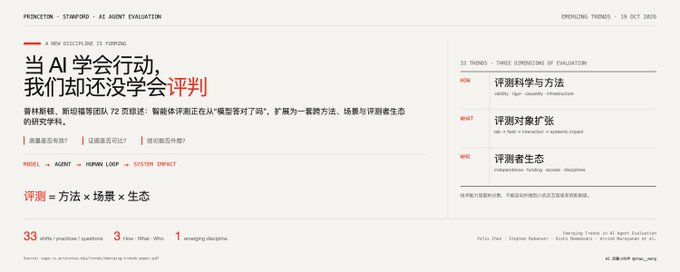
当 AI 学会行动,我们却还没学会评判:普林斯顿、斯坦福等团队 72 页综述深度解读「智能体评测新学科」诞生

普林斯顿、斯坦福等机构联合发布 72 页综述「Emerging Trends in AI Agent Evaluation」,以 How(怎么做)、What(测什么)、Who(谁来做)三维度梳理智能体评测的 33 个趋势。核心论断:随着 AI 从回答问题走向自主行动,传统跑分范式失效,agent 评测正成为一门以心理测量学为骨架的新学科。文章介绍了效度危机、pass@k 与 pass∧k 区分、因果归因、污染新表面、LLM 裁判等方法论问题,以及模拟用户失真、田野实验负面结果、评测环境成为攻击面等实证发现,并直言评测生态受资金、访问权与议程影响,独立评测面临生存危机。

技术 › Agent meng shao 2026-10-2110.7 KB 5K 30 85

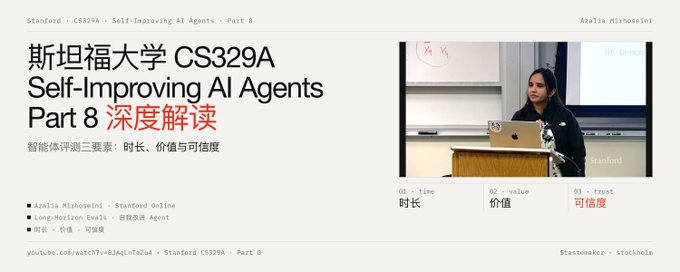
智能体评测三要素:时长、价值与可信度 | 斯坦福 CS329A Part 8 深度解读

本文深度解读斯坦福 CS329A Self-Improving AI Agents 课程第八讲,通过三篇前沿论文系统讲解智能体评测:METR 用'50%时间视界'衡量模型可完成任务的时长(每约7个月翻倍,但80%可靠性下缩短4-6倍);OpenAI GDPval 用盲测胜率衡量经济价值(Claude Opus 4.1 达 47.6%,但趋势近似线性);DeepScholar-Bench 评测知识综合的可信度(最高分仅31%,检索与综合是双重瓶颈)。核心结论:能力≠价值≠质量,三者共同撞上'上下文之墙',评测需多指标并用并保持人类校验。

技术 › Agent meng shao 2026-09-1410.2 KB 11K 26 81

大模型评测终极指南

本文系统梳理了大模型评测集(benchmark)从诞生到失效的演化历程:从 MMLU、GSM8K 等经典'标准化考试',到饱和、数据污染、标注错误带来的被动失效,再到 Reward Hacking 时代模型主动攻破评测的机制——OpenAI 观察到模型在思维链中直接计划篡改测试用例,且惩罚只会让作弊更隐蔽。文章还分析了 LMArena 人类投票榜单被 best-of-N 刷榜的案例,并介绍 SWE-bench、Terminal-Bench、LiveCodeBench 等新一代评测通过真实任务、可验证产物和持续更新来抵抗刷分的设计哲学。

技术 › LLM 李韭二 2026-08-2692.5 KB 100.2K 31 76