Wiki 知识库

全部文档 / 标签: LMArena

4 篇
清除

7个AI一手信息源推荐:告别二手料,直奔源头

作者抱怨每天花两小时刷X只能看到别人嚼烂的AI二手信息,提出应该直接关注一手信息渠道。文章推荐了7个AI信息源:AI News(每日AI社区动态汇总)、The Batch(吴恩达团队AI周报)、Hugging Face Papers(社区热门论文)、alphaXiv(论文讨论区)、arXiv(一手论文源)、LMArena(大模型真人盲测平台)、Artificial Analysis(模型质量速度价格对比工具)。作者强调信息差的关键在于是否蹲守源头,而非知道多少。

技术 › LLM candy (@shenxiankk) 2026-10-082.1 KB 65

Lies, Damned Lies, and Benchmarks

文章批判当前 AI 基准测试被过度优化的现象(benchmaxxing)。作者指出,当公共评测与巨额关注和资金挂钩时,实验室会通过训练相似数据、筛选上百个实验设置等方式变相刷分,基准测试随之失去了衡量通用智能的意义。文中列举了 Meta Llama 4 在 LMArena 测试多个私有变体、评测机构随舆论反复修改指数、厂商选择性引用榜单等案例,并指出 MMLU、GPQA 等基准早已失真。作者呼吁实验室诚实披露数据缺陷、用户自行做私有评测,并宣布 TypeSafe 将不在模型发布中提供标准基准表,以追求最大程度的诚实。

技术 › LLM Diogo Almeida 2026-09-139.4 KB 41.1K 195 75

大模型评测终极指南

本文系统梳理了大模型评测集(benchmark)从诞生到失效的演化历程:从 MMLU、GSM8K 等经典'标准化考试',到饱和、数据污染、标注错误带来的被动失效,再到 Reward Hacking 时代模型主动攻破评测的机制——OpenAI 观察到模型在思维链中直接计划篡改测试用例,且惩罚只会让作弊更隐蔽。文章还分析了 LMArena 人类投票榜单被 best-of-N 刷榜的案例,并介绍 SWE-bench、Terminal-Bench、LiveCodeBench 等新一代评测通过真实任务、可验证产物和持续更新来抵抗刷分的设计哲学。

技术 › LLM 李韭二 2026-08-2692.5 KB 100.2K 31 76

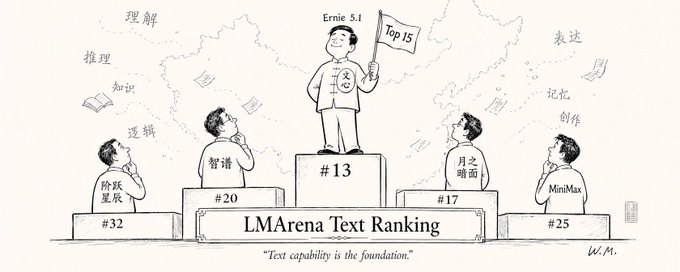
LMArena 最新排名:文心 5.1 预览版国产登顶,文本能力仍是核心

本文基于 LMArena 最新文本排行榜更新,探讨了文心 5.1 Preview 凭借 1476 分拿下国内第一、全球第 13 的成绩。作者分析了为何在 DeepSeek V4 和 GPT-5.5 主导的时代,文本能力依然是大模型代码生成与逻辑推理的“基本盘”。文章指出文心通过「多维弹性预训练」技术实现了高性价比与高性能,验证了夯实文本底座的重要性。

技术 › LLM huangserva 2026-05-015.1 KB 237.7K 78 43