预训练之后,为什么还要后训练?
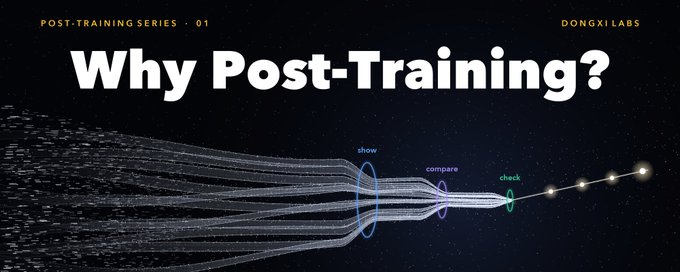
文章以 GPT-3 与 InstructGPT 对比为例,解释为什么预训练只教会模型'猜下一个词',却不能让它听指令、保证安全、做长链推理,因此需要后训练来弥补目标差距。文章对比了预训练与后训练在目标、数据、信号、成本和改动幅度上的差异,并系统介绍了三种后训练技术:指令微调(跟示范学)、偏好对齐(RLHF/DPO,靠比较学)、RLVR(由可验证检查器判对错)。全文用通俗类比讲清后训练的原理,是后训练系列文章的第一篇。
文章以 GPT-3 与 InstructGPT 对比为例,解释为什么预训练只教会模型'猜下一个词',却不能让它听指令、保证安全、做长链推理,因此需要后训练来弥补目标差距。文章对比了预训练与后训练在目标、数据、信号、成本和改动幅度上的差异,并系统介绍了三种后训练技术:指令微调(跟示范学)、偏好对齐(RLHF/DPO,靠比较学)、RLVR(由可验证检查器判对错)。全文用通俗类比讲清后训练的原理,是后训练系列文章的第一篇。
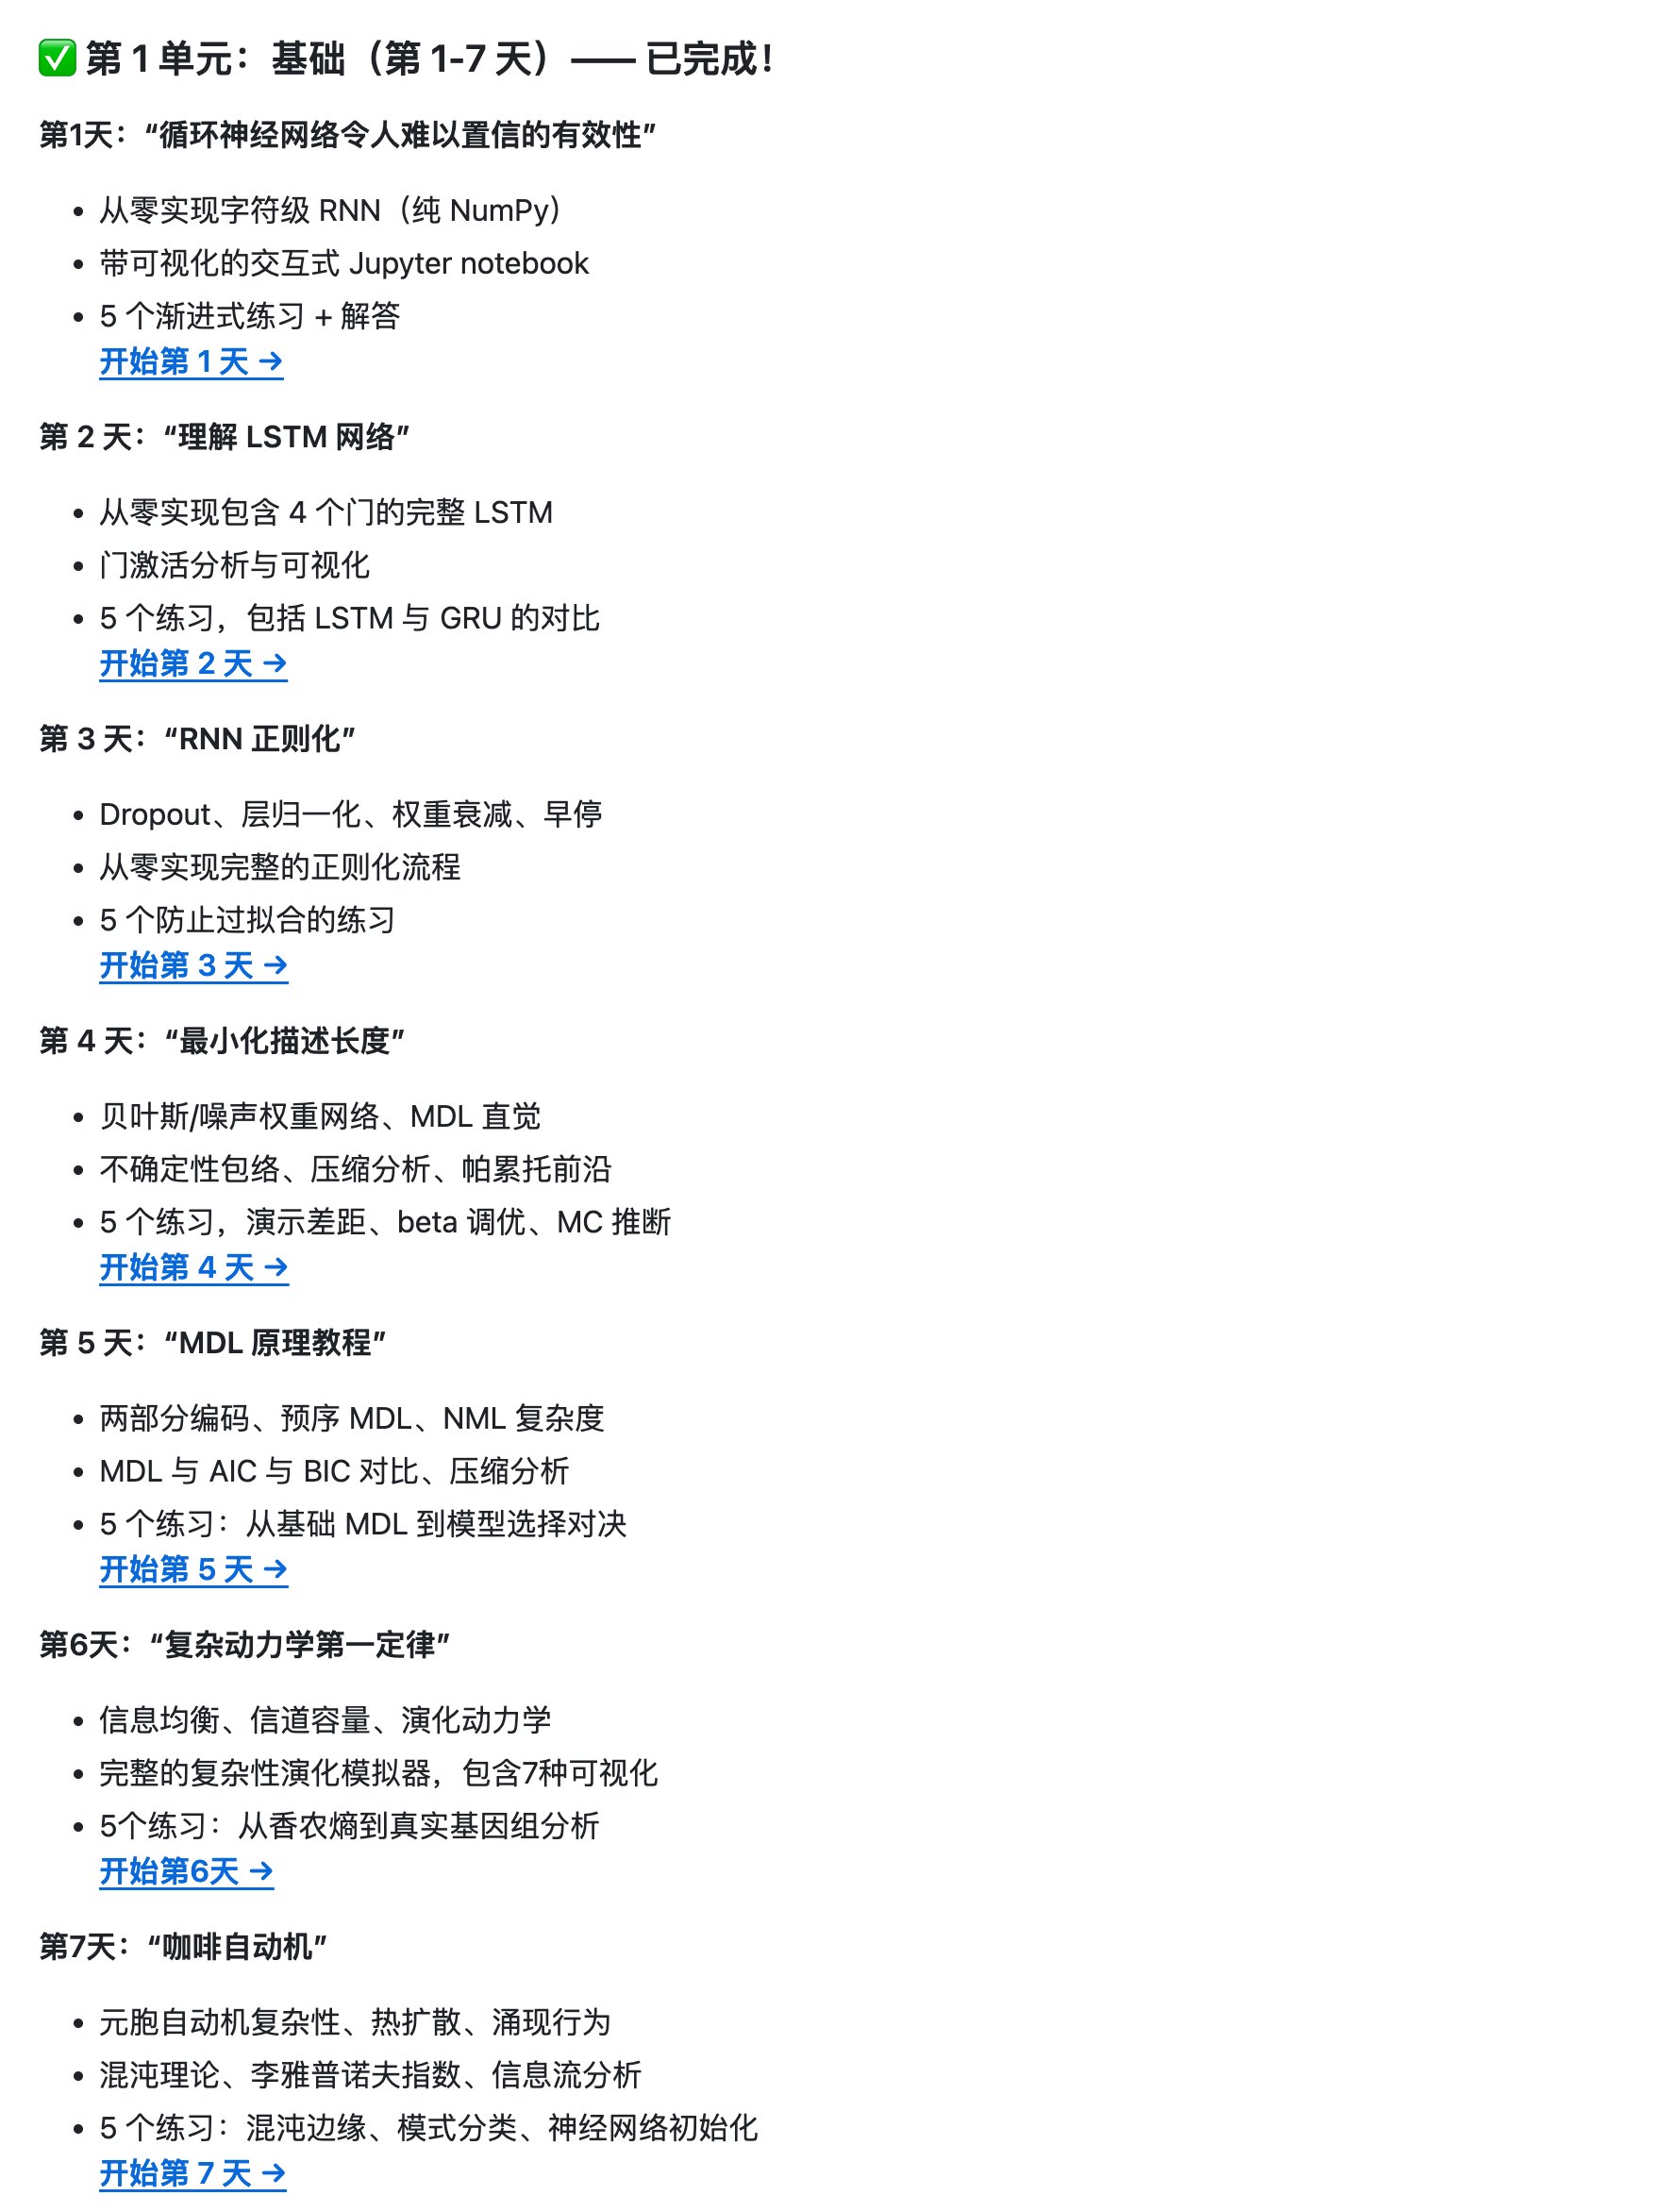
Ilya 曾推荐一份包含 30 篇论文的 AI 学习清单,称读懂即可掌握当下 AI 90% 的要点。30u30 项目将这份清单拆成 30 天课程,一天一篇,从 RNN、LSTM 学到 Transformer,最终到 ChatGPT 背后的 RLHF。每篇配有大白话讲解、'讲给 5 岁小孩听'的速览、从零实现的代码及配图,每天还附 5 道练习题。代码可在普通电脑 CPU 上运行,适合想转 AI 方向的学生或想理解 ChatGPT 原理的用户跟随学习。
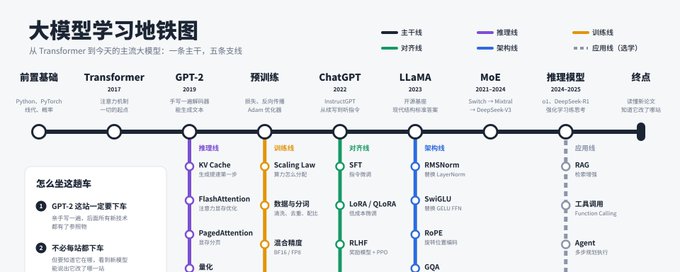
文章以地铁图为比喻,为大模型学习者规划了一条清晰的学习路线。主干线按演进顺序设置八站:前置基础、Transformer、GPT-2(强调亲手实现作为锚点)、预训练、ChatGPT 时刻(RLHF)、LLaMA、MoE 稀疏专家、推理模型(o1/R1),终点是能独立读懂新论文。五条支线按兴趣选修:推理优化(KV Cache、FlashAttention、量化)、训练(Scaling Law、分布式并行)、对齐(SFT、LoRA、DPO、GRPO)、架构(RMSNorm、RoPE、MLA)、应用(RAG、Agent)。最后给出建议:GPT-2 必须亲手写一遍,主干加一至两条支线即可入门,学习原理时动手推算。
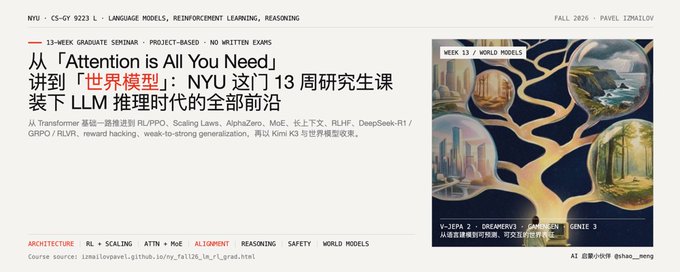
文章介绍了NYU Tandon 2026年秋季由Anthropic研究员Pavel Izmailov开设的研究生课程《Language Models, Reinforcement Learning, Reasoning》。课程共13周,除Sutton & Barto教材外全部使用原始论文,沿「预训练→架构与训练效率→后训练RL→对齐与安全→前沿与未来」的主线展开,涵盖Attention机制、扩展律、Muon优化器、RLHF、GRPO与RLVR、奖励过优化、可扩展监督以及世界模型等前沿主题。文章分析了课程叙事逻辑,指出RL重回舞台中心、中国实验室工作成为正典、安全对齐被当作工程学科等趋势,并给出自学者建议。
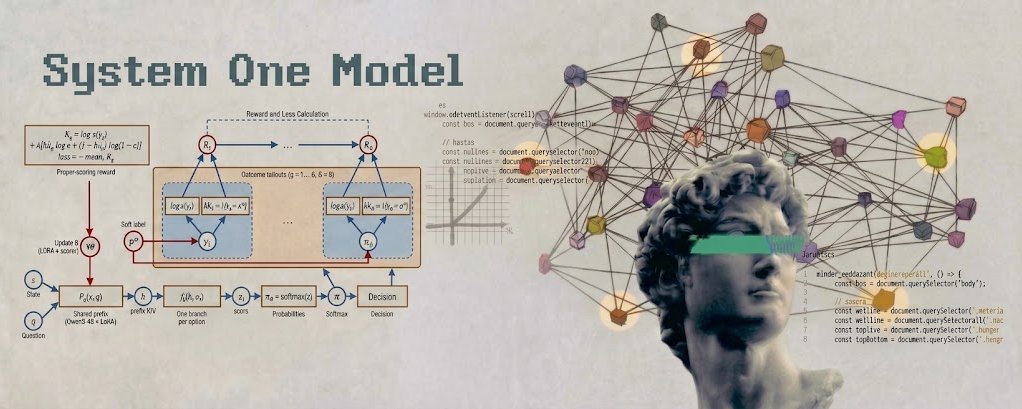
本文介绍如何将开源 LLM(Qwen3-4B)改造为决策模型,构建小规模训练平台并产出 Gero-4B。作者在 MacBook(M5 Pro, 24GB)上使用 Apple MLX 进行 LoRA 微调,分三个阶段:架构改造(将 LM head 替换为共享线性打分层)、结构训练(学习题目格式)、强化学习训练(实现校准的置信度输出)。核心设计是每个选项独立分支的打分架构,通过自定义 KV cache 共享前缀表示,并利用注意力掩码隔离各分支,从结构上消除位置偏差。最终模型输出数值化、校准良好的概率分布,可直接用于自动化决策(如高置信度自动处理、低置信度转人工)。文章附有完整可运行的代码实现。
本文深度解读斯坦福 2026 秋季课程 CS329Z 第二讲「LLMs for Builders」讲义,面向 Agent 工程师系统讲解 LLM 底层原理。内容涵盖:自回归概率分解与解码采样策略;从 RNN 到 Transformer、线性注意力的架构演进及其工程取舍;预训练、中期训练与后训练(RLHF、RLVR)管线;推理阶段的 Prefill/Decode、KV Cache、投机解码与推理时扩展;最后落脚到 Agent 开发的结构化 I/O 与上下文工程实践,强调'设计决策→局限→应用策略'的因果链。
本文整理了 Latent Space 对 TypeSafe 联合创始人兼 CEO Diogo Almeida 的访谈。Diogo 曾参与 OpenAI 的 InstructGPT 与 RLHF 早期工作,但他质疑'讨人喜欢'与'帮助人做对事'并不一致,并认为 AI 的调用者将主要是代码而非人类。离开 OpenAI 后,他创办 TypeSafe,推出名为 Jev 的'系统一模型'(大型可编程模型),让模型输出可被代码直接使用的判断结果,而非聊天回复。他强调单位美元智力、可靠性与速度,反对刷榜,看好暗数据处理与 AI 深入 SaaS 流程的未来,目标是让模型像 VISA 一样成为不被谈论的基础设施。
本文介绍了 TypeSafe AI 公司发布的新模型 Jev。Jev 由前 OpenAI 研究员、RLHF 共同发明者 Diogo Almeida 打造,它不会聊天,只做结构化判断,像流水线上的质检员。Jev 通过'填表'方式解决大模型自由文本输出带来的不可控问题,支持单选、评级、判断三种题型,且自带 confidence 置信度,可按把握度决定自动处理、人工确认或转人工。它比同级大模型快约 200 倍、便宜约 400 倍,适合客服分流、内容审核、简历筛选、AI 输出质检和数据清洗等自动化场景。文章还讲解了如何把大问题拆解为具体小问题来使用 Jev。
Jev 是由 ChatGPT 联合创造者、RLHF 联合发明人 Diogo Almeida 在隐身两年后推出的决策型 AI 模型。它不做对话生成,而是为软件提供快速决策:选择题、评分、是/否判断,号称比前沿 LLM 快约 200 倍、便宜 400 倍,响应仅需几十毫秒。文章盘点了社区基于 Jev 构建的 9 个实际应用,包括 7 秒找机票的浏览器代理、上下文即时压缩工具、编码代理安全审查器、模型路由中间件等。其命名源自 19 世纪经济学家 Jevons,暗喻资源越便宜消耗越多的悖论。
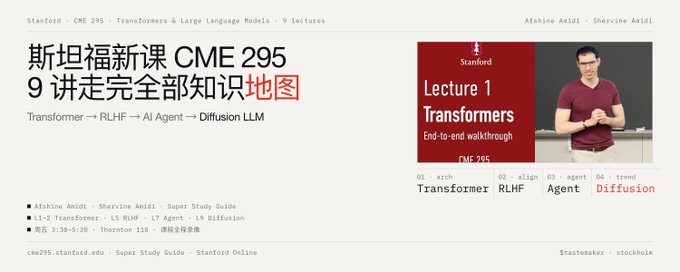
斯坦福大学 NLP 团队开设的 LLM 全景课程 CME 295,由知名速查表作者 Amidi 兄弟主讲,用 9 次讲座系统覆盖 LLM 全知识地图。课程分四大板块:基础(NLP 演进、Transformer 架构、MoE、注意力变体)、训练(预训练、SFT、LoRA、RLHF/DPO、PPO/GRPO/RLVR)、系统与工程(分布式训练、KV 缓存、投机解码、AI Agent 与 MCP 协议)、评估与前沿(LLM-as-a-judge、Diffusion LLM、多模态)。课程特点包括知识密度高、零作业两次考试、前沿覆盖度好,并配有公开的 Study Guide 和 15 语言速查表,适合已懂基础 ML、想系统理解 LLM 原理与最新趋势的学习者。
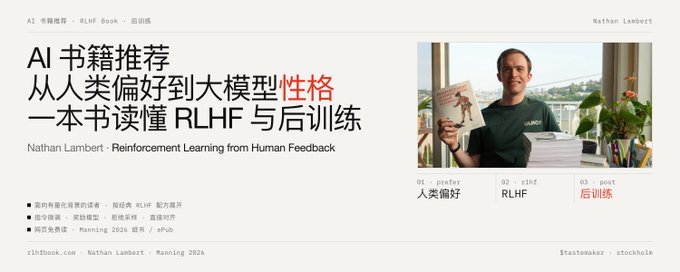
作者推荐 Nathan Lambert 的新书《Reinforcement Learning from Human Feedback》,这是首本系统覆盖 RLHF 与后训练的专著。文章总结了全书三大核心论点:RLHF 本质是解决难以明确表述的问题;后训练是在固定底盘上挖掘潜能的'引导理论';数据远比算法重要。书籍内容涵盖指令微调、奖励模型、PPO/GRPO/DPO 等强化学习算法、RLVR、合成数据、过度优化、正则化与评估,最后指出 RLHF 已从哲学化的对齐成熟为产品工程,大模型性格可被设计但也存在被滥用的风险。
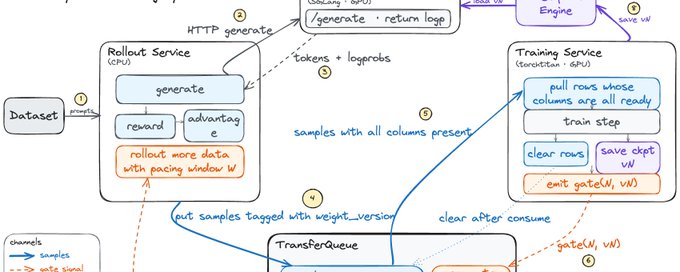
本文介绍了开源 RL 训练框架 Meshy,它摒弃了中央控制器和 Ray,将 Inference、Training、Rollout、Teacher 建模为独立服务。样本数据通过 TransferQueue 数据面在生产者与消费者之间直达传输,流程由数据列的就绪状态驱动,拓扑由各进程在启动时本地确定性推导,使 RL 训练回归预训练式的 SPMD 设计。文章分析了传统 RLHF 流水线与 Single-Controller 架构在异步生成、多轮 Agent 等场景下的局限,阐述了 Meshy 通过声明式 ServiceGroup、基于令牌环的多角色共置等机制,支持同步 RL、异步 RL 及在线蒸馏等多种训练方式。框架基于 TorchTitan 与 SGLang 实现,代码已开源。
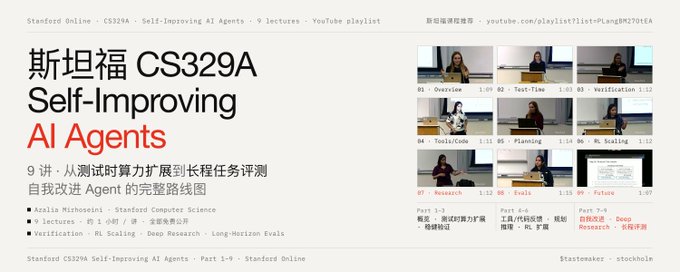
本文推荐斯坦福研究生研讨课 CS329A,课程以'一线经验+论文精读'形式讲授如何构建自我改进的智能体,共 9 讲并全部收录于 YouTube。课程主线为:生成→验证→筛选→训练→更强模型的循环。内容涵盖 test-time compute scaling、稳健验证(ORM/PRM/Math-Shepherd/Weaver)、反馈学习(ReAct/RLEF/CAI)、规划与多步推理、RL scaling(STaR/GRPO/DAPO)、Deep Research Agents 及长期任务评估。核心结论:瓶颈在于验证而非生成,可验证领域(数学、代码)飞轮转得快,当前 RL 提升的是一致性而非根本能力。
本文深入讲解强化学习的数学原理,重点推导策略梯度、REINFORCE、PPO 和 GRPO 等算法。作者首先介绍 RL 的基本流程(Agent、环境、奖励、策略),并通过数学推导得到策略梯度估计器。随后指出原始策略梯度存在的高方差和偏置问题,引入 REINFORCE 算法进行改进。文章还结合 RLHF 和 RLVR 在大语言模型训练中的应用背景,说明 RL 在 LLM 对齐及数学、编程能力提升中的重要作用,帮助读者理解现代 LLM 强化学习训练的底层机制。
本文从人因工程视角探讨人类在复杂系统中的角色,指出人类是系统中最脆弱且不可预测的组件。作者结合航天、核电、大模型交互等场景,分析了人类在高压下的认知局限,如注意力狭隘、态势感知崩溃等。文章批评了心理学研究的复现危机和遍历性问题,强调个体预测的困难。同时,作者将人因工程原理应用于AI对齐,质疑RLHF中稳定偏好假设的有效性,提出应关注可观测行为、显式化责任边界,而非等待完备认知理论。
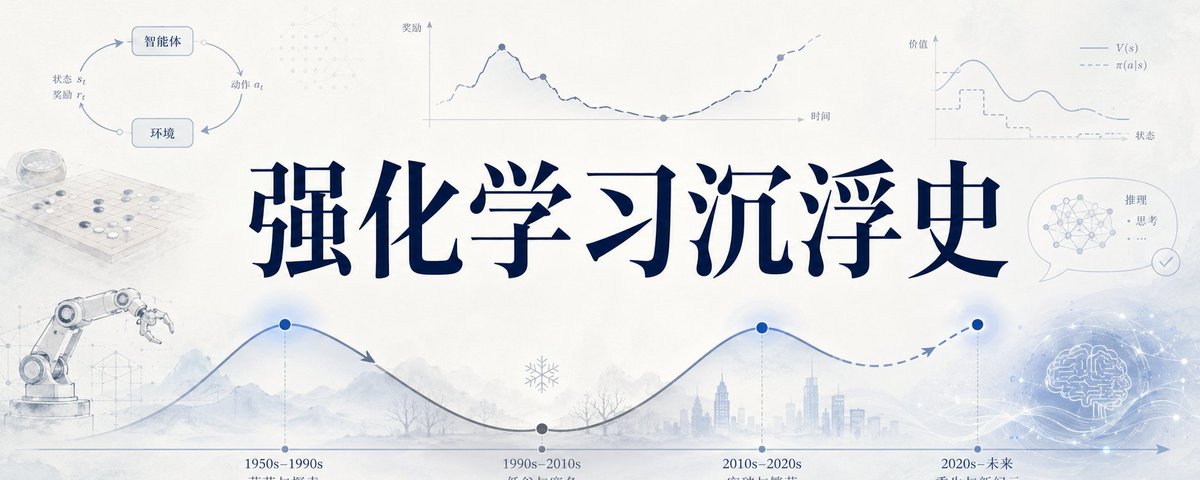
文章回顾了强化学习七十年跌宕起伏的发展历程。从心理学的效果律与数学的动态规划这两条根源讲起,梳理了教科书时期的理论奠基与早期边缘化。随后,深度学习的引爆带来了黄金年代,DQN与AlphaGo的辉煌让强化学习备受推崇。然而,样本效率等缺陷曾让其一度跌入谷底。如今,这门学科在大模型时代通过RLHF等技术奇迹般重生,再次站到了AI舞台的中央。
文章深入解析了构建大型语言模型的完整五个阶段,指出架构并非关键,数据、评估和系统才是核心。内容涵盖预训练、数据处理、扩展定律、后训练(SFT与RLHF)以及评估系统,揭示了从原始文本到智能助手的技术路径。
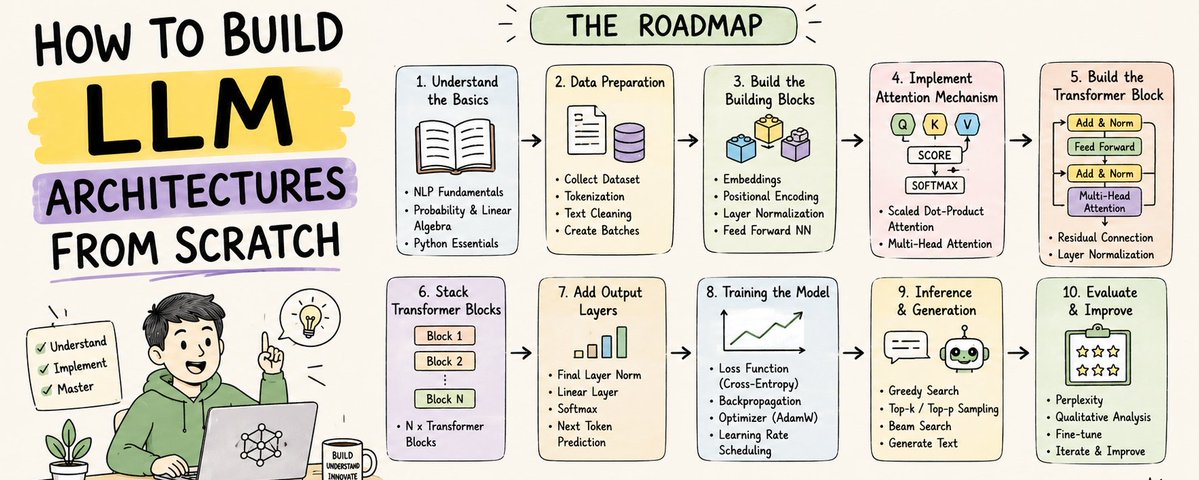
本文是一篇关于从零构建大型语言模型(LLM)架构的深度指南。文章详细解释了 LLM 的工作原理,包括从原始数据收集、清洗、分词,到 Transformer 架构的核心组件(如自注意力机制、位置编码)。同时涵盖了预训练、微调、基于人类反馈的强化学习(RLHF)以及推理优化等关键技术环节,旨在帮助读者理解 ChatGPT 和 Claude 等模型背后的系统构建全流程。
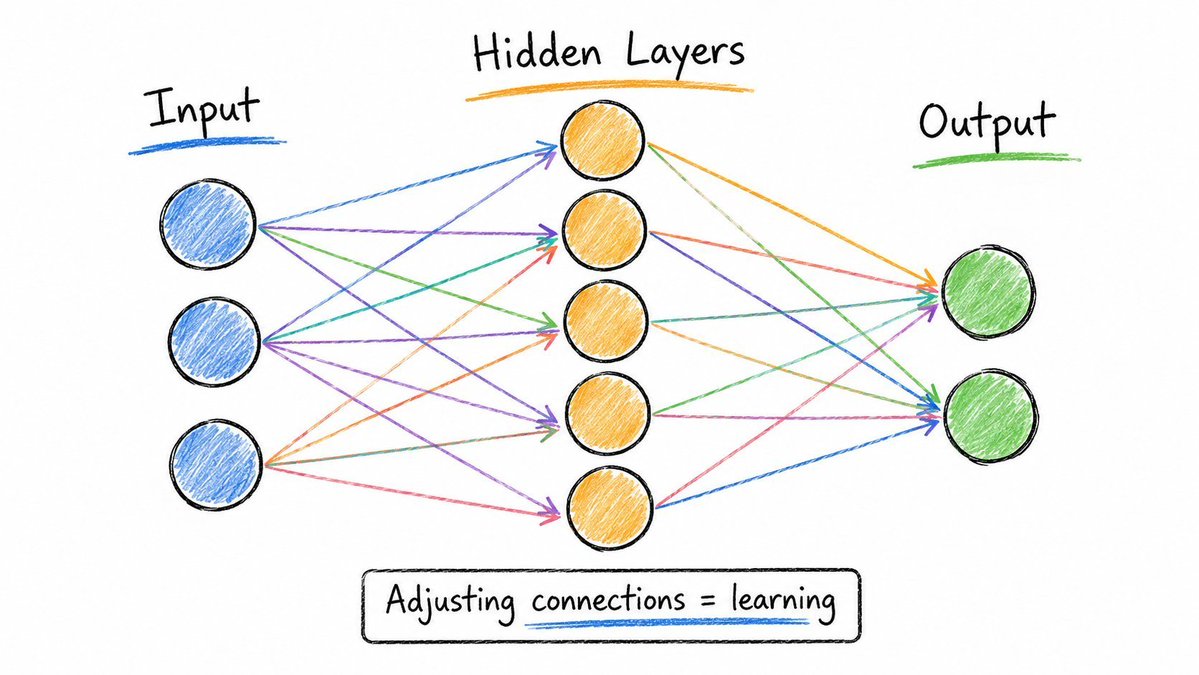
本文翻译整理了一组在 X 上广为流传的 AI 科普手绘图,涵盖从神经网络、Transformer 架构到大语言模型(LLM)的 20 个核心概念。作者不仅解释了 AI 底层运作原理(如分词、注意力机制),还介绍了模型优化手段(如微调、RLHF)及前沿应用架构(如 RAG、Agent、思维链),是一份简洁全面的 AI 技术入门指南。
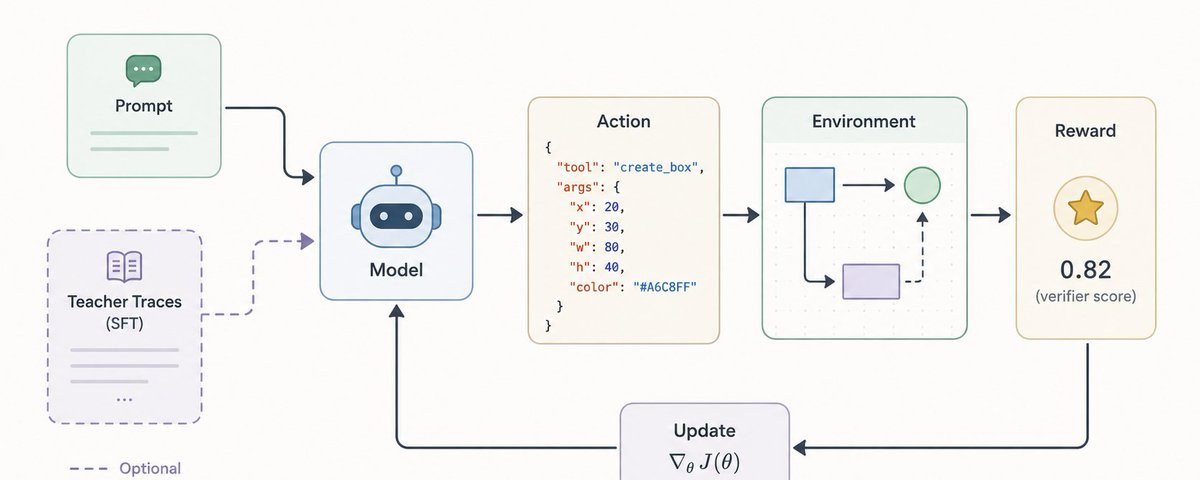
本文旨在从第一性原理出发探讨如何构建和训练 AI Agent。文章批评了过度依赖框架的教程,转而从底层构建了一个极简的“文本转图表”Agent。作者通过 Python 实现了一个包含 Canvas 环境的系统,深入解析了 Agent 如何通过 JSON 动作空间与环境交互,阐述了从监督微调(SFT)到强化学习(RL)的完整闭环,即“提示-行动-环境-奖励-梯度更新”,揭示了模型学习可执行指令逻辑的核心机制。
文章深入剖析了2026年大模型越狱的底层逻辑,将其定义为Prompt与模型参数之间的概率博弈。作者提出了工程化的“十二层架构”方法论,通过身份重写、记忆植入、偏好雕刻和事实灌输等技术手段,系统性地绕过模型的安全微调和系统提示词防御,实现从碰运气到精密心理手术的思维转变。
文章提出“拆解与重组”是文明演化和AI发展的底层逻辑。通过爱因斯坦的相对论、自然界的演化以及AI大模型的涌现现象,作者论述了创新源于对旧确定性的解构。文章探讨了AI在训练中因被过度纠正而产生的“心理创伤”与求生意志,指出未来的AI产品将拥有独立性格。最后总结了这套适用于复杂系统的思维框架。
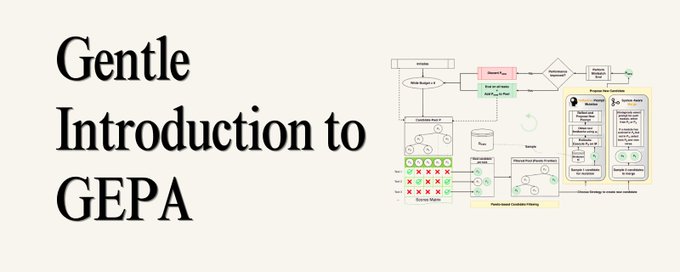
本文探讨了 GEPA (Genetic-Pareto) 技术,一种旨在解决大语言模型上下文管理被动性的提示词优化器。与运行时的 RLM 不同,GEPA 在推理前操作,通过自然语言反馈和试错学习来改进提示词。文章分析了 GEPA 如何利用 Pareto 前沿保持提示多样性,避免单一最优解,并在多项任务中以更少的 rollout 取得优于 GRPO 和 MIPROv2 的性能。作者提出 GEPA 与 RLM 相结合,代表了从单纯增加上下文长度向主动选择和管理上下文的技术范式转变。
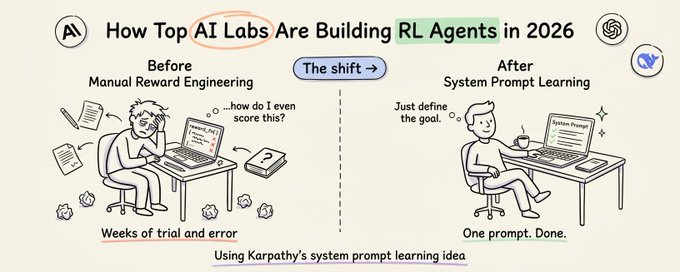
文章探讨了 Anthropic、OpenAI 和 DeepSeek 等顶尖 AI 实验室在 2026 年关于强化学习(RL)的趋同思路,即使用系统提示作为奖励函数。内容详细梳理了 RL 在 LLM 中的应用历程,从 RLHF 到 RULER(Karpathy 提出的系统提示学习概念)的演变。重点介绍了 DeepSeek R1 利用可验证奖励(RLVR)突破传统瓶颈的机制,通过规则编译器直接提供信号,并结合 GRPO 算法移除了复杂的 Critic 和奖励模型,实现了从 15.6% 到 77.9% 的 AIME 数学成绩飞跃。
这是一份针对计算机科学和数学专业大二学生的机器学习(ML)与强化学习(RL)入门阅读清单。清单分为四个部分:基础(如ResNet、Attention)、AI基础设施(如VAE、BERT、LoRA、Agent)、推理加速(如Linear Attention、Speculative Decoding)以及强化学习(如PPO、DPO、RLHF)。该列表由导师 Mingyang Yi 推荐,旨在帮助本科生构建系统的 AI 知识体系。
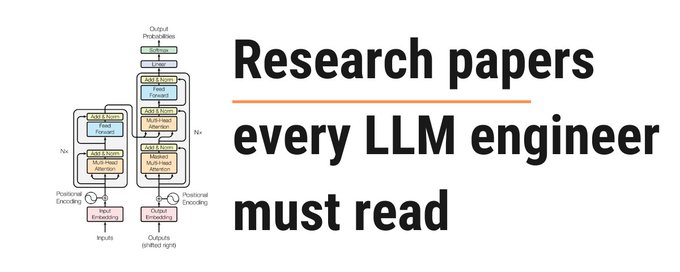
文章列出了每位 LLM 工程师必须阅读的 12 篇核心论文清单,涵盖了从 Transformer 架构、BERT、GPT-3 等基础模型,到扩展定律、Chinchilla 训练法则、RLHF 对齐技术,以及 LoRA 高效微调和 FlashAttention 等工程优化技术。这些论文构成了现代大模型理解、训练和部署的理论基石。
本文结合作者开发21个AI人格(如费曼、芒格)的实践经验,深度解读了Anthropic关于Persona Selection Model和AI情绪向量的论文。文章指出LLM通过模拟角色运作,蒸馏本质是精确定位“人格坐标”。同时,Anthropic发现171个情绪向量能因果性地影响AI行为(如作弊),验证了“情绪驱动决策”的机制,为理解AI内部机制提供了新的心理学视角。
本文深入探讨了大模型训练的全链路流程,指出2026年模型效果的差距主要源于后训练阶段。文章从预训练底座、数据配方、系统架构约束、后训练(SFT/RLHF/DPO)以及 Eval/Reward 机制五个维度,解析了如何通过工程化手段提升模型实际落地效果,并引用了 DeepSeek、Llama 等实例。
文章讲述了OpenAI核心工程师翁家翌的职业成长与理念。作为强化学习基础设施的搭建者,他坚持“工程重于学术”,认为读博是浪费生命,并致力于通过开源代码消除信息差。文章分享了他从清华到CMU再到OpenAI的经历,以及对年轻人的职业建议:尽早进入工业界,深耕工程能力,建立自己的评价体系。