Wiki 知识库

全部文档 / 标签: 概率校准

7 篇
清除

全网最详细的 Jev 及同类决策模型学习资料导航:12 大主题、58 份资料、80 个链接

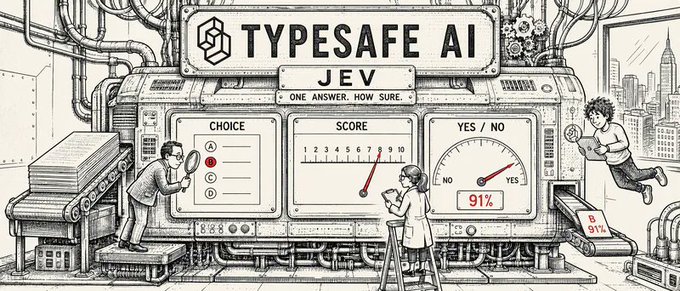
本文系统整理了 Jev 及同类决策模型的学习资料,涵盖 12 大主题、58 份资料、80 个链接。文章首先解释了 Jev 是 TypeSafe AI 推出的决策模型,输入为状态、问题和候选项,输出为结构化的选择、评分及概率分布。作者分析了评估此类模型的关键维度:动态候选项、受限输出与概率校准、推理方式、训练方式及答案边界。随后提供了按目的划分的阅读路径(入门、本地试用、训练研究、中文场景、Agent 应用),并分类整理了云端决策服务(OpenAI Decisions、Liquid d1)、开放模型(Cloudflare Clef、Perplexity Decider、GLiNER2.5-Decide)及本地社区实现(Laya、Kev)等资源,是一份完整的决策模型学习导航。

技术 › LLM Smartpig 2026-10-0842.6 KB 3.2K 4 78

Jev与你有什么关系?它提供了一套AI工作流拆分法

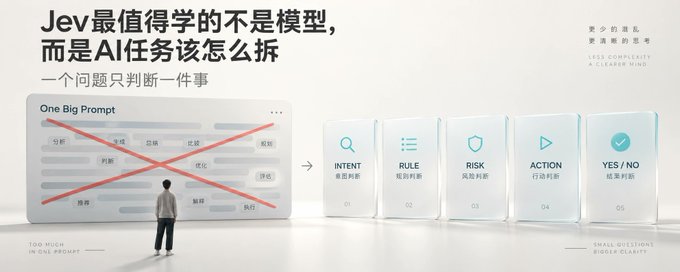
文章介绍了TypeSafe AI于2026年9月发布的Jev模型,一个不做文本生成、只做封闭判断的“System One Model”。它提供三种能力:Choice(选项选择)、Score(等级打分)和Noul(真假概率判断),直接返回类型化结果和概率,省去生成文本的延迟和成本。文章分析了Jev与生成式模型的本质区别,指出类型安全只保证接口格式而非事实正确,概率不等于正确率,并详细说明其在缺陷分诊、Agent路由、发布说明审核等真实场景中的应用方法,以及官方Agent Skill倡导的AI工作流拆分法:代码负责计算和规则,模型只做清楚的语义判断。

技术 › LLM 苏乐 2026-09-2224.6 KB 20.2K 41 85

拿到 Jev,然后呢?剔掉虚火之后的一份真实落地清单

TypeSafe AI 于 2026 年 9 月发布的 Jev 是一个只做选择题的 AI 模型(单选、打分、是/否),响应 0.07–0.5 秒、输入价格极低、输出免费。作者梳理了官方数据及 Hacker News 上的质疑,指出“Jev 取代大模型”是伪命题,其合理定位是高频、低价地执行小判断。文章按用途分类整理了已真实跑通的案例:为 AI Agent 当决策器、海量数据分类、高低置信度分流混合架构、实时反应界面和仿真实验,并列举了已接入的商业产品。作者还分享了自己四次失败的集成尝试与两轮实测结论,强调概率校准的重要性。

技术 › LLM huangserva 2026-09-1922.2 KB 552.7K 840 85

火爆全网的Jev到底是什么?

文章介绍了旧金山创业公司 TypeSafe 推出的闭源基础模型 Jev。它不做文本生成,只做判断题、选择题和打分题,输出严格限定在预设选项内,可在约100毫秒内出结果,成本极低。其核心技术是通过 RLCD 强化学习实现概率校准,类似于卡尼曼所说的 System 1 快思考,与传统大模型的慢思考互补。文章展示了社区应用案例,如浏览器 Agent、游戏实时决策、LangChain 工具路由、AI 输出审核等,也指出其在数数、算数、多跳推理和中文上的短板及提示词注入风险,认为 AI 调用正在走向分层架构。

技术 › LLM 泊舟 2026-09-1913.9 KB 134.9K 549 80

Jev Clearly Explained

文章介绍了 TypeSafe 于 2026 年 9 月发布的 Jev 模型——一个专注于快速、低成本语义决策的"系统一"模型。传统 LLM 在智能体循环中处理大量小型判断(如工单分类、命令风险评估)时逐 token 生成,速度慢且成本高。Jev 通过三种原语(Choice、Score、Noul)接受非结构化输入,返回带概率的类型化答案,端到端延迟 70-500 毫秒,输入价格仅为 LLM 的一小部分。文章分析了概率置信度在自动决策中的作用、RLCD 校准训练方法,并澄清"无法幻觉"的说法:Jev 不会打破输出 schema,但仍可能自信地选错选项,适合与 LLM 配合而非替代。

技术 › LLM Akshay 2026-09-1916.0 KB 2.4M 5.6K 79

新决策模型 Jev 深度剖析

文章深度剖析了 TypeSafe 发布的新决策模型 Jev。与 LLM 不同,Jev 不生成文本,而是输出程序可读的决策 JSON,剥离语言能力,专注做软件中的小判断(分类、布尔判断、打分)。开发者通过传入 state 和 questions 进行调用,模型基于 RLCD 训练方法实现概率校准。相比 LLM,Jev 在演示中快 75 倍、便宜 171 倍,且因输出受类型约束可减少幻觉,但仍可能选错。文章介绍了客服、发票、安全告警等场景评测及 Doom 游戏演示,并建议从工单分类等边界清晰的任务开始试用,逐步开放自动处理。

技术 › LLM Skyhigh Feng 2026-09-187.8 KB 11.8K 51 80

Jev 怎么用:三种提问原语与分层阈值

文章系统讲解了 TypeSafe 的 Jev 决策模型的使用方法。Jev 接收非结构化状态和问题,返回类型安全的答案、概率分布和置信度,提供三种提问原语:Noul(是/否判断)、Choice(选项挑选)、Score(档位评分)。文章介绍五条上手路径(Playground、HTTP API、Python SDK、Agent Skill、开源适配器),并总结提问技巧:一个问题只问一个判断、多因素拆开加权、档位写具体情形而非程度、一次问满并行问题以节省成本。置信度使用上推荐按风险分层设置阈值的三段式策略。文末讨论成本速度、边界限制及社区应用场景,并介绍了开源替代 OpenJev。

技术 › LLM yibie 2026-09-1812.9 KB 80.6K 605 88