Wiki 知识库

全部文档 / 标签: 推理成本

14 篇
清除

三天100万亿token,MiniMax开放权重背后的阳谋

文章分析MiniMax开放M3.1 Flash权重背后的战略逻辑。该模型曾以Space Bunny Alpha匿名形式在OpenRouter上线,72小时内消耗超100万亿token,性能超过前旗舰M3且成本减半。MiniMax通过开源最强模型,目标是让全球Agent默认运行在自己的模型上,与美国公司把模型锁进自家harness收订阅费的做法相反。文章对比中美模型公司的不同路径,并讨论了中国大模型技术出口登记政策及开源出海的规范化进程。

技术 › LLM 动察Beating 2026-10-2413.9 KB 1.2K 3 71

游戏、软件、硬件,一切终将开源?

本文基于 Next Token 播客第五期内容,探讨 Opus 5.5 发布及 RSI 到来后,大模型对软件、硬件和游戏行业的巨大冲击。文章展示了 Opus 5.5 代码能力超越 99% 程序员的表现,分析游戏被反编译复刻、Mod 生态爆发、Adobe 类软件失去法律护城河、ESP32 硬件固件人人可改等现象,指出法律和生态已跟不上 AI 发展节奏。最后讨论了行业剩余机会:开放硬件入口给 Agent、软件转型为 Agent 插件,以及推理成本持续下降带来的免费化趋势。

技术 › LLM Orange AI 2026-10-098.8 KB 71

从零开始理解提示缓存(Prompt Caching In Agents)【译】

本文翻译自 Earendil Engineering 的《Prompt Caching In Agents》,系统讲解编程 Agent 中提示缓存的原理与实践。文章介绍了 KV 缓存的工作机制(prefill 与 decode 阶段)、缓存的两种存放方式(会话亲和性与分布式缓存)、前缀匹配对缓存命中的决定性作用,以及显式缓存与自动缓存的区别。还解释了为何修改工具定义会破坏缓存、TTL 过期导致短请求昂贵、缓存未命中的计费代价,以及 Pi 为何保持旧记录稳定而不激进剪枝,帮助读者在上下文、缓存复用、延迟与成本之间取得平衡。

技术 › LLM 小墨同学 2026-10-0726.1 KB 34.7K 89 83

How to set up your first Local LLM in 10 Steps (Full-course)

这是一篇本地部署 LLM 的完整入门教程。文章首先说明开源模型(Qwen、DeepSeek、GLM 等)已接近闭源前沿约四个月,而 API 订阅配额却在缩水,因此本地部署的价值日益凸显。教程从 Step 0 开始:检查内存、按内存三分之二规则选择模型、安装 Ollama 并运行第一个模型。随后解释了本地模型的核心优势(数据隐私、零边际成本、不受限)与局限(性能不及闭源前沿),分析了订阅补贴经济的不可持续性,并指导读者根据任务需求选择硬件,强调容量决定装得下、带宽决定跑得快、利用率决定是否划算。

技术 › LLM Movez 2026-10-0531.6 KB 258.1K 412 84

Is Jev overhyped? We tested it on 4 real enterprise tasks.

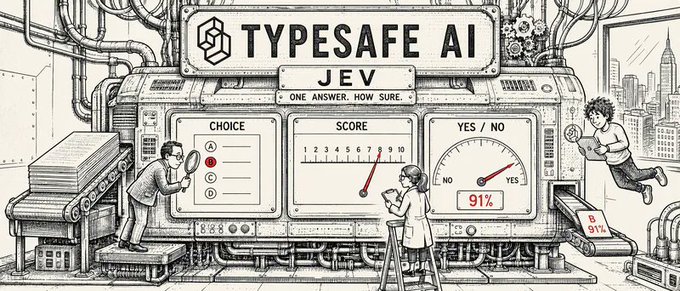
作者基于 Glean 的四个真实企业场景测试了 Jev——一个输出类型化决策(选项、分数、概率)而非生成文本的'System One'模型。文章梳理了通用 LLM、零样本分类器、微调分类器与 Jev 的替代方案权衡,并对比了 Qwen/SGLang、Kev 等开源复现。实验显示:查询分类上 Jev 零样本明显优于 Laya 但微调后反超;模型路由(专家转移)是最强结果,准确率更高且中位加速 8.1 倍;重排序中 Jev 的 Choice 表述最强,但平均 41 个候选中约 37 个分数相同需靠生产排序打破平局。结论是 Jev 在新任务或标签频繁变化时最具吸引力,是否被高估取决于具体场景。

技术 › LLM Tony Gentilcore 2026-09-2913.0 KB 196.4K 379 83

Is ENGRAM free lunch? Does it not impact AI model quality?

文章深入分析Engram技术:将序列嵌入存储到可卸载至DRAM的嵌入表中,节省HBM内存、减少FLOPs,从而降低AI推理成本。在参数和训练预算相同的对照实验中,Engram-27B相比MoE-27B不仅没有降低性能,反而显著提升(MMLU从57.4升至60.4)。作者指出Engram参数分配存在约20-25%的最优区间,过高会挤占MoE专家参数损害性能,且不能完全替代FFN(FFN负责概念运算)。结论认为Engram确实是一种'免费午餐',DeepSeek、美团LongCat、Qwen等已采纳该技术。

技术 › LLM GDP 2026-09-2710.0 KB 38.3K 64 73

新模型 Jev 爆火,5 天挤进 14 万开发者:快 200 倍、便宜 400 倍

文章介绍了发布即爆火的新模型 Jev(TypeSafe 公司出品),它不生成文本,只做判断:路由、分类、打分、审核。相比大模型,它判断速度快 40-200 倍(0.1 秒级),成本便宜约 400 倍,且因输出限定在预定义选项内而不存在幻觉空间。创始人 Diogo Almeida 是前 OpenAI 研究员。文章给出了三条免费或低成本使用方式(OpenJev、官方 waitlist、OpenRouter),并冷静指出官方数据的局限:444 倍提升是评测上限,第三方实测准确率约 68%。Jev 定位为给大模型打配角的 System One 模型,适合 Agent 场景中的高频小判断。

技术 › LLM 路飞 2026-09-207.9 KB 62.4K 76 83

拿到 Jev,然后呢?剔掉虚火之后的一份真实落地清单

TypeSafe AI 于 2026 年 9 月发布的 Jev 是一个只做选择题的 AI 模型(单选、打分、是/否),响应 0.07–0.5 秒、输入价格极低、输出免费。作者梳理了官方数据及 Hacker News 上的质疑,指出“Jev 取代大模型”是伪命题,其合理定位是高频、低价地执行小判断。文章按用途分类整理了已真实跑通的案例:为 AI Agent 当决策器、海量数据分类、高低置信度分流混合架构、实时反应界面和仿真实验,并列举了已接入的商业产品。作者还分享了自己四次失败的集成尝试与两轮实测结论,强调概率校准的重要性。

技术 › LLM huangserva 2026-09-1922.2 KB 552.7K 840 85

Jev Clearly Explained

文章介绍了 TypeSafe 于 2026 年 9 月发布的 Jev 模型——一个专注于快速、低成本语义决策的"系统一"模型。传统 LLM 在智能体循环中处理大量小型判断(如工单分类、命令风险评估)时逐 token 生成,速度慢且成本高。Jev 通过三种原语(Choice、Score、Noul)接受非结构化输入,返回带概率的类型化答案,端到端延迟 70-500 毫秒,输入价格仅为 LLM 的一小部分。文章分析了概率置信度在自动决策中的作用、RLCD 校准训练方法,并澄清"无法幻觉"的说法:Jev 不会打破输出 schema,但仍可能自信地选错选项,适合与 LLM 配合而非替代。

技术 › LLM Akshay 2026-09-1916.0 KB 2.4M 5.6K 79

Jason Wei 斯坦福演讲:理解 2025 年 AI 格局的三大思维框架

Jason Wei 在 Stanford AI Club 的演讲总结了理解 2025 年 AI 格局的三个框架:一、智能正在商品化,自适应计算使推理成本随任务难度动态调整,公开信息获取时间指数级缩短;二、验证者定律——AI 在某任务上的能力与可验证程度成正比,验证成本低的首个被自动化,创业方向是把难验证任务变得可验证;三、智能呈锯齿状分布,AI 自我改进是渐进光谱而非快速起飞,数字化、数据充足、人类觉得容易的任务进步最快,物理类任务短期难以攻克。

技术 › LLM 宝玉 (@dotey) 2026-09-187.8 KB 78

BestBlogs 早报:AI 采用的选择效应、Bending Spoons 运营与 Antspace 逆向

本期早报精选三篇深度内容:一是用因果推断拆解 AI 功能采用中的选择效应,指出朴素留存对比严重高估效果,并演示断点回归的正确用法;二是 Bending Spoons 联创访谈,揭示其通过高人才密度、饱和任务、极致所有权和自研工具平台,让 Evernote 以少一个数量级的人力实现三倍迭代速度;三是工程师逆向 Claude Code 网页版会话,发现 Anthropic 未公开的 PaaS 平台 Antspace,并分析其垂直整合意图。速览部分还涵盖具身智能路线分歧、小模型协同推理降本、GPT-Live 1 语音 API 及 HuggingFace 智能体公开课。

技术 › Agent ginobefun 2026-09-1426.6 KB 3.4K 2 79

BestBlogs 早报 · 09-11|DeepSeek 降缓存成本,Magic 验预训练效率,Shopify 原生化

本期早报聚焦 Agent 能力落地过程中的工程变量与真实收益。精讲三篇:DeepSeek V4.1 Flash 通过大幅缩减 KV Cache 降低长上下文推理与缓存成本;Magic 用保留集、缩放律和防数据泄漏评测验证预训练配方的十倍效率提升,强调跨规模验证的重要性;Shopify 因编码模型降低双端实现成本,从 React Native 转向 Swift/Kotlin 原生开发,并通过 Helix 流程保证 AI 生成代码的可交付性。速览部分涵盖 Cognition SWE-2 的成本-能力 Pareto 优化、Agentic Harness 工作流框架、Anthropic 网络安全事件对齐复盘、规范驱动开发研究、LinkedIn 企业 Agent 的 Skills 实践与 Bolt CEO 关于原型到生产代码的访谈。

技术 › LLM ginobefun 2026-09-1123.0 KB 2.6K 2 79

vLLM x AgentX: Optimizing for Real-World Agentic Serving

本文介绍 vLLM 针对 Agentic 工作负载的服务优化方案。Agentic 流量具有多轮长会话、长上下文短输出、高前缀复用率和大量子代理调用的特点,对成本与延迟提出双重要求。在 SemiAnalysis 发布的 AgentX 基准上,vLLM 在 DeepSeek V4 Pro 上达到每 GPU 秒 130K tokens,在 MiniMax M3 上交互速度达 376 tokens/s,相比 Opus 5 API 定价有 14.6×–106× 的成本优势。文章详细阐述了数据平面的混合 KV cache 管理与分层卸载、执行平面的并行与内核优化,以及控制平面的 P/D 分离调度等全栈优化方法。

技术 › LLM vLLM 2026-09-0931.2 KB 41.2K 328 78

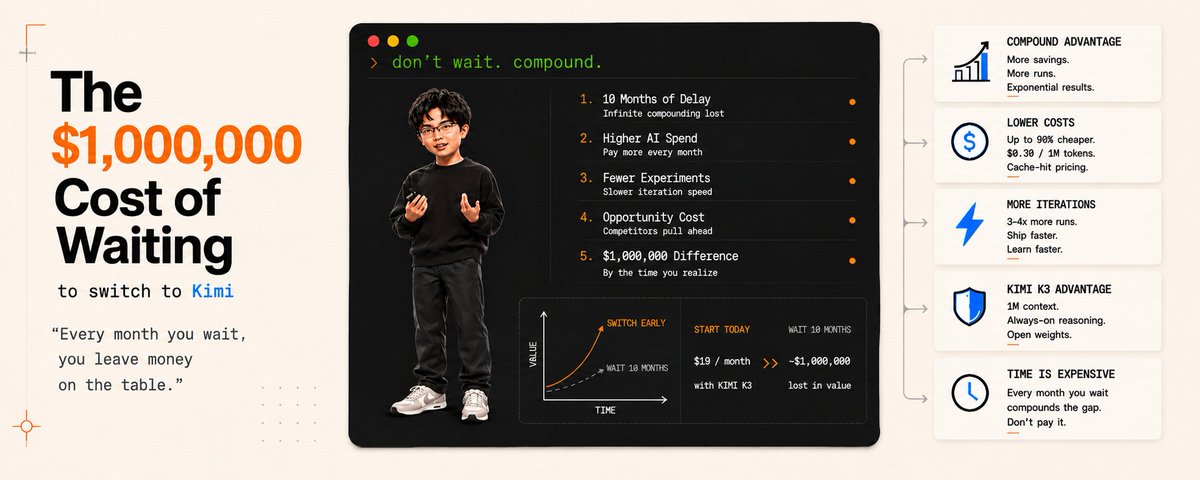
等待切换到 Kimi 的百万美元代价

文章以复利投资为类比,论述延迟切换到更便宜的 AI 模型(如 Kimi)的隐性成本。通过 Emma 和 James 两位投资者的对比说明时间复利的威力,指出 AI 开发中省下的推理成本可转化为更多实验、更快学习,形成复利式优势。昂贵推理就像投资中的管理费,悄无声息地拖累长期发展。建议按任务匹配模型,尽早利用低成本推理加速产品迭代,因为错过的实验时间无法事后弥补。

技术 › LLM leopardracer 2026-08-249.8 KB 406.1K 150 52