Wiki 知识库

全部文档 / 标签: 评测方法论

3 篇
清除

为什么我们需要 Agent 评测

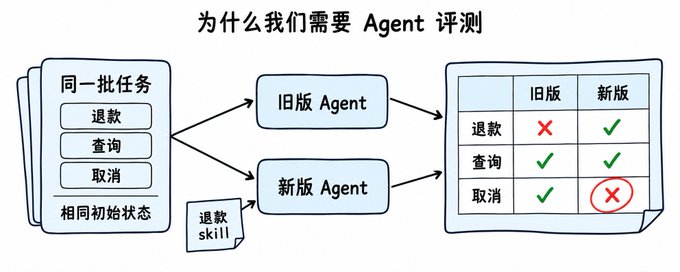
本文是 Agent 评测系列的第一篇文章,作者结合业界共识与个人实践,阐述了 Agent 评测的重要性。文章从一次线上问题修复切入,说明传统后端开发流程难以应对 Agent 的概率性输出与执行路径的不确定性。作者给出 Agent 评测的定义:围绕具体任务,按明确标准检查 Agent 执行过程(trace)和结果的方法。核心价值包括:防止越修越坏、判断改动是否真的变好、确认任务稳定性、明确完成标准、指导迭代优先级。文章还提出评测落地的五步流程:整理任务、写清标准、准备一致环境、运行新旧版本对比、持续更新案例,并提醒注意评测集划分、标准本身可能出错等问题。

技术 › Agent 黄同学h 2026-10-1220.2 KB 15.5K 236 76

一套来自 Gemini/Meta 一线的 Agent 评测完整方法论:真实流量、失败分类、四层阶梯、过程打分

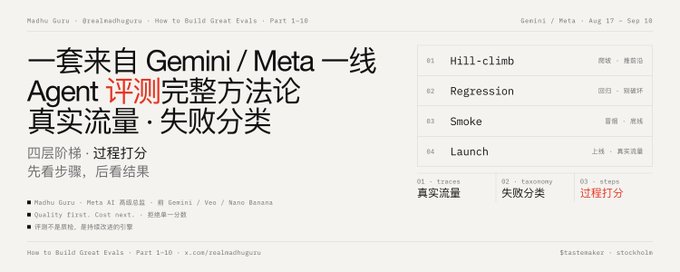
本文梳理 Meta AI 高级总监 Madhu Guru 的「How to Build Great Evals」十篇系列,总结一套 AI Agent 评测工程方法论。核心观点:评测应锚定真实用户流量而非实验室数据;先建立可信质量信号再降成本;挖掘 500-1000 条真实交互建立精确的失败分类;采用爬坡、回归、冒烟、上线四层阶梯组织评测;反对将质量压缩为单一平均分;按阶段度量中间步骤而非只看最终结果;评测体系须随用户行为演进持续更新。文章同时指出其局限:缺少统计测量学基础、未正面处理过程与结果评测的权衡。

技术 › Agent meng shao 2026-09-1111.1 KB 7.9K 75 85

The science of benchmarking: from Zero to Hero [Part I]

本文是基准测试科学系列第一部分,从第一性原理讲解LLM评测:为什么评测(为无法直接观测的能力提供决策证据)、评测什么(任务、数据与用户环境的代表性)、如何评测(指标、采样与统计)。作者将基准视为测量仪器而非问题集合,拆解了任务、数据集、评分器等核心组件,并强调分数不等于能力本身,声明离直接观测越远所需假设越多。后续部分将讨论基准失效、数据污染与榜单刷分等议题。

技术 › LLM giovanni 2026-08-1428.0 KB 66