Wiki 知识库

全部文档 / 标签: Evals

14 篇
清除

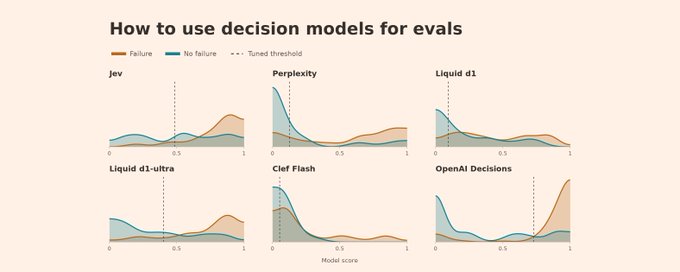
How To Use Decision Models for Evals

文章介绍了决策模型(如 TypeSafe 的 Jev、Perplexity 的 Decider、Liquid 的 d1、Cloudflare 的 Clef、OpenAI 的 Decisions API)作为 LLM judge 的低成本替代方案在自动化评估中的应用。作者基于 100 条公寓租赁 Agent 的对话轨迹,测试各模型识别失败案例的性能与成本,并重点讲解决策阈值的调优:默认阈值 0.50 未必适合具体任务,需根据精确率与召回率的业务权衡(如 F1 优化或最低 80% 双重要求)来选择阈值。文章还提供了用编码 Agent 进行阈值调优的示例提示词,并讨论了校准与分数解释等实用方法。
技术 › LLM Hamel Husain 2026-10-2117.5 KB 318.2K 2.3K 84

AI for Executives:面向决策者的 AI Agent 分层解读

这是一篇面向 AI 项目决策者的科普文章,无需技术背景,逐层拆解 AI Agent 的十三层结构。作者从核心三要素(模型、上下文、工具)讲起:模型是无状态、只会预测下一个词的神经网络;上下文包含系统提示、技能、规则、工具定义等,按 token 计费;工具在用户侧运行。后续层涵盖如何优化输出质量(上下文卫生、专有信息、大小与位置)、什么是 Agent、幻觉、知识库、记忆、Harness、子代理、长时循环、评估、交互式与无头模式、助手与自主 AI 的区别,以及 Skill 的价值。所有数据均来自已发表论文或标注为厂商声明的文档,文末附向团队提问的清单与要点总结。

技术 › LLM Sergii Makarevych 2026-10-0654.9 KB 6K 24 82

Does Your AI Agent Actually Work? A Guide to Eval-Driven Development

本文介绍 AI Agent 的评估驱动开发(Eval-Driven Development)。作者指出 vibe coding 可以快速构建应用,但仅靠手工测试提示词无法保证 Agent 质量上线。文章解释了评估的核心概念:eval 是应用于 trace 的评分器,包括 Case、Run 等基本构件,并详述四种评分方式——确定性检查、参考答案评分、规则评分和轨迹评分。文章还区分线上评估(监控生产环境真实流量)与线下评估(发布前测试),强调两者缺一不可,并通过 promotion 机制将生产问题转化为测试用例,形成持续改进闭环。

技术 › LLM Alex Lieberman 2026-10-0615.7 KB 108.8K 386 84

Use Jev to extract signals from millions of chat agent traces

本文介绍如何利用 Jev 类模型大规模分析数百万条聊天 Agent 生产轨迹,从中提取失败信号。传统 LLM-as-a-judge 评估依赖采样以控制成本,而 Jev 类模型可在同一上下文中并行回答多个问题,以极低成本对全部轨迹进行全面评估。文中讨论了显式反馈、行为追踪、事实结果和对话信号等不同类型的用户信号,并以航班改签客服对话为例,展示如何同时捕捉后续提问、用户挫败感和结果满意度等维度。文章最后介绍如何在 Langfuse 中配置基于 Jev 的批量评估模板,实现生产信号的监控与可视化。

技术 › LLM Annabell 2026-09-245.7 KB 59.9K 171 70

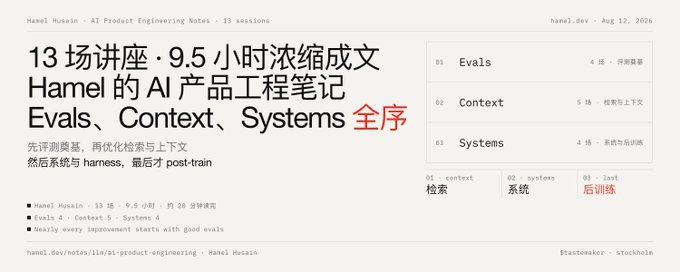
Hamel 的 AI 产品工程笔记:Evals、Context、Systems 的优化全序

本文整理了 Hamel Husain 的 Maven 课程「AI Product Engineering」13 场讲座(共 9.5 小时)的笔记精华,按 Evals、Context、Systems 三大主题组织。核心结论是 AI 产品优化的顺序:先优化检索与上下文(投入产出比最高),再改进系统与执行框架,最后才考虑 post-training。Evals 贯穿一切改进,是判断优化效果的前提。文章涵盖数据 Agent 评测、模型级联降本、自动化错误分析、多向量检索、嵌入模型优化、OCR 选型、推理延迟调试、开源模型经济学等具体实践,强调评测环境应反映生产环境的真实脏乱,模型推理能力往往远超其所得的检索质量。

技术 › LLM meng shao 2026-09-1722.2 KB 27.6K 144 87

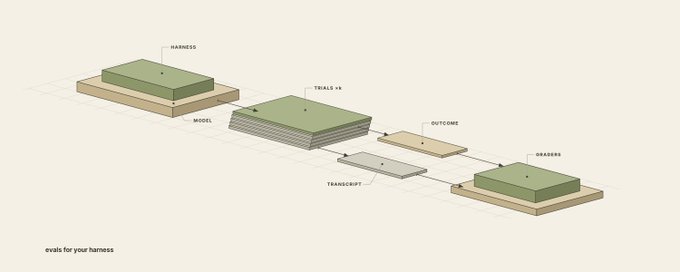
start ugly, write evals anyway:Agent 评估入门指南

文章探讨了 Agent 评估(evals)的重要性与实践方法。作者将 Agent 定义为模型加 Harness 的组合,区分了模型评估与 Harness 评估,并对比了 SDLC 中的测试与 ADLC 中的评估差异。文章澄清了评估的核心概念(task、trial、outcome、grader 等),指出评估的冷启动门槛比想象中低,从真实失败案例中提取 20-50 个任务即可起步。作者强调应只构建任务完成率和正确性两个基础指标,主张评估结果而非路径,并建议纳入负向用例、部分得分机制,坚持阅读轨迹记录,关注分心、token 消耗、延迟、上下文膨胀和一致性等信号。

技术 › Agent hrushikesh 2026-09-1510.4 KB 109.7K 1.2K 82

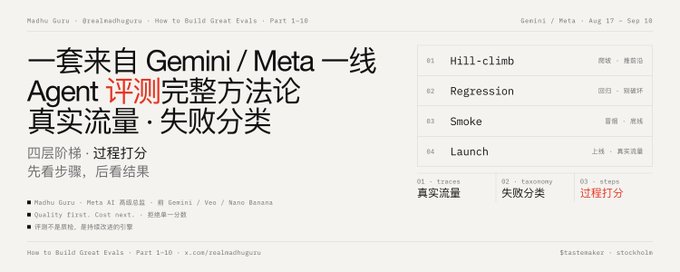
一套来自 Gemini/Meta 一线的 Agent 评测完整方法论:真实流量、失败分类、四层阶梯、过程打分

本文梳理 Meta AI 高级总监 Madhu Guru 的「How to Build Great Evals」十篇系列,总结一套 AI Agent 评测工程方法论。核心观点:评测应锚定真实用户流量而非实验室数据;先建立可信质量信号再降成本;挖掘 500-1000 条真实交互建立精确的失败分类;采用爬坡、回归、冒烟、上线四层阶梯组织评测;反对将质量压缩为单一平均分;按阶段度量中间步骤而非只看最终结果;评测体系须随用户行为演进持续更新。文章同时指出其局限:缺少统计测量学基础、未正面处理过程与结果评测的权衡。

技术 › Agent meng shao 2026-09-1111.1 KB 7.9K 75 85

LLM-as-Judge Architectures: Putting Evals Into Your Agent Runtime

文章探讨将 LLM-as-Judge 从离线评估工具迁移到 Agent 运行时架构中的趋势。传统确定性软件可通过类型检查、断言等方式验证结果,而 AI 应用输出往往需要判断性评估,LLM judge 能让应用自我完成这些判断。作者介绍了几种常见模式:使用另一个模型(包括专用小型评估模型以降低成本)、将大而模糊的判断拆解为多个小判断并用 DAG 结构组合、用成对比较代替打分以规避位置偏差、在 Agent 工作过程的关键节点(如检索、方案选择)设置检查点而非仅评估最终答案,以及使用多评委投票、辩论等机制提升可靠性。

技术 › LLM Josh Rosen 2026-09-0913.2 KB 90.3K 681 77

Your AGENTS.md is holding you back

文章探讨了随着大模型能力提升,上下文工程的策略已从补充信息转向尽量精简信息。PostHog 分享了维护 AGENTS.md/CLAUDE.md 的三种实践方法:1) 使用 Claude Code 的 /doctor 命令进行健康检查并人工审阅,删除无法说出其防止失败的冗余指令;2) 像对待代码一样测试上下文,将 agent 犯过的错误记录为 evals,通过 wizard-ci 和 pr-evaluator 自动化验证;3) 直接让 agent 在使用上下文的过程中反馈改进建议。文章强调过时或冗余的上下文会拖累 agent 表现,需要定期清理与迭代。

技术 › Claude Code PostHog 2026-09-0113.7 KB 50.4K 515 88

如何构建可持续维护的评估集

本文介绍了如何为AI Agent构建可长期维护的评估(eval)指标体系。指标分三类:目标指标、护栏指标和运营指标,三者结合使用。候选指标来源于错误分析和产品目标与硬约束。并非所有候选都值得跟踪:一次性问题用prompt修改解决即可,只有需要持续追踪的泛化问题才建指标;每个指标必须与具体决策挂钩,否则就是噪音。从零开始时,可先阅读30-50条trace并用自由文本笔记聚类失败模式。此外需定期重跑错误分析、退役失效指标,并警惕Goodhart定律导致的过拟合。

技术 › LLM Lotte 2026-08-198.4 KB 89.1K 476 83

Own Your Intelligence: 企业自建 AI 能力实战指南

红杉资本团队撰文探讨企业是否应自建 AI 能力而非依赖前沿实验室。开源模型(如 Kimi K3、GLM 5.2)性能逼近前沿,后训练技术栈日益成熟,成本、速度、专有数据与自主掌控成为自建的核心动因。文章给出实践路线图:组建专职团队、公开研究成果,并系统介绍了评估(Evals)、Harness 与上下文工程、后训练(SFT/偏好调优/RL/蒸馏)以及在线学习四个技术步骤,帮助企业在特定领域超越通用前沿模型。

技术 › LLM Sonya Huang 2026-08-1811.2 KB 76.5K 352 79

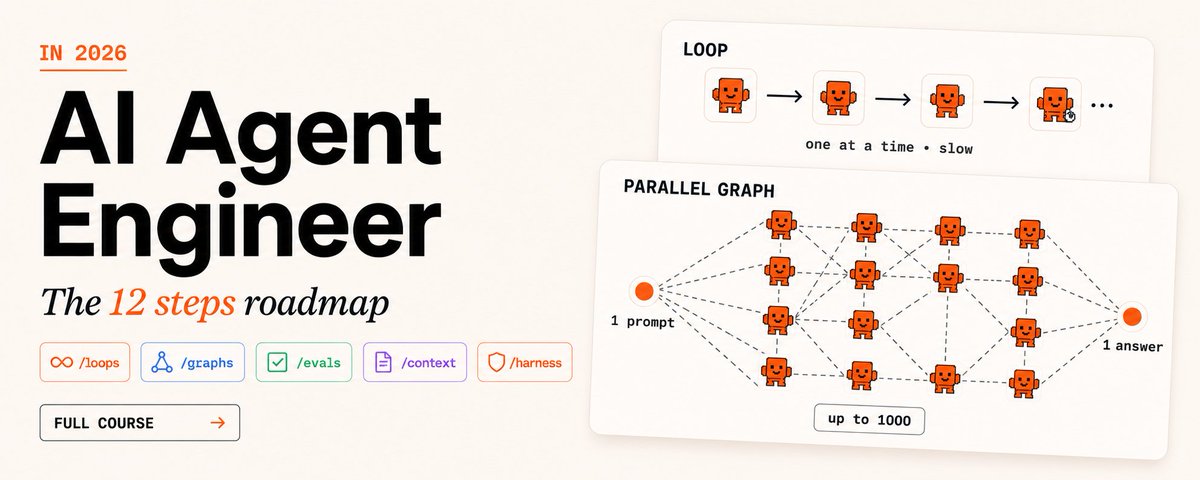
AI Agent Engineer 2026:七大支柱与12步学习路线图

作者提出2026年AI Agent工程师的12步路线图,围绕决定Agent成败的七大支柱展开:上下文、工具、记忆、循环、图、Harness与评估。文章指出Agent失败的核心原因是上下文膨胀、循环不收敛、缺乏评估。前半部分详细讲解上下文工程(如Claude Code启动即加载约7850 token、精简系统提示、CLAUDE.md分层管理)、工具与MCP设计(用类型代替示例、延迟加载)、记忆管理(计划文件、主动压缩)等内容,强调七者是同一技能的不同投影,需按依赖顺序学习。

技术 › Agent Codez 2026-08-1824.8 KB 80.9K 508 83

The science of benchmarking: from Zero to Hero [Part I]

本文是基准测试科学系列第一部分,从第一性原理讲解LLM评测:为什么评测(为无法直接观测的能力提供决策证据)、评测什么(任务、数据与用户环境的代表性)、如何评测(指标、采样与统计)。作者将基准视为测量仪器而非问题集合,拆解了任务、数据集、评分器等核心组件,并强调分数不等于能力本身,声明离直接观测越远所需假设越多。后续部分将讨论基准失效、数据污染与榜单刷分等议题。

技术 › LLM giovanni 2026-08-1428.0 KB 66

如何构建 Agent 平台

文章以云计算和数据平台的发展史为鉴,指出 Agent 时代正从分散走向整合。作者提出构建统一的 Agent 平台至关重要,该平台包含 Runtime、Storage、Connectors、Interfaces 和 Infrastructure 五大核心组件。文章提供了一套基于 FastAPI 和 Docker 的基础代码库,演示了如何在本地或 Railway 上运行平台,并利用 Claude Code 实现无需编码即可创建、测试、递归改进 Agent 以及通过 Evals 锁定行为的完整闭环。

技术 › Agent Ashpreet Bedi 2026-05-0833.8 KB 61.8K 671 84