预训练之后,为什么还要后训练?
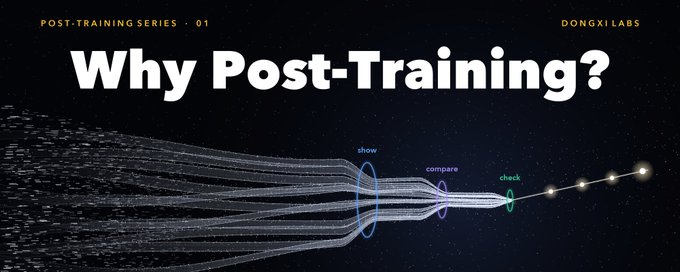
文章以 GPT-3 与 InstructGPT 对比为例,解释为什么预训练只教会模型'猜下一个词',却不能让它听指令、保证安全、做长链推理,因此需要后训练来弥补目标差距。文章对比了预训练与后训练在目标、数据、信号、成本和改动幅度上的差异,并系统介绍了三种后训练技术:指令微调(跟示范学)、偏好对齐(RLHF/DPO,靠比较学)、RLVR(由可验证检查器判对错)。全文用通俗类比讲清后训练的原理,是后训练系列文章的第一篇。
文章以 GPT-3 与 InstructGPT 对比为例,解释为什么预训练只教会模型'猜下一个词',却不能让它听指令、保证安全、做长链推理,因此需要后训练来弥补目标差距。文章对比了预训练与后训练在目标、数据、信号、成本和改动幅度上的差异,并系统介绍了三种后训练技术:指令微调(跟示范学)、偏好对齐(RLHF/DPO,靠比较学)、RLVR(由可验证检查器判对错)。全文用通俗类比讲清后训练的原理,是后训练系列文章的第一篇。
作者推荐 Nathan Lambert 的新书《Reinforcement Learning from Human Feedback》,这是首本系统覆盖 RLHF 与后训练的专著。文章总结了全书三大核心论点:RLHF 本质是解决难以明确表述的问题;后训练是在固定底盘上挖掘潜能的'引导理论';数据远比算法重要。书籍内容涵盖指令微调、奖励模型、PPO/GRPO/DPO 等强化学习算法、RLVR、合成数据、过度优化、正则化与评估,最后指出 RLHF 已从哲学化的对齐成熟为产品工程,大模型性格可被设计但也存在被滥用的风险。