预训练之后,为什么还要后训练?
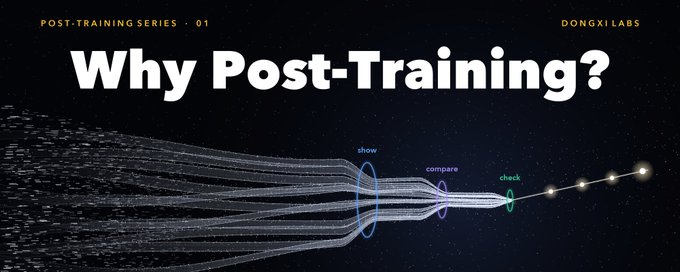
文章以 GPT-3 与 InstructGPT 对比为例,解释为什么预训练只教会模型'猜下一个词',却不能让它听指令、保证安全、做长链推理,因此需要后训练来弥补目标差距。文章对比了预训练与后训练在目标、数据、信号、成本和改动幅度上的差异,并系统介绍了三种后训练技术:指令微调(跟示范学)、偏好对齐(RLHF/DPO,靠比较学)、RLVR(由可验证检查器判对错)。全文用通俗类比讲清后训练的原理,是后训练系列文章的第一篇。
文章以 GPT-3 与 InstructGPT 对比为例,解释为什么预训练只教会模型'猜下一个词',却不能让它听指令、保证安全、做长链推理,因此需要后训练来弥补目标差距。文章对比了预训练与后训练在目标、数据、信号、成本和改动幅度上的差异,并系统介绍了三种后训练技术:指令微调(跟示范学)、偏好对齐(RLHF/DPO,靠比较学)、RLVR(由可验证检查器判对错)。全文用通俗类比讲清后训练的原理,是后训练系列文章的第一篇。
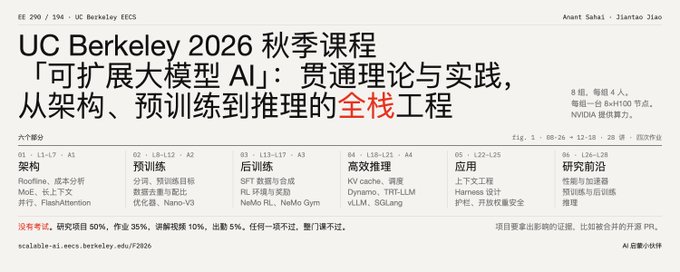
文章介绍 UC Berkeley EECS 2026 秋季开设的《Scalable AI》课程(EE 290/194),由 Anant Sahai 与焦剑涛联合授课,NVIDIA 提供算力支持。课程将大模型作为端到端工程对象教授,涵盖架构、预训练、后训练、高效推理、应用与研究前沿六个阶段,采用基于真实 H100 节点的项目制考核,无笔试,研究项目占 50% 且要求外部影响力证明。课程深度绑定 NVIDIA NeMo 工具链,反映了 AI 教育重心从论文向工程实践迁移的趋势,适合目标为 LLM infra 与 MLSys 的学生。
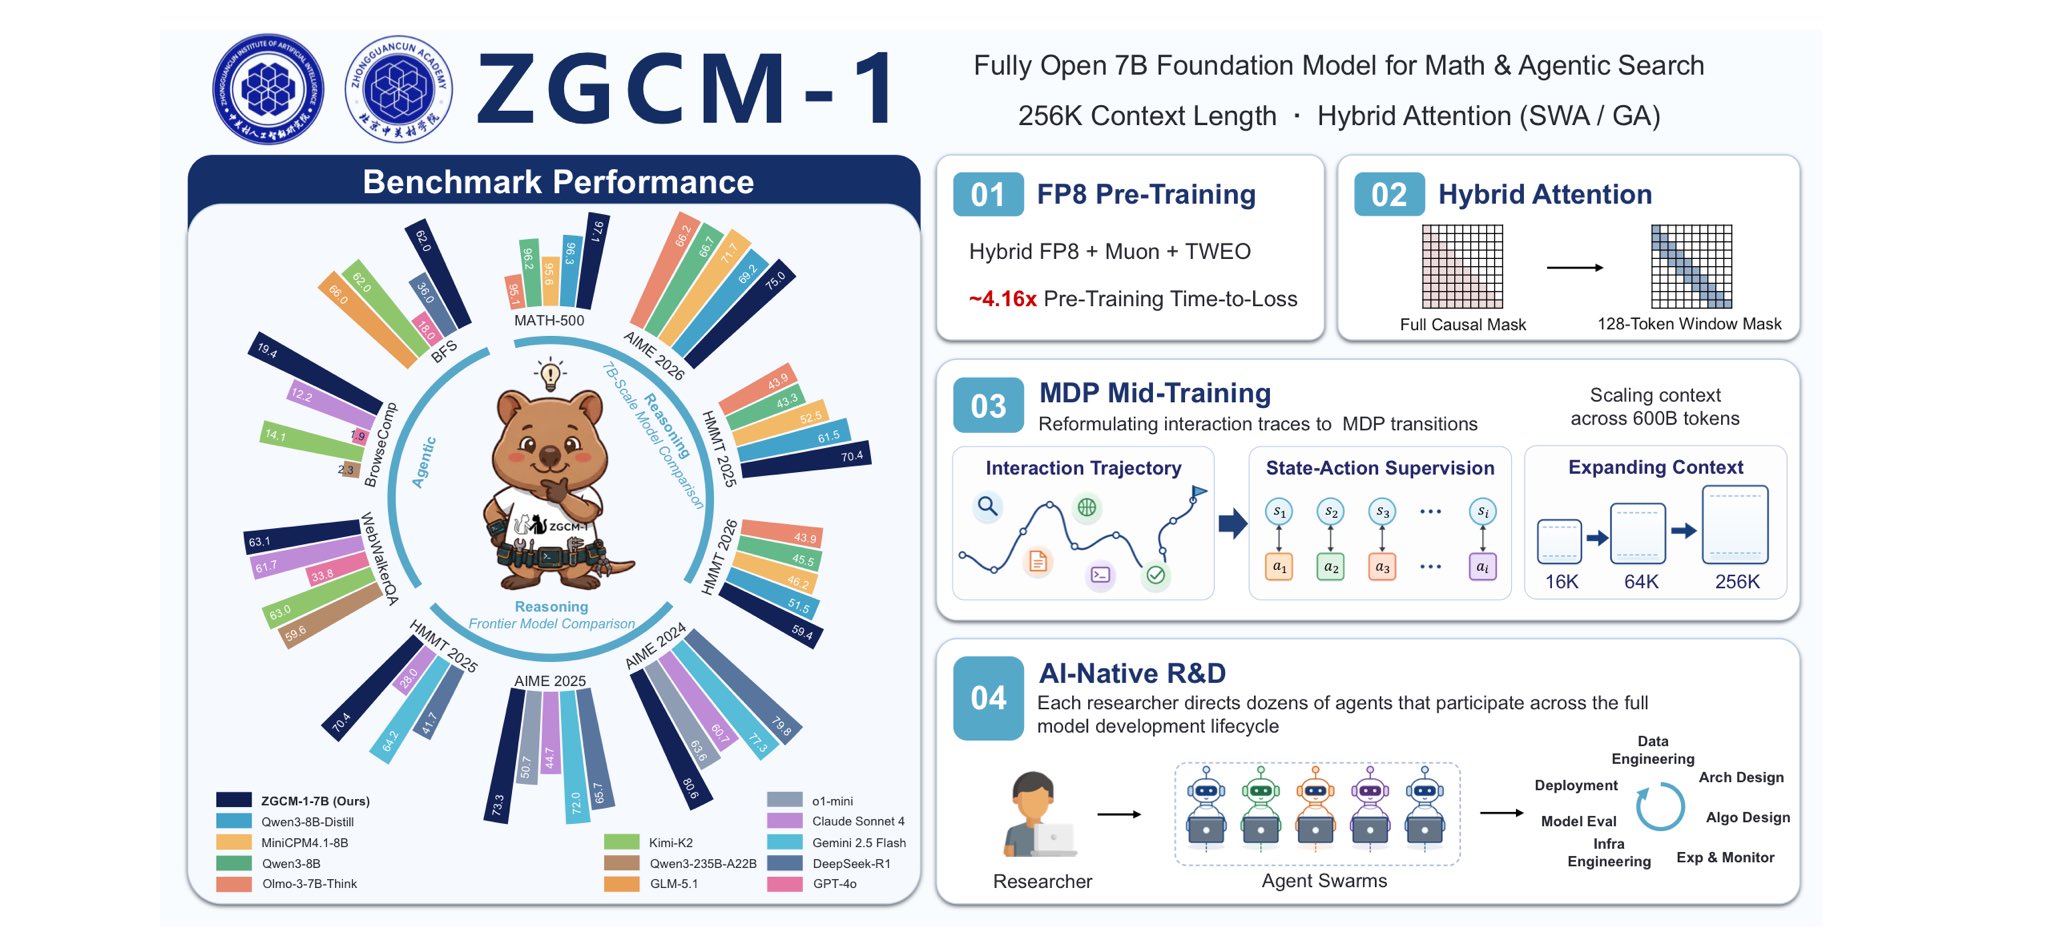
作者评述中关村学院何纪言老师带领 7 位博士生用 3 个月从预训练、中训练到后训练完全自主训练出 7B 模型并达到 SOTA 水平。文章提出三点观察:一是当前模型能力远未到全自主程度,在架构设计、算法设计等方面仅达 L2 辅助水平;二是模型训练会者不难,MiMo V2.6 RL 仅花 300 多万美金即达高水平,说明关键是人才而非算力堆砌;三是数据是新的代码,数据质量如同代码质量一样重要,该模型在数据清洗、课程学习、上下文扩增和 RL 优化上做了深入工作。
本期早报聚焦 Agent 能力落地过程中的工程变量与真实收益。精讲三篇:DeepSeek V4.1 Flash 通过大幅缩减 KV Cache 降低长上下文推理与缓存成本;Magic 用保留集、缩放律和防数据泄漏评测验证预训练配方的十倍效率提升,强调跨规模验证的重要性;Shopify 因编码模型降低双端实现成本,从 React Native 转向 Swift/Kotlin 原生开发,并通过 Helix 流程保证 AI 生成代码的可交付性。速览部分涵盖 Cognition SWE-2 的成本-能力 Pareto 优化、Agentic Harness 工作流框架、Anthropic 网络安全事件对齐复盘、规范驱动开发研究、LinkedIn 企业 Agent 的 Skills 实践与 Bolt CEO 关于原型到生产代码的访谈。
本文系统梳理了模型微调的核心概念与术语。作者首先解释了微调的意义:在预训练模型基础上,用任务相关数据继续训练,使模型更适应特定表达、任务或指令,减少幻觉。随后从五个层面展开:模型训练阶段(预训练、基础模型、后训练、微调);训练原理(SFT、指令微调、下一个token预测);训练框架与工具(PyTorch、容器、训练方案);LoRA相关技术(PEFT、QLoRA、rank、alpha、target modules);数据与训练参数(语料、数据集、batch size、学习率、过拟合、eval loss等)。文章以DGX Spark本地微调Gemma为例,帮助读者理解微调全流程。
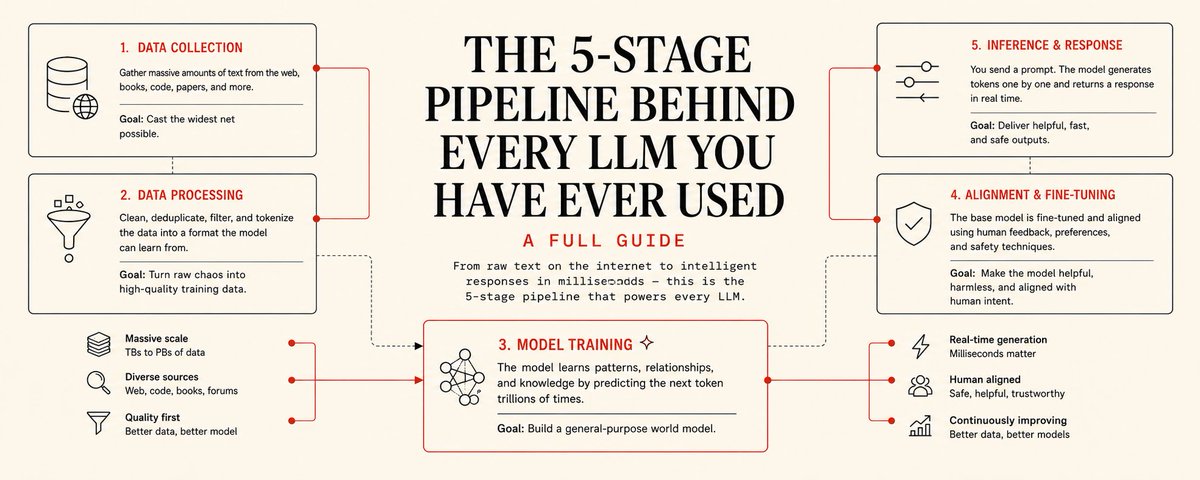
文章详细解析了构建大型语言模型的五个关键阶段:数据收集与预处理、预训练、及后续阶段。作者指出,大多数误解源于将“训练”视为单一步骤,实际上每个阶段解决不同问题。理解这一流程有助于识别模型行为根源及局限性,如幻觉或拒绝回答,并指导优化策略。
文章深入解析了构建大型语言模型的完整五个阶段,指出架构并非关键,数据、评估和系统才是核心。内容涵盖预训练、数据处理、扩展定律、后训练(SFT与RLHF)以及评估系统,揭示了从原始文本到智能助手的技术路径。