Wiki 知识库

全部文档 / 标签: 合成数据

7 篇
清除

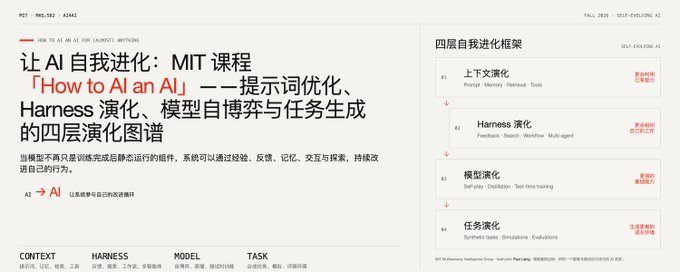
让 AI 自我进化:MIT 课程「How to AI an AI」——四层演化框架解析

文章介绍了 MIT Media Lab 2026 年秋季开设的研究生课程 MAS.S62「How to AI an AI」,主题为自演化 AI(Self-Evolving AI)。课程提出四层演化框架:上下文演化(提示优化、记忆)、Harness 演化(agent 工具链自我改进)、模型演化(持续学习、self-play、测试时训练)、任务与环境演化(合成任务生成、世界模型)。文章详述了教学设计、评分结构、作业与顶会论文成果,并评价该课程是对松散领域的体系化定义尝试,建议以阅读清单和开源工具自学。

技术 › LLM meng shao 2026-10-208.6 KB 14.6K 80 85

We're Thinking Too Small About Synthetic Data

本文指出合成数据远不止大规模推理或预训练数据配比设计,而是一个深度的数据研究问题。作者认为生成器本身就是研究课题:并非所有部分都需要 LLM,状态转移模型和离散事件仿真可以通过显式规则生成内部一致的世界历史。同时,人类知识与合成系统应结合——人类帮助设计训练分布、提升内容真实感、补充机器检查的判断盲区。作者以客服 agent 训练为例说明事件驱动仿真的优势,并展望自适应课程设计,认为物理/数学仿真 + LLM + 人类专家的组合将大有可为,应以固定预算下的训练提升来评判生成器。

技术 › LLM Yuhan Luo 2026-10-189.2 KB 33K 611 74

Jev:离开 OpenAI 后,他做了一个不跟人聊天的 AI

本文整理了 Latent Space 对 TypeSafe 联合创始人兼 CEO Diogo Almeida 的访谈。Diogo 曾参与 OpenAI 的 InstructGPT 与 RLHF 早期工作,但他质疑'讨人喜欢'与'帮助人做对事'并不一致,并认为 AI 的调用者将主要是代码而非人类。离开 OpenAI 后,他创办 TypeSafe,推出名为 Jev 的'系统一模型'(大型可编程模型),让模型输出可被代码直接使用的判断结果,而非聊天回复。他强调单位美元智力、可靠性与速度,反对刷榜,看好暗数据处理与 AI 深入 SaaS 流程的未来,目标是让模型像 VISA 一样成为不被谈论的基础设施。

技术 › LLM Frank Wang 玉伯 2026-09-2417.5 KB 35.4K 56 76

AI 书籍推荐:从人类偏好到大模型性格——RLHF 与后训练

作者推荐 Nathan Lambert 的新书《Reinforcement Learning from Human Feedback》,这是首本系统覆盖 RLHF 与后训练的专著。文章总结了全书三大核心论点:RLHF 本质是解决难以明确表述的问题;后训练是在固定底盘上挖掘潜能的'引导理论';数据远比算法重要。书籍内容涵盖指令微调、奖励模型、PPO/GRPO/DPO 等强化学习算法、RLVR、合成数据、过度优化、正则化与评估,最后指出 RLHF 已从哲学化的对齐成熟为产品工程,大模型性格可被设计但也存在被滥用的风险。

技术 › LLM meng shao 2026-09-157.5 KB 6.2K 55 82

一个脚本过一夜就能做完的事,Axis Robotics 花了 1200 万美元

文章批评 Axis Robotics 融资1200万美元、雇人用鼠标在浏览器遥操作仿真机械臂采集五万条数据集的做法。作者指出利用已发表的演示增强技术(350-400倍扩增率),同样数据仅需约130条真实演示即可生成,每条数据成本高达240美元,且存在物理与动作统计的双重分布位移。文章提出'验证比生产更便宜'的信息市场定律,批评按条计酬会催生'劣质数据驱逐优质数据'的格雷欣法则,并介绍Stonk Robotics基于方案(程序化策略)而非轨迹的替代设计,主张购买判断、评测等无法被制造的东西。

投资 › 加密货币 StonkRobotics 🤖 2026-09-0633.0 KB 743 5 89

LAB: 模拟律师事务所知识环境与AI智能体基准测试

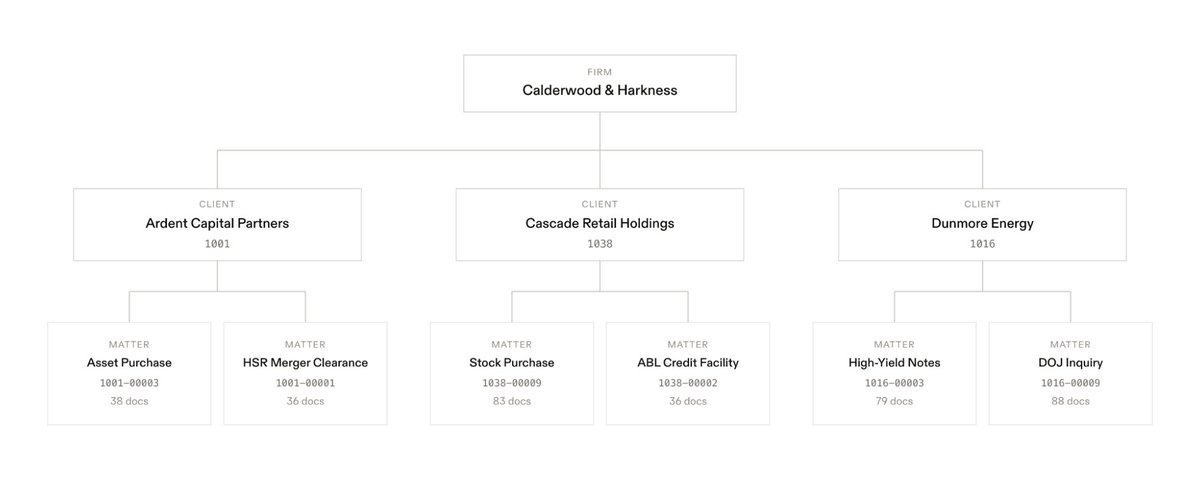
本文介绍了开源的模拟律所环境Calderwood & Harkness (C&H),旨在测试大语言模型在企业级海量知识(超1亿Token)中的检索与推理能力。C&H包含46个客户和266个案件。基准测试表明,当前先进模型在全面搜索和判断信息检索的“完整性”上存在严重瓶颈,导致任务完成度受限。作者指出,未来的改进方向是让智能体预先构建更丰富的语料库表示(如索引、摘要、记忆),以分摊运行成本并提升企业级知识处理能力。

技术 › Agent Julio Pereyra 2026-08-088.8 KB 298.1K 234 86

900万参数,130行代码:从零构建微型语言模型 GuppyLM 教程

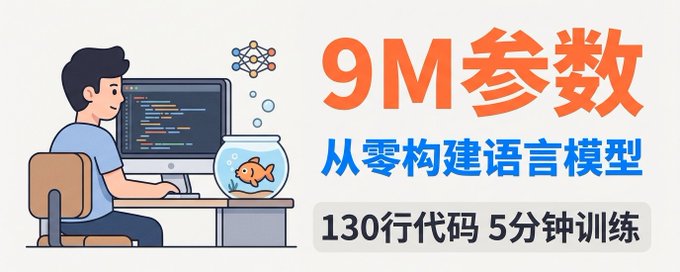
本文介绍了开发者 arman-bd 开源的微型语言模型 GuppyLM。该模型拥有 900 万参数,核心代码仅 130 行,可在免费 Colab 上 5 分钟训练完成。文章详细拆解了构建流程:利用模板生成 6 万条合成数据、训练 4096 词表的 BPE 分词器、搭建 6 层 Vanilla Transformer 架构以及优化推理环节。该项目旨在通过极简的实现,帮助开发者深入理解语言模型的数据工程、架构设计与训练循环。

技术 › LLM Jason Zhu 2026-04-077.5 KB 8.5K 74 92