Wiki 知识库

全部文档 / 标签: SFT

8 篇
清除

指令微调:理解 Instruction Tuning

本文是后训练系列第二篇,介绍指令微调(SFT)。以斯坦福 Alpaca 用 52,000 条自动生成的数据微调 LLaMA 7B 为例,说明指令微调与预训练使用相同的下一个 token 预测损失,但数据和任务不同。文章详细讲解训练五步骤:收集、格式化、掩码、训练、评测,并通过 LIMA 和 FLAN 研究说明指令微调主要改变模型行为方式而非增加知识,少量数据即可泛化到新任务。还介绍了损失掩码原理、位置错开的实现细节、指令数据的三种来源及其局限:无法补充知识、比较回答优劣或检验正确性。

技术 › LLM Dongxi 东锡 NLP 2026-10-2312.4 KB 8.9K 59 83

预训练之后,为什么还要后训练?

文章以 GPT-3 与 InstructGPT 对比为例,解释为什么预训练只教会模型'猜下一个词',却不能让它听指令、保证安全、做长链推理,因此需要后训练来弥补目标差距。文章对比了预训练与后训练在目标、数据、信号、成本和改动幅度上的差异,并系统介绍了三种后训练技术:指令微调(跟示范学)、偏好对齐(RLHF/DPO,靠比较学)、RLVR(由可验证检查器判对错)。全文用通俗类比讲清后训练的原理,是后训练系列文章的第一篇。

技术 › LLM Dongxi 东锡 NLP 2026-10-219.5 KB 26.6K 179 70

我在 22.7B token 上从零训了一个 348M 模型,它能做 14 位加法

作者 nkthebass 从零训练了一个 348M 参数的 decoder-only 小模型 TinyBrainBot 350M V3 Math,用带纸笔(scratchpad)的竖式算术方式做计算。九项 GPT-3 算术子任务均值达 99.4%,加法干净做到 14 位,三位数乘法 98.0%。文章详细分析了首版三个缺陷的修复过程、加法天花板源于词表位名不足、减法错误集中在大小比较、应用题弱与算术高分不矛盾等发现,并分享了训练中关于联合分布控制和显式对齐步骤两个关键经验,以及 LoRA adapter 合并的意外收益。

技术 › LLM yibie 2026-09-138.4 KB 982 3 86

CMU 秋季新课 AI Agents:OpenHands 作者亲授,从零搭 Harness、建评测、用 RL 训智能体

CMU LTI 2026 年秋季新开研究生课程 11-768: AI Agents,由 OpenHands 核心开发者 Graham Neubig 与 Daniel Fried 共同讲授。课程以"搭 harness→建评测→RL 训练→做研究"流水线为主线,涵盖工具调用、上下文管理、技能与记忆、规划、安全、框架实践等模块,密集邀请一线学者客座授课。作业要求学生在开源 LLM 之上从零实现 ReAct Agent、设计评测框架并完成 SFT/RL 训练,工程细节对标生产级 Agent 系统。期末研究项目占 50% 成绩。PPT、视频与作业仓库全部公开,是目前系统学习 LLM Agent 建造、评测与训练最完整的公开课程。

技术 › Agent meng shao 2026-09-0911.6 KB 94.6K 569 86

万字长文!读懂模型微调的基本概念和名词

本文系统梳理了模型微调的核心概念与术语。作者首先解释了微调的意义:在预训练模型基础上,用任务相关数据继续训练,使模型更适应特定表达、任务或指令,减少幻觉。随后从五个层面展开:模型训练阶段(预训练、基础模型、后训练、微调);训练原理(SFT、指令微调、下一个token预测);训练框架与工具(PyTorch、容器、训练方案);LoRA相关技术(PEFT、QLoRA、rank、alpha、target modules);数据与训练参数(语料、数据集、batch size、学习率、过拟合、eval loss等)。文章以DGX Spark本地微调Gemma为例,帮助读者理解微调全流程。

技术 › LLM Roland.W 2026-09-0120.3 KB 32.5K 85 71

如何教授 AI 模型

文章通过人类学习的类比,通俗易懂地解释了 AI 模型如何学习新技能和行为。它涵盖了从预训练、监督微调到强化学习的三个阶段,以及通过基准测试评估模型和通过模型规范对齐模型行为的重要性,最后指出了当前模型在持续学习方面的局限性。

技术 › LLM Lee Robinson 2026-07-248.2 KB 218.8K 2K

使用 Fireworks Agent 自动化 LLM 微调全流程

本文介绍了如何利用 Fireworks Agent 实现 LLM 微调(SFT)的全自动化。文章以 Andrej Karpathy 的“个人 LLM Wiki”理念为引,阐述了将知识注入模型权重比单纯依赖上下文窗口更高效。通过 Fireworks Agent,作者展示了从数据集检查、超参数搜索、模型训练到部署推理的完整闭环,无需人工干预繁琐步骤,仅需少量 GPU 时间和极低成本,即可训练出具有特定输出风格(如 Wiki 摘要风格)的模型,为构建自我进化的 Agent 铺平了道路。

技术 › Agent elvis 2026-05-2115.5 KB 46.8K 110 83

SFT、RL 与 On-Policy 蒸馏:原理与差异

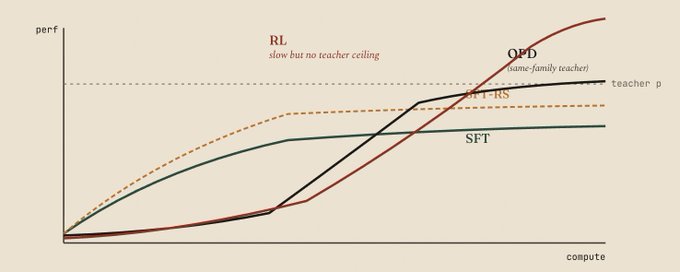
本文深入探讨了模型后训练中的 SFT 与 RL 流程,重点分析了基于同族模型(Same-family)的 On-Policy 蒸馏(OPD)技术。文章解释了 SFT 存在性能天花板的原因,以及 RL 如何通过复利效应突破这一限制。作者指出 OPD 结合了 SFT 的低成本和 RL 的复合优势,能高效利用教师模型的反向 KL 散度信号,是实现高性能模型微调的关键手段。

技术 › LLM will brown 2026-05-0150.2 KB 72