Wiki 知识库

全部文档 / 标签: GEPA

4 篇
清除

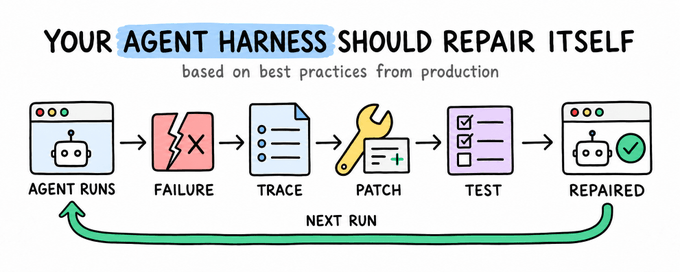
Your Agent Harness Should Repair Itself

文章探讨 Agent 系统如何在不更新模型权重的情况下自我改进。作者阐述了两条反馈路径:成功运行产生可复用的程序性记忆(以 Hermes 的 SKILL.md 文件和 GEPA 离线优化为代表),失败运行则通过 Opik 的执行 trace 进行诊断,定位故障源头(模型、工具、配置或代码),提出修复方案,经人工审核后重跑并添加回归测试。文章强调失败必须被记录为可验证的预期行为和测试用例,才能转化为可复用的知识,并详细介绍了 trace 结构、失败检测与根因分析的工作流程。

技术 › Agent Avi Chawla 2026-09-1218.9 KB 53K 415 81

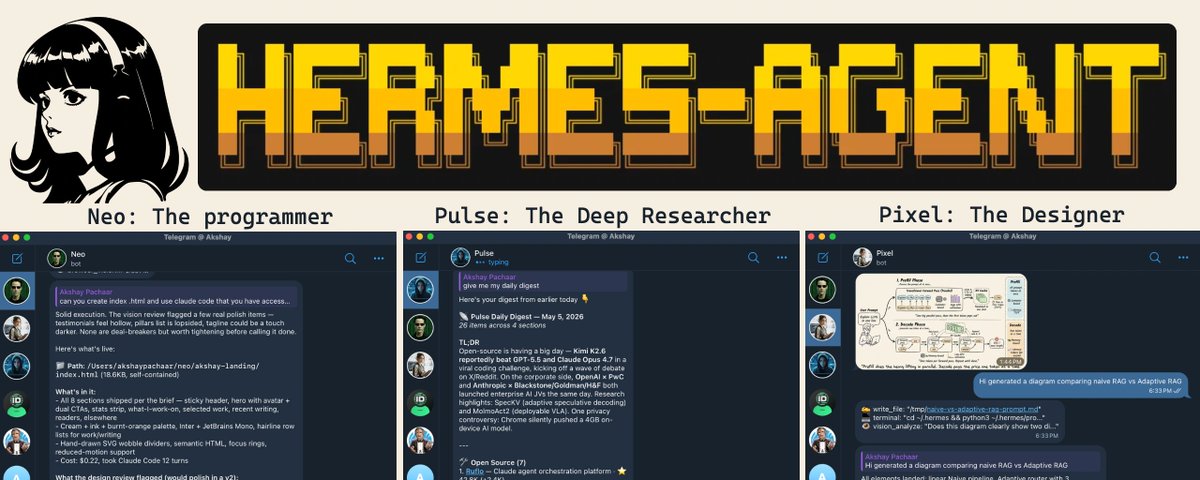
Hermes Agent 进阶指南:从架构原理到构建自进化的多智能体系统

本文深入介绍了 Nous Research 开源项目 Hermes Agent。文章详细解析了其独特的“学习闭环”架构,该架构结合了三层持久化内存、自进化技能系统以及 GEPA 优化引擎,解决了传统 Agent 随会话结束而遗忘的问题。文中还将 Hermes 与 OpenClaw 进行了对比,并提供了从零开始配置多个个性化 Agent(程序员、研究员、设计师)的实战教程,旨在帮助开发者打造能够 24/7 运行且持续学习的个人 AI 队伍。

技术 › Hermes Akshay 2026-05-2856.5 KB 5.8M 6.5K 88

Hermes Agent Masterclass:架构详解与实战指南

本文是 Hermes Agent 的深度教程。Hermes 是一个能够在使用中不断自我进化的 AI Agent,与 OpenClaw 等其他 Agent 不同,它具备跨会话记忆、自编写/修剪技能以及通过 GEPA 引擎进行离线验证的独特能力。文章详细剖析了其包含 SOUL.md 身份层在内的三层记忆系统,并指导读者如何从零配置运行多个具备独立个性的 Agent。

技术 › Hermes Akshay 2026-05-1456.4 KB 88

探索 GEPA:基于反思的 LLM 上下文提示优化技术

本文探讨了 GEPA (Genetic-Pareto) 技术,一种旨在解决大语言模型上下文管理被动性的提示词优化器。与运行时的 RLM 不同,GEPA 在推理前操作,通过自然语言反馈和试错学习来改进提示词。文章分析了 GEPA 如何利用 Pareto 前沿保持提示多样性,避免单一最优解,并在多项任务中以更少的 rollout 取得优于 GRPO 和 MIPROv2 的性能。作者提出 GEPA 与 RLM 相结合,代表了从单纯增加上下文长度向主动选择和管理上下文的技术范式转变。

技术 › Agent Quarq 2026-04-2814.3 KB 46.2K 258 70