Wiki 知识库

全部文档 / 标签: LLM Judge

4 篇
清除

Does Your AI Agent Actually Work? A Guide to Eval-Driven Development

本文介绍 AI Agent 的评估驱动开发(Eval-Driven Development)。作者指出 vibe coding 可以快速构建应用,但仅靠手工测试提示词无法保证 Agent 质量上线。文章解释了评估的核心概念:eval 是应用于 trace 的评分器,包括 Case、Run 等基本构件,并详述四种评分方式——确定性检查、参考答案评分、规则评分和轨迹评分。文章还区分线上评估(监控生产环境真实流量)与线下评估(发布前测试),强调两者缺一不可,并通过 promotion 机制将生产问题转化为测试用例,形成持续改进闭环。
技术 › LLM Alex Lieberman 2026-10-0615.7 KB 108.8K 386 84

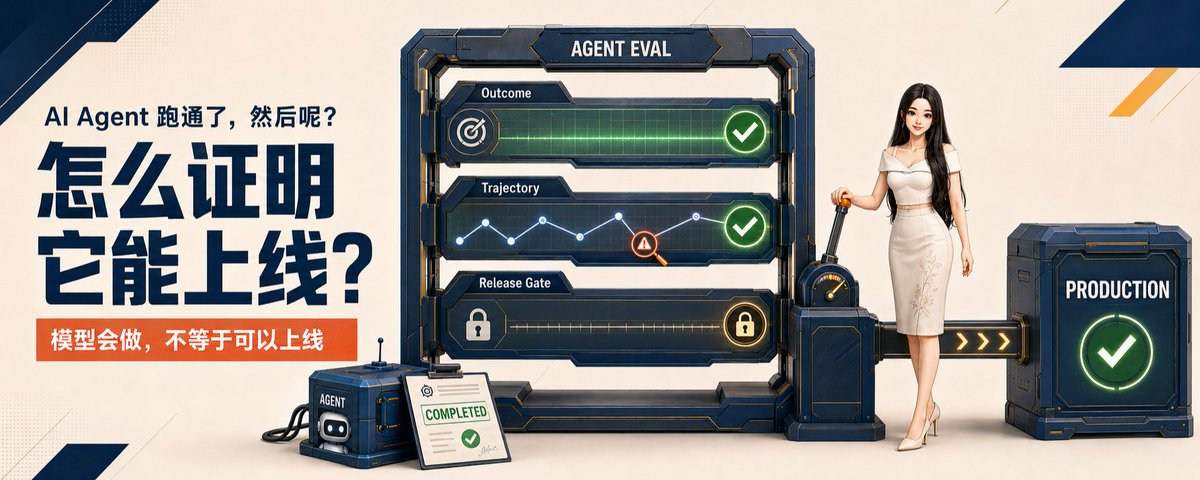
AI Agent 跑通了,怎么证明它真的可以上线?

文章指出 Agent 最危险的失败不是报错,而是做错了却显示"已完成"。作者以一个资料研究 Agent 为例,搭建了一套最小可用的 Agent 评测框架,回答三个问题:任务有没有做成、失败发生在哪里、新版本能否发布。核心方法包括:先明确评测要回答的发布决策;把"做完"写成可检查的完成条件和 Hard Failure;建立 30 条起步的分层评测数据集(dev/holdout/regression/challenge);将 Outcome 与 Trajectory 分开评估;采用 Rules + LLM Judge + Human 三层打分体系。最终通过重复运行对比 v1/v2、设置发布门禁、把线上失败送回评测集,形成完整评测闭环。

技术 › Agent Cloris 🌱 2026-09-0426.4 KB 319.9K 512 85

用 WikiBench 评估 OpenWiki

LangChain 开源了代码库文档生成与维护的 agent——OpenWiki,并构建了 WikiBench 来回答两个问题:wiki 是否真正帮助编码 agent?对 OpenWiki 的改动是否让它变得更好?WikiBench 基于 Harbor 框架运行,环境为固定 commit 的仓库,agent 生成 wiki,verifier 通过 reader agent 回答覆盖类和检索类问题,并用多个 LLM judge 基于事实 rubric 打分。实验显示:不同 harness 和模型在性能、成本和时间上差异显著;wiki 与源码结合使用效果最佳,wiki 更像索引而非替代品,可让 agent 回答更准确且成本更低。

技术 › Agent LangChain 2026-08-276.8 KB 38.1K 55 73

The science of benchmarking: from Zero to Hero [Part I]

本文是基准测试科学系列第一部分,从第一性原理讲解LLM评测:为什么评测(为无法直接观测的能力提供决策证据)、评测什么(任务、数据与用户环境的代表性)、如何评测(指标、采样与统计)。作者将基准视为测量仪器而非问题集合,拆解了任务、数据集、评分器等核心组件,并强调分数不等于能力本身,声明离直接观测越远所需假设越多。后续部分将讨论基准失效、数据污染与榜单刷分等议题。

技术 › LLM giovanni 2026-08-1428.0 KB 66