Wiki 知识库

全部文档 / 标签: 模型训练

23 篇
清除

Google Labs 负责人谈实验与产品判断,常驻在线智能体的工作原理,Alexandr Wang 谈 Muse 的信任与团队

本期早报汇集三篇精讲:Google Labs 负责人 Josh Woodward 分享如何像实验室一样运作团队,通过机会清单、快速原型与用户信号判断产品方向;斯坦福 CS146S 课程拆解常驻在线智能体的架构,涵盖主循环与执行环境分离、持久工作流、事件队列优先级与上下文分层管理;Alexandr Wang 回顾 Meta Muse 个人智能体的产品历程,强调把愿景拆成可评测行为、通过小任务积累用户信任,以及为研究人才设定方向与空间。另有 PayPal CLI 智能体实战、MiniMax M3 稀疏注意力架构、低成本金融智能体训练等七篇实践速览。

技术 › Agent ginobefun 2026-10-1231.2 KB 4.3K 2 81

一篇文章带你祛魅算法工程师!

大厂在职算法工程师云辰 Cyan 撰文揭秘算法工程师职业真相。文章介绍了算法工程师的高薪现状:硕士校招 40-100 万,顶尖博士可超 150 万;并将岗位分为算法应用、模型推理、模型训练三个层级,指出 95% 的算法工程师从事的是'AI 赋能'类应用工作,门槛较低;而模型推理和基模训练则有较高技术壁垒。作者还提到当前校招竞争激烈(985 硕士+顶会论文+大厂实习已成标配),AI 人才供需失衡导致薪资倒挂,企业普遍存在 FOMO 心态。文章以幽默笔调对算法工程师这一职业进行了祛魅。

职场 › 职业发展 云 云辰 Cyan 2026-09-275.0 KB 58.8K 43 62

Agent traces are the new oil(Agent 轨迹是新石油)

文章提出 Agent 轨迹(traces)正成为 AI 公司间的核心交易资产,甚至出现蒸馏攻击等争夺行为。作者指出 RL 训练、长程任务代理普及使 traces 价值激增,但多数企业仍未善用这一资产。文章分析了 traces 对数据厂商、前沿实验室和应用层的价值,以及在运营优化、安全护栏、持续改进三方面的用途。作者还剖析了从 traces 中提取价值的难点:数据非结构化、体量巨大、反馈混乱、长程信用分配困难等,并类比 2010 年代的大数据浪潮,认为 traces 将成为企业专有智能层和战略资产,唯有通过提炼与使用才能释放价值。

技术 › Agent Sam Z Liu 2026-09-268.9 KB 164.1K 405 69

Lies, Damned Lies, and Benchmarks

文章批判当前 AI 基准测试被过度优化的现象(benchmaxxing)。作者指出,当公共评测与巨额关注和资金挂钩时,实验室会通过训练相似数据、筛选上百个实验设置等方式变相刷分,基准测试随之失去了衡量通用智能的意义。文中列举了 Meta Llama 4 在 LMArena 测试多个私有变体、评测机构随舆论反复修改指数、厂商选择性引用榜单等案例,并指出 MMLU、GPQA 等基准早已失真。作者呼吁实验室诚实披露数据缺陷、用户自行做私有评测,并宣布 TypeSafe 将不在模型发布中提供标准基准表,以追求最大程度的诚实。

技术 › LLM Diogo Almeida 2026-09-139.4 KB 41.1K 195 75

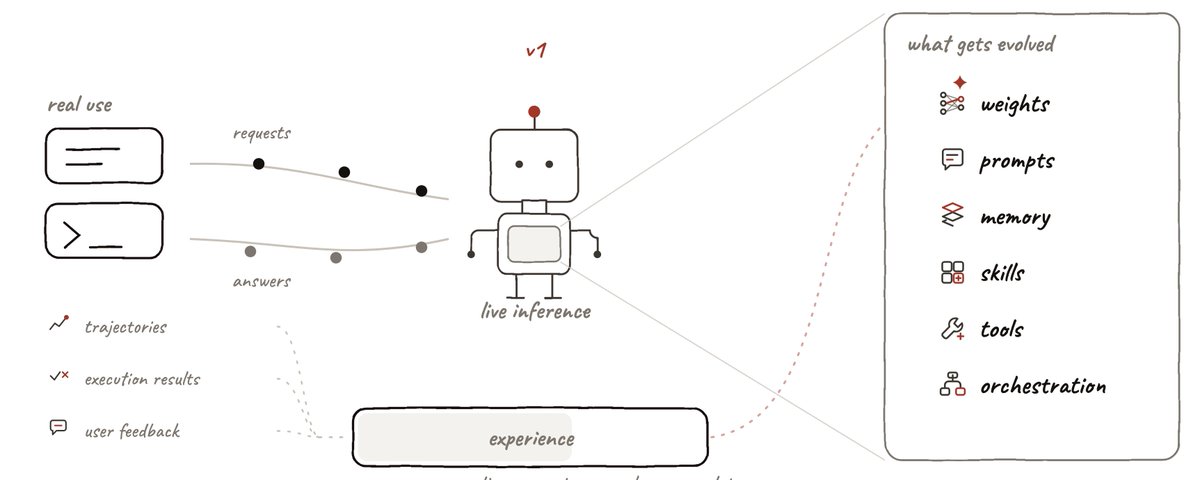
Your Inference Server is Secretly a Learner: Open-Sourcing Reef for Continual Self-Improving Agents

作者开源了Reef,一个支持持续自我改进的AI Agent基础设施。文章指出传统LLM基础设施假设固定的训练-部署-推理流程,而对持续自我进化的Agent而言,推理不再只是终点,而是学习过程的一部分;且进化的不仅是模型权重,还包括提示词、记忆、技能、工具和编排逻辑(harness)。Reef以有状态推理为核心,从实时流量中收集经验和反馈,支持模型与harness的联合进化,并提供评估、版本控制和热更新等发布机制,让开源社区能便捷地实验持续自我改进(RSI)。

技术 › Agent Ao Qu 2026-09-0215.6 KB 180.7K 274 81

飞书、TRAE、扣子全收编!豆包为啥在今年“大一统”了?

字节在一个月内将飞书、TRAE、扣子并入豆包体系,推出“豆包工作”,阿里、腾讯也在整合Agent产品线。文章分析这一趋势背后的逻辑:入口即训练场,真实任务轨迹决定模型升级;豆包缺企业“写回”钥匙,飞书恰好握有账号、权限和组织架构;随着Agentic AI价值流向模型厂商,收拢入口意味着同时获得流量、数据和模型升级三重优势。

技术 › Agent 林亦LYi 2026-08-2510.8 KB 4K 8 70

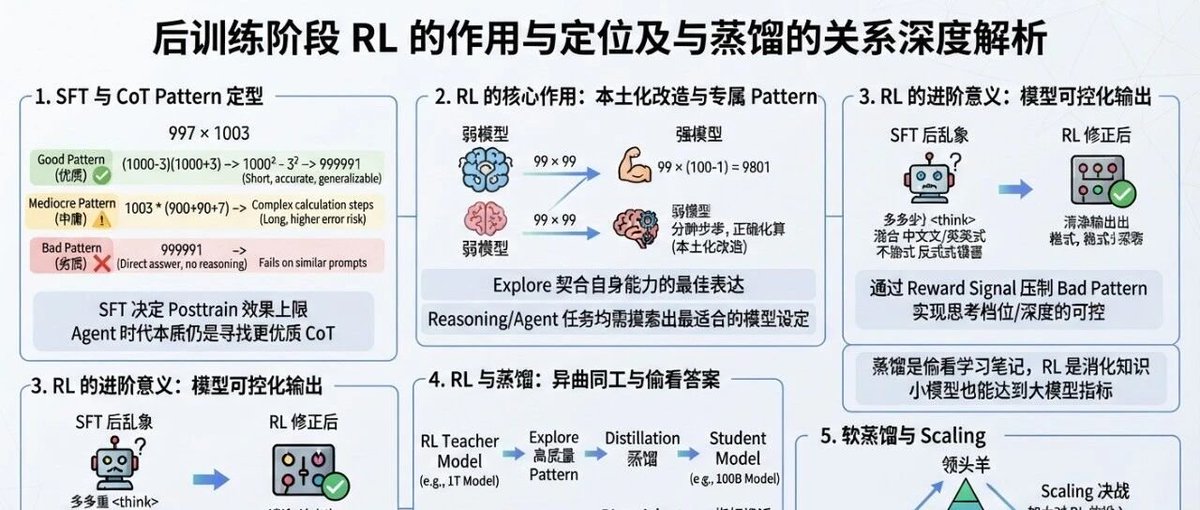
从 RL 到蒸馏,再到软蒸馏:Why RL Matters?

本文探讨了强化学习(RL)在大语言模型后训练阶段的作用,以及它与蒸馏(SFT)的关系。作者认为,SFT 阶段为模型提供了思维链(CoT)模式,而 RL 则帮助模型将这些模式“本土化”,找到最适合自身知识量和分词器的表达方式,并增强模型的可控性。同时,蒸馏(包括软蒸馏)可以高效地将强模型的能力迁移到弱模型,但过度依赖蒸馏会限制模型的进步。文章最后指出,领先团队应加大 RL 投入,而应用型团队则可优先选择蒸馏。

技术 › LLM ybq 2026-08-1611.6 KB 5.2K 43 73

BestBlogs 早报|模型开发未来与组织管理反思

本期早报涵盖了 Igor Babuschkin 对模型开发未来路线的判断,Whatnot 对产品经理配置的反思,以及姚顺雨入主腾讯混元后的组织调整。此外,还速览了 AWS 的 Agent 开发流程、英伟达机器人研究、AI 基准评测及微软 Meta 财报等内容,探讨了技术落地与组织设计的相互影响。

技术 › LLM ginobefun 2026-08-0327.3 KB 5.1K 2

如何教授 AI 模型

文章通过人类学习的类比,通俗易懂地解释了 AI 模型如何学习新技能和行为。它涵盖了从预训练、监督微调到强化学习的三个阶段,以及通过基准测试评估模型和通过模型规范对齐模型行为的重要性,最后指出了当前模型在持续学习方面的局限性。

技术 › LLM Lee Robinson 2026-07-248.2 KB 218.8K 2K

构建递归智能体系统:扩展 Composer 训练规模

本文介绍了 Cursor 如何构建一个包含数千个 Agent 的递归系统,以加速 Composer 模型的训练。系统通过主 Agent 管理子 Agent 的“健康”状态,实现并行实验的自动化监控与故障修复。该架构将研究员的效能提升了数量级,使大量计算资源能像企业组织一样协同工作。

技术 › Agent Lee Robinson 2026-06-143.7 KB 354.6K 2.2K

Step-By-Step LLM Engineering Projects (2026 Edition)

文章提出了一个基于项目的 2026 年 LLM 工程学习路线图。作者主张通过从零构建系统来掌握技术栈,路径涵盖从基础的 Tokenizer、Embedding、Positional Encoding、Attention 机制,到 Transformer 模块构建、训练循环、KV Cache、MoE、量化、服务部署、RAG 及 Agent 等高级系统。该指南强调“实现、绘制、破坏、解释”的学习闭环,旨在帮助读者深入理解大模型原理并具备工程构建能力。

技术 › LLM Ahmad 2026-05-2547.2 KB 492.6K 1.4K 83

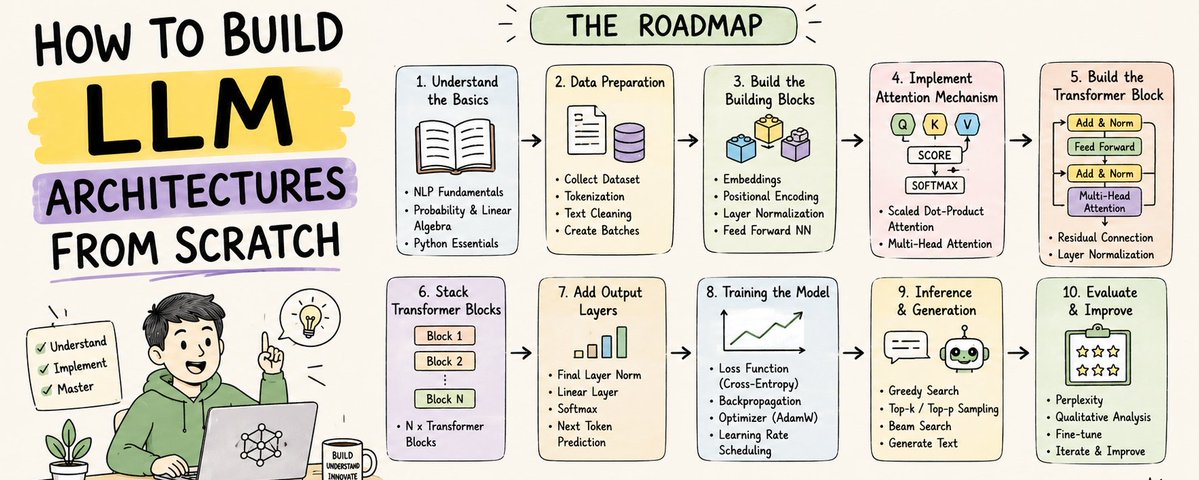
How to Build LLM Architectures From Scratch

本文是一篇关于从零构建大型语言模型(LLM)架构的深度指南。文章详细解释了 LLM 的工作原理,包括从原始数据收集、清洗、分词,到 Transformer 架构的核心组件(如自注意力机制、位置编码)。同时涵盖了预训练、微调、基于人类反馈的强化学习(RLHF)以及推理优化等关键技术环节,旨在帮助读者理解 ChatGPT 和 Claude 等模型背后的系统构建全流程。

技术 › LLM Shabnam Parveen 2026-05-2510.4 KB 58.2K 101 49

BestBlogs 早报:AI 编码的工程化深水区

本期早报探讨了 AI 编码从「工具替换」走向「工程化」的范式转变。Cursor 发布 Composer 2.5 并公开训练栈,标志着竞争从应用层下沉到模型层;Anthropic 工程师详解长时 Agent 架构,利用对抗式生成-评估循环将续航提升至 12 小时;阿里云 CIO 则提出应摒弃「AI 生码率」,关注端到端业务价值,指出代码即是负债。文章强调,模型能力、Agent 架构与组织效能三者结合,才能实现从写得快到做得对的跨越。

技术 › DevOps ginobefun 2026-05-1930.8 KB 771 1 88

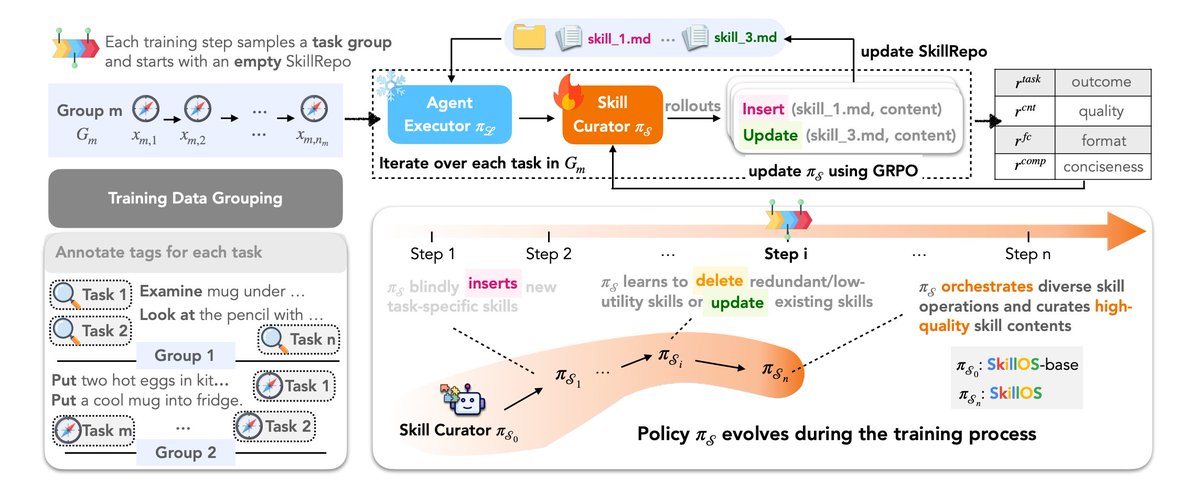
SkillOS 详解:自进化 Agent 的技能策展机制

文章详细解读了 Google 关于 SkillOS 的最新论文。SkillOS 是一个帮助 LLM Agent 通过管理可复用“技能”来实现自我进化的框架。该框架包含一个冻结的 Agent Executor 和一个可训练的 Skill Curator,后者利用强化学习(RL)从执行轨迹中自动提取、更新或删除技能,从而实现从经验到技能的转化。

技术 › Agent AVB 2026-05-1215.3 KB 51.5K 505 79

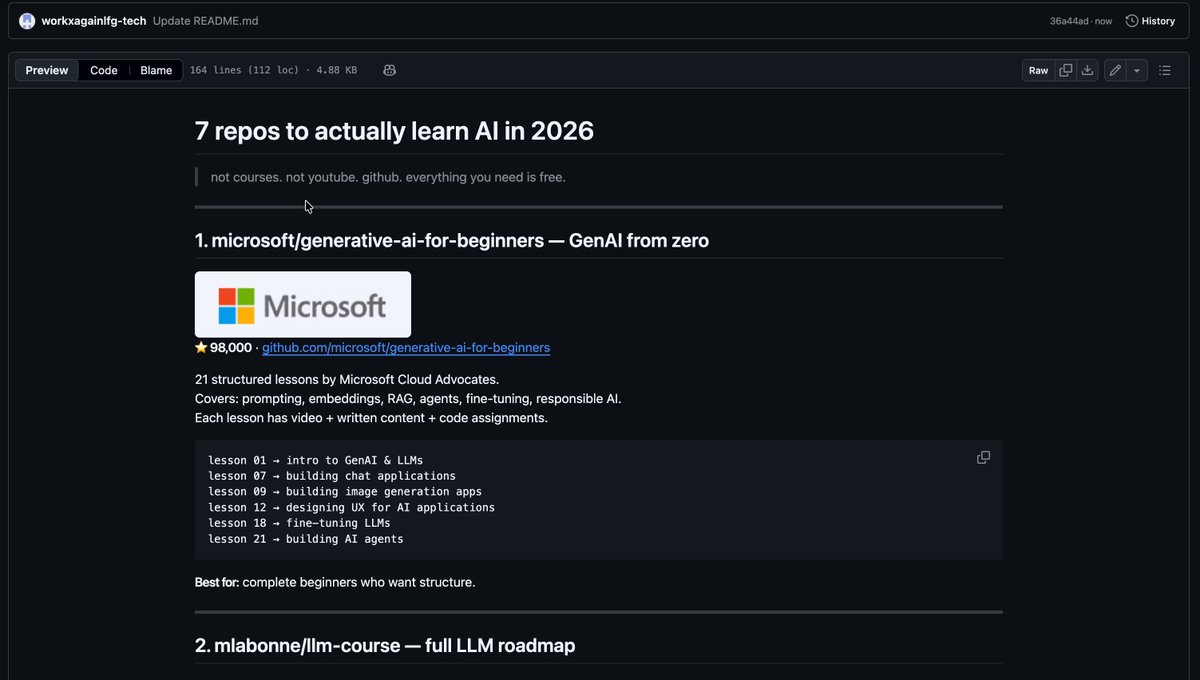
2026年真正学习AI的7个开源仓库

这是一份2026年AI学习资源清单,包含7个精选的GitHub开源仓库。内容覆盖从初学者指南到高级LLM路线图,包括微软的GenAI课程、从零构建ChatGPT的PyTorch教程、Karpathy的nanoGPT训练、OpenAI与Anthropic的实战Cookbook以及AI Agents构建指南。所有资源均免费,旨在帮助学习者掌握Prompt、RAG、微调及Agent等核心技术。

技术 › LLM self.dll 2026-05-062.1 KB 75

Model-Harness-Fit: 模型与协作框架的深度适配

本文深入探讨了“Model-Harness-Fit”(模型与协作框架的适配)这一概念。作者通过对比 Codex、Claude Code 和 GitHub Copilot SDK,指出模型在训练后与特定的工具界面、内存协议和规划机制深度绑定。仅更换模型而保留通用框架会导致性能显著下降。文章强调,模型本身的权重不再是唯一的护城河,与其配套的整个工程堆栈才是关键。

技术 › Harness Engineering Nicolas Bustamante 2026-05-04106.9 KB 39.6K 241 81

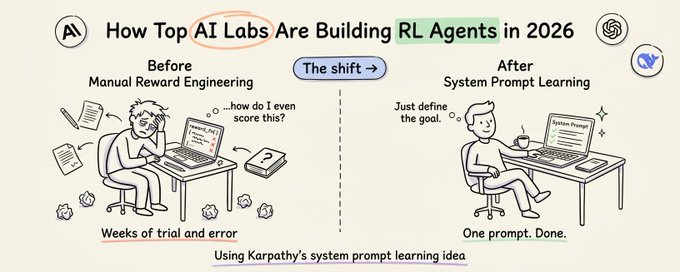
顶级AI实验室如何构建RL智能体:从RLHF到RULER的演进

文章探讨了 Anthropic、OpenAI 和 DeepSeek 等顶尖 AI 实验室在 2026 年关于强化学习(RL)的趋同思路,即使用系统提示作为奖励函数。内容详细梳理了 RL 在 LLM 中的应用历程,从 RLHF 到 RULER(Karpathy 提出的系统提示学习概念)的演变。重点介绍了 DeepSeek R1 利用可验证奖励(RLVR)突破传统瓶颈的机制,通过规则编译器直接提供信号,并结合 GRPO 算法移除了复杂的 Critic 和奖励模型,实现了从 15.6% 到 77.9% 的 AIME 数学成绩飞跃。

技术 › LLM Avi Chawla 2026-04-2863.5 KB 857.5K 502 74

900万参数,130行代码:从零构建微型语言模型 GuppyLM 教程

本文介绍了开发者 arman-bd 开源的微型语言模型 GuppyLM。该模型拥有 900 万参数,核心代码仅 130 行,可在免费 Colab 上 5 分钟训练完成。文章详细拆解了构建流程:利用模板生成 6 万条合成数据、训练 4096 词表的 BPE 分词器、搭建 6 层 Vanilla Transformer 架构以及优化推理环节。该项目旨在通过极简的实现,帮助开发者深入理解语言模型的数据工程、架构设计与训练循环。

技术 › LLM Jason Zhu 2026-04-077.5 KB 8.5K 74 92

100 小时深入基米:揭秘 Moonshot AI 的极客文化与生存法则

本文通过100小时的内部观察,深入剖析了Moonshot AI(Kimi)独特的企业文化与生存状态。文章记录了公司如何在DeepSeek崛起的压力下调整战略,强调了“模型能力”至上的原则。作者揭示了该公司偏爱具有“概括能力”和“品味”的天才型员工,实行无KPI、无层级的扁平化管理,并详细描述了年轻员工在高强度跨领域工作中的成长与焦虑。这不仅是一家初创公司的生存侧写,也是对AI时代人才组织模式的深刻探讨。

技术 › LLM Rui Ma 2026-04-0138.1 KB 60