Wiki 知识库

全部文档 / 标签: Ling-3.1-flash

5 篇
清除

L 站注册教程:不写小作文,查年限、领邀请

作者介绍了中推 AI 社区 Linux DO(L 站)的最新注册方法:GitHub 账号满 5 年即可申请邀请,无需再写申请小作文。作者用 AI 开发了一个查询工具,输入 GitHub 用户名即可检查年限并直达官方申请入口。文章给出极简三步注册流程及注意事项(链接 30 分钟有效、须用绑定邮箱、免费申请谨防卖码)。同时分享了工具的开发过程:作者在 Pi 中接入蚂蚁百灵 Ling-3.1-flash 模型,零代码完成开发,该模型在资料读取、浏览器自验证和排错方面表现出色。文末附模型免费体验入口与 Pi 配置教程。

技术 › 工具与效率 Lonely 2026-10-1113.1 KB 174.4K 294 77

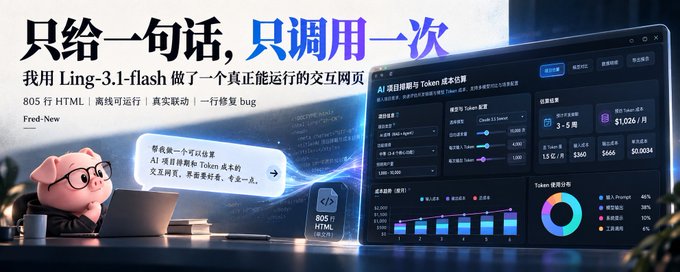
只给一句话、只调用一次:我用 Ling-3.1-flash 做了一个真正能运行的交互网页

作者以“只提一次需求、只调用一次模型”的严格规则测试 Ling-3.1-flash,仅给出一句模糊需求——“做一个可直接交付的 AI 项目工期与 Token 成本估算器交互网页”。模型先自主拆解任务、补全产品逻辑,一次生成 805 行、41KB 的零依赖单文件 HTML,包含参数联动计算、成本图表、甘特图、场景预设与数据导出等功能。作者验证发现一处 undefined 变量 bug,手工修改一行代码修复。作者认为 AI Coding 的价值正从“补代码”转向“交付完整版本”,但生成结果仍需人工验收与修正。

技术 › LLM Fred-New 2026-10-0815.8 KB 37K 18 76

12G显存部署125B Qwen3.8-Flash-Next 全攻略

本文介绍如何在12GB显存上部署125B参数的Qwen3.8-Flash-Next模型。核心是Strata技术让GPU、CPU、RAM和SSD协同工作:常用专家留GPU,其余放RAM,CPU处理cache miss。RTX 5070 12GB + 64GB RAM在Q2_0量化下短对话可达94 tok/s。文章还讲解了量化选择策略——显存占用相同时速度可差1.72倍,关键在于专家命中率。作者全程使用蚂蚁的Ling-3.1-flash Agent自动完成从检查机器、选权重、下载安装到排错验收的完整部署流程,跑通了一套用Agent自动部署本地模型的可复用方法。

技术 › LLM 实践哥 Li 2026-10-087.4 KB 79

现在用AI大模型做科普类3D动效视频太方便了!

文章介绍了一种用AI大模型制作科普3D动效视频的新方法。作者引用Karpathy的观点:让LLM生成结构化、可交互内容比纯文字更易理解。作者测试了蚂蚁最新发布的Ling-3.1-flash模型,仅输入一句'做一个简易双齿轮传动科教演示3D原型'的提示词,模型约3分钟便生成了包含交互功能的Three.js单文件应用,支持鼠标拖拽和缩放查看,可直接录屏加工为科普视频素材。作者也指出这类输出属于演示原型,复杂场景仍需工程师调优。文末提供了官网、蚂蚁数科、Vercel、OpenRouter等四个体验渠道。

技术 › LLM 马识途 2026-10-066.0 KB 8.6K 67 71

GPT Image 2.5 最强“焚诀”直接拿去用,保姆级拆解教程

作者分享了一套 GPT Image 2.5 出图的结构化提示词方法论,将画面拆解为身份、物理、摄影、视觉风格四大系统加负面词控制系统,共 17 个层级,并提供 5 层、8 层、15 层三个版本。通过“雨夜便利店”同场景实测对比,展示信息量对出图质量的影响。作者还用蚂蚁百灵 Ling-3.1-flash 模型将 5000 字方法论文档在 24 秒内一次性生成单文件 HTML 提示词拼装工具,支持逐层填写、实时拼接、一键复制,并介绍了将该模型接入本地 Claude Code 的环境变量配置方法与使用体验。

技术 › 工具与效率 王大锤 2026-10-0311.4 KB 84.5K 491 81